




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
图像识别入门练习:标注转换与数据集整理
时间:2026-09-20 13:34:01 编辑:袖梨 来源:一聚教程网
图像识别模型能否顺利训练,往往先取决于标注格式和数据集划分是否可靠。面对 LabelMe 导出的 JSON 文件,需要正确换算矩形框坐标、处理缺失图片和无效标注,还要避免同一图片的数据落入不同集合。下面从格式转换与训练验证集整理两个环节入手,梳理一套可复现的 Python 实现。
自动化实现LabelMe JSON转YOLO txt 格式
# labelme_to_yolo.py —— LabelMe JSON → YOLO txt(含图片归集、配对检查、日志)
import json, shutil
from pathlib import Path
from collections import Counter

# ==========================================
# 1. 路径与类别配置
# ==========================================
# 原始数据目录:存放 LabelMe 导出的 .json 标注文件和对应的 .jpg/.png 图片
SRC = Path(r"/hy-tmp/cv_data/images")
# YOLO 输出目录:归集后的图片文件夹
OUT_IMG = Path(r"/hy-tmp/cv_data/yolo/images")
# YOLO 输出目录:转换后的 .txt 标签文件夹
OUT_LBL = Path(r"/hy-tmp/cv_data/yolo/labels")

# 自动创建输出目录(parents=True 递归创建,exist_ok=True 已存在不报错)
OUT_IMG.mkdir(parents=True, exist_ok=True)
OUT_LBL.mkdir(parents=True, exist_ok=True)

# 类别列表(顺序固定!索引即 YOLO 标签中的 class_id)
CLASSES = ["person", "operatingbar", "grove", "wrongglove", "badge"]
# 构建 类别名 -> ID 的映射字典,方便后续快速查表
cls2id = {c: i for i, c in enumerate(CLASSES)}

# 支持匹配的图片后缀(覆盖大小写差异)
IMG_EXT = [".jpg", ".JPG", ".jpeg", ".JPEG", ".png", ".PNG"]
# 统计计数器:记录各类别数量及处理的图片总数
stat, skipped = Counter(), []

# ==========================================
# 2. 遍历并转换标注文件
# ==========================================
# 按文件名排序遍历源目录下的所有 JSON 文件
for jp in sorted(SRC.glob("*.json")):
    # 解析 JSON 标注数据
    data = json.loads(jp.read_text(encoding="utf-8"))
    # 获取原图的宽高,用于后续坐标归一化
    W, H = data["imageWidth"], data["imageHeight"]

    # --- 步骤 1:寻找同名图片 ---
    # 忽略后缀大小写差异,尝试匹配对应的图片文件
    img_path = next((SRC / f"{jp.stem}{e}" for e in IMG_EXT if (SRC / f"{jp.stem}{e}").exists()), None)
    if img_path is None:
        # 若找不到对应图片,记录跳过原因并处理下一个文件
        skipped.append((jp.name, "缺少对应图片")); continue

    # --- 步骤 2:逐框转换坐标格式 ---
    lines = []
    for s in data["shapes"]:
        # 仅处理矩形框(rectangle),跳过 polygon 等其他形状
        if s["shape_type"] != "rectangle":
            continue

        label = s["label"].strip()
        # 检查类别是否在预设列表中,未登记的类别直接跳过
        if label not in cls2id:
            skipped.append((jp.name, f"未登记类别 {label}")); continue

        # 提取矩形的左上角 (x1, y1) 和右下角 (x2, y2) 坐标
        (x1, y1), (x2, y2) = s["points"]
        # 关键:强制排序,防止标注时手滑导致 x1 > x2 或 y1 > y2
        x1, x2 = sorted((float(x1), float(x2)))
        y1, y2 = sorted((float(y1), float(y2)))

        # 边界裁剪:确保坐标不超出图片范围 [0, W] 和 [0, H]
        x1, x2 = max(0.0, min(x1, W)), max(0.0, min(x2, W))
        y1, y2 = max(0.0, min(y1, H)), max(0.0, min(y2, H))

        # 过滤退化框:宽或高小于 1 像素的无效框直接丢弃
        if x2 - x1 < 1 or y2 - y1 < 1:
            skipped.append((jp.name, "退化框(宽或高<1px)")); continue

        # 核心转换:LabelMe (x1,y1,x2,y2) -> YOLO (class_id, cx, cy, bw, bh)
        # cx, cy: 归一化后的中心点坐标 (0~1)
        # bw, bh: 归一化后的框宽和框高 (0~1)
        cx, cy = (x1 + x2) / 2 / W, (y1 + y2) / 2 / H
        bw, bh = (x2 - x1) / W, (y2 - y1) / H

        # 格式化为一行 YOLO 标签字符串,保留 6 位小数以保证精度
        lines.append(f"{cls2id[label]} {cx:.6f} {cy:.6f} {bw:.6f} {bh:.6f}")
        # 更新类别统计计数
        stat[label] += 1

    # --- 步骤 3:落盘保存 ---
    # 复制图片到输出目录,并统一将后缀转为小写(方便后续训练脚本读取)
    shutil.copy2(img_path, OUT_IMG / f"{jp.stem}{img_path.suffix.lower()}")
    # 将转换好的多行标签写入同名 .txt 文件
    (OUT_LBL / f"{jp.stem}.txt").write_text("n".join(lines), encoding="utf-8")
    # 更新图片处理总数统计
    stat["图片"] += 1

# ==========================================
# 3. 打印日志与生成类别文件
# ==========================================
print("完成。统计:", dict(stat))
print("跳过明细:", skipped)
# 打印最终的类别索引映射,方便核对
for i, c in enumerate(CLASSES):
    print(f"  {i}: {c}")

# 生成 classes.txt 文件(YOLOv8/v11 等新版训练时通常需要此文件来映射 class_id -> 类别名)
Path(r"/hy-tmp/cv_data/yolo/classes.txt").write_text("n".join(CLASSES), encoding="utf-8")
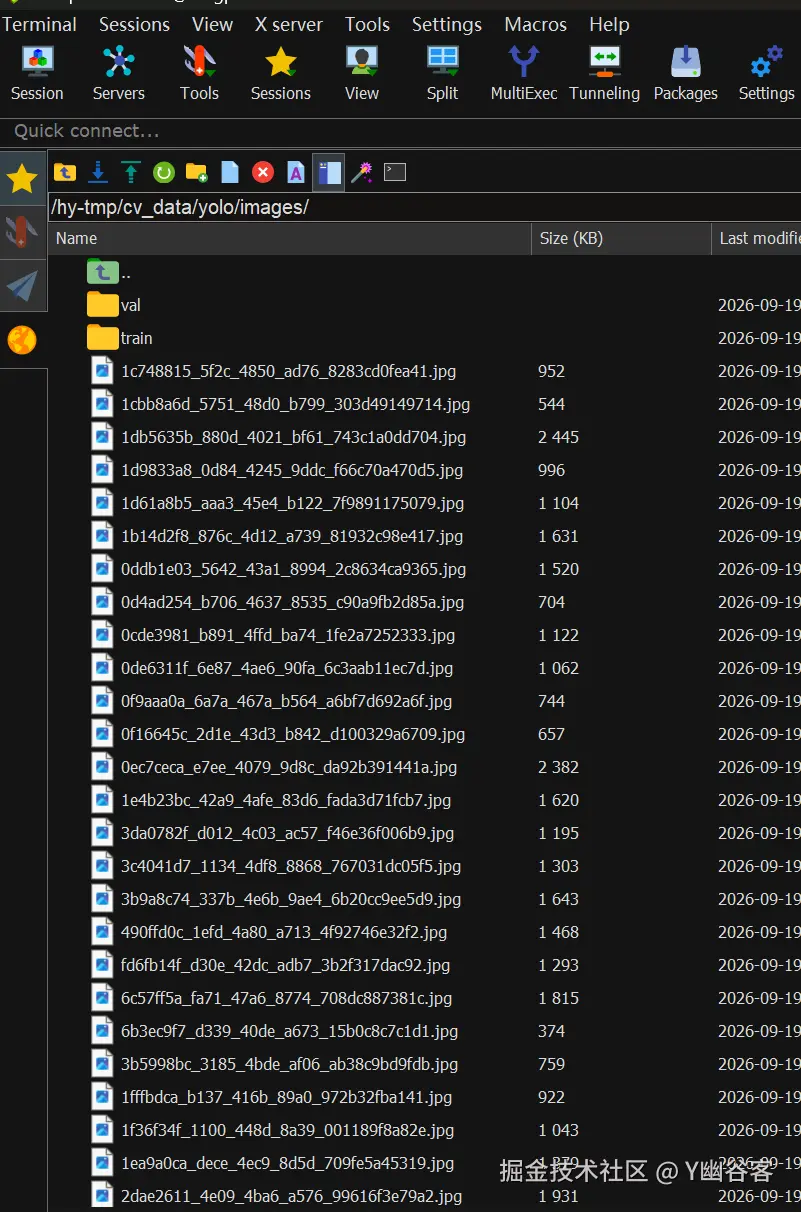
训练集 / 验证集划分
划分原则
- 图片级划分:同一张图的所有框必须落在同一集合,绝不能按框随机分(会造成严重泄漏)。
- 固定随机种子:保证可复现(
seed=42)。 - 验证集要有代表性:小类别(badge 8 框、wrongglove 12 框)在验证集里至少出现 1~2 次,否则该类 mAP 直接是 0 或 NaN。
- 场景不串场:同一工位/同一时段的连拍图尽量整体进同一集合。
- 比例:本数据集 59 张,8:2 ≈ 47 / 12;数据量 < 100 张时建议交叉验证(见 4.3)。
import random, shutil, json
from pathlib import Path
from collections import Counter

# ==========================================
# 1. 基础配置
# ==========================================
# 数据集根目录(存放 images 和 labels 文件夹)
ROOT = Path(r"/hy-tmp/cv_data/yolo")

# 类别列表(顺序必须与训练时的 names 映射保持一致)
CLASSES = ["person", "operatingbar", "grove", "wrongglove", "badge"]

VAL_RATIO = 0.2   # 验证集划分比例:20%
SEED = 42         # 随机种子:固定后每次运行划分结果一致,保证实验可复现
random.seed(SEED)

# ==========================================
# 2. 获取样本列表并打乱
# ==========================================
# 读取 labels 目录下所有 .txt 文件的文件名(不带后缀)
stems = sorted(p.stem for p in (ROOT / "labels").glob("*.txt"))

# 随机打乱文件顺序
random.shuffle(stems)

# 按比例计算验证集数量(至少保留 1 张,防止数据集过小时验证集为空)
n_val = max(1, round(len(stems) * VAL_RATIO))

# 切分:前 n_val 个作为验证集,剩余作为训练集,转为 set 方便后续遍历
val_set = set(stems[:n_val])
train_set = set(stems[n_val:])

# ==========================================
# 3. 辅助函数:统计单张图片的类别分布
# ==========================================
def cls_of(stem):
    """
    读取指定样本的 .txt 标签文件,统计其中包含的各类别标注框数量
    返回格式示例:Counter({'person': 2, 'badge': 1})
    """
    c = Counter()
    txt_path = ROOT / "labels" / f"{stem}.txt"
    if txt_path.exists():
        for line in txt_path.read_text().splitlines():
            if line.strip():  # 跳过空行
                class_id = int(line.split()[0])  # 取每行第一个数字,即类别 ID
                c[CLASSES[class_id]] += 1        # 通过 ID 映射回类别名称并计数
    return c

# ==========================================
# 4. 创建标准 YOLO 目录结构
# ==========================================
# 自动创建 images/train、images/val、labels/train、labels/val 四个子文件夹
for sub in ("images/train", "images/val", "labels/train", "labels/val"):
    (ROOT / sub).mkdir(parents=True, exist_ok=True)

# ==========================================
# 5. 执行文件复制与类别统计
# ==========================================
split_stat = {}  # 用于记录训练集和验证集的类别分布统计结果

for name, group in (("train", train_set), ("val", val_set)):
    class_counter = Counter()  # 当前分组的类别计数器

    for s in group:
        # 在 images 目录下查找与标签同名的图片(自动兼容 .jpg/.png/.JPG 等任意后缀)
        img = next((ROOT / "images").glob(f"{s}.*"))

        # 复制图片到对应的分组目录(如 images/train/xxx.jpg)
        shutil.copy2(img, ROOT / "images" / name / img.name)
        # 复制标签到对应的分组目录(如 labels/train/xxx.txt)
        shutil.copy2(ROOT / "labels" / f"{s}.txt", ROOT / "labels" / name / f"{s}.txt")

        # 统计该图片包含的类别,累加到分组计数器中
        class_counter.update(cls_of(s))

    # 保存当前分组的统计结果
    split_stat[name] = dict(class_counter)
    # 打印日志:图片数量、标注框总数、各类别分布
    print(f"[{name}] 图片 {len(group)} 张,框数 {sum(class_counter.values())},类别分布 {dict(class_counter)}")

# ==========================================
# 6. 安全检查:验证集小类别告警
# ==========================================
# 遍历所有预设类别,检查验证集中是否包含该类别的样本
for cls in CLASSES:
    # 如果验证集中某类别数量为 0,会导致训练时该类别的 mAP 无法计算
    if split_stat["val"].get(cls, 0) == 0:
        print(f"!! 警告:验证集中没有 {cls},该类指标无法计算,请调整 seed 或手动指定")

# ==========================================
# 7. 保存统计结果到 JSON 文件
# ==========================================
# 将训练集和验证集的类别分布统计写入 split_stat.json,方便后续查看数据分布
json.dump(
    split_stat,
    open(ROOT / "split_stat.json", "w", encoding="utf-8"),
    ensure_ascii=False,  # 保证中文类别名正常显示,不转义为 uXXXX
    indent=2             # 格式化缩进,提升可读性
)
模型训练
按照依赖:pip install ultralytics==8.0.138 -i https://pypi.tuna.tsinghua.edu.cn/simple


跑不通改东西:
# Train/val/test sets as 1) dir: path/to/imgs, 2) file: path/to/imgs.txt, or 3) list: [path/to/imgs1, path/to/imgs2, ..]
path: /hy-tmp/cv_data/yolo # dataset root dir
train: images/train # train images (relative to 'path') 128 images
val: images/val # val images (relative to 'path') 128 images
test: # test images (optional)

# Classes
names:
  0: person
  1: operatingbar
  2: grove
  3: wrongglove
  4: badge


from ultralytics import YOLO


if __name__=="__main__":
    model = YOLO("yolov8s.pt") # nsmlx
    model.train(data ="coco128.yaml",epochs = 100,batch =16,imgsz =640,device="0")
增强版

from ultralytics import YOLO
if __name__ == "__main__":
    # 1. 选用预训练模型 (根据显存情况,yolov8s 或 yolov8m 均可)
    model = YOLO("/root/cv/yolov8n.pt")

    # 2. 高精度训练配置
    results = model.train(
        # --- 基础配置 ---
        data="/root/cv/coco128.yaml",    # 替换为你的数据配置文件 (如 data.yaml)
        epochs=100,             # 训练轮次
        batch=16,               # 批次大小 (若显存不足可降至 8)
        imgsz=800,              # ? 关键提分点 1: 将输入分辨率从 640 提升至 800 (大幅提升路牌细节识别)
        device="0",             # GPU 设备
        amp=False,  # 关闭 AMP,全程使用 FP32
        # --- 优化器与学习率配置 ---
        optimizer="AdamW",      # ? 关键提分点 2: 使用 AdamW 优化器,比默认 SGD 收敛更好
        cos_lr=True,            # ? 关键提分点 3: 开启余弦退火学习率 (Cosine Annealing)
        lr0=0.001,              # 初始学习率
        lrf=0.01,               # 最终学习率衰减比例
        weight_decay=0.0005,    # 权重衰减,防止过拟合
        warmup_epochs=3.0,      # 预热轮次,保护预训练权重

        # --- 数据增强配置 (针对路牌/小目标优化) ---
        mosaic=1.0,             # ? 关键提分点 4: 开启 Mosaic 增强,提升小目标及多目标检测
        close_mosaic=10,        # 最后 10 个 epoch 关闭 Mosaic,让模型在真实图像上平稳收敛
        mixup=0.15,             # 图层混合增强
        degrees=10.0,           # 随机旋转 (路牌微小倾斜适应)
        scale=0.5,              # 图像缩放增强
        fliplr=0.5,             # 左右翻转

        # --- 结果保存与打印 ---
        project="hy-tmp/task2_result",
        name="train_run_high_acc",
        save=True
    )

    print("? 训练完成,正在进行测试时增强 (TTA) 高精度验证...")
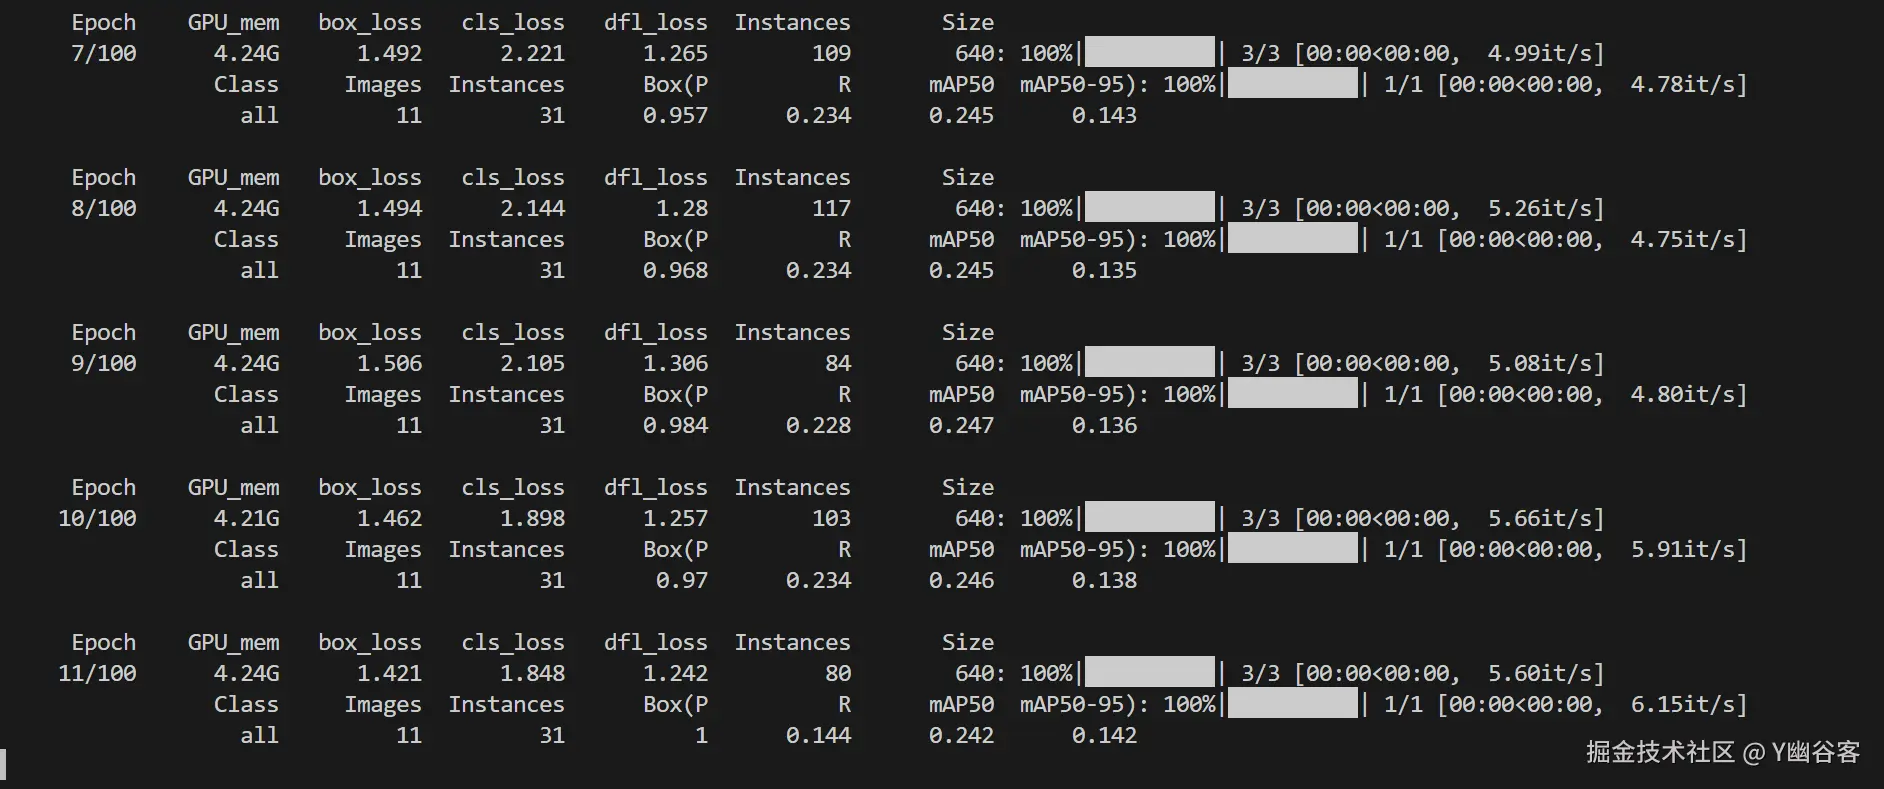
模型验证
 # 3. 评估时开启 TTA (Test-Time Augmentation)
 # ? 关键提分点 5: 验证时开启 augment=True,通常能直接带来 1%~3% 的 mAP 提升
from ultralytics import YOLO
if __name__ == "__main__":
    val_model = YOLO("/task2_result/train_run_high_acc2/weights/best.pt")
    metrics = val_model.val(
        data="/root/cv/coco128.yaml",
        imgsz=800,
        augment=True,           # 开启 TTA 推理增强
        split="val"
    )

    print(f"✅ TTA 验证完毕!mAP50: {metrics.box.map50:.4f}, mAP50-95: {metrics.box.map:.4f}")
模型测试
from ultralytics import YOLO

model = YOLO("/tmp/pycharm_project_662/runs/detect/train/weights/best.pt")

results = model.predict(
    source="yolo/images/train",   # 图片 / 目录 / 视频 / 0(摄像头)
    imgsz=640,
    conf=0.25,            # 推理阈值,可参考 F1_curve 调
    iou=0.45,             # NMS 阈值
    device=0,
    save=True,            # 保存画框后的图片

    project="runs/detect", exist_ok=True,
)
模型量化展示(三种常用做法)
from ultralytics import YOLO

model = YOLO("runs/detect/v8_exp1/weights/best.pt")

# 1) 导出 FP32 ONNX
model.export(format="onnx", imgsz=640, opset=12, simplify=True, dynamic=False)

# 2) 导出 FP16 ONNX(GPU 推理用,体积减半,精度基本无损)
model.export(format="onnx", imgsz=640, half=True)

# 3) 导出 INT8 ONNX —— 必须提供 data 做校准!
model.export(format="onnx", imgsz=640, int8=True, data="data.yaml")