




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
从 Deep Agents Code 源码拆解 LangChain 与 LangGraph 的生产级智能体工程
时间:2026-09-20 14:32:02 编辑:袖梨 来源:一聚教程网
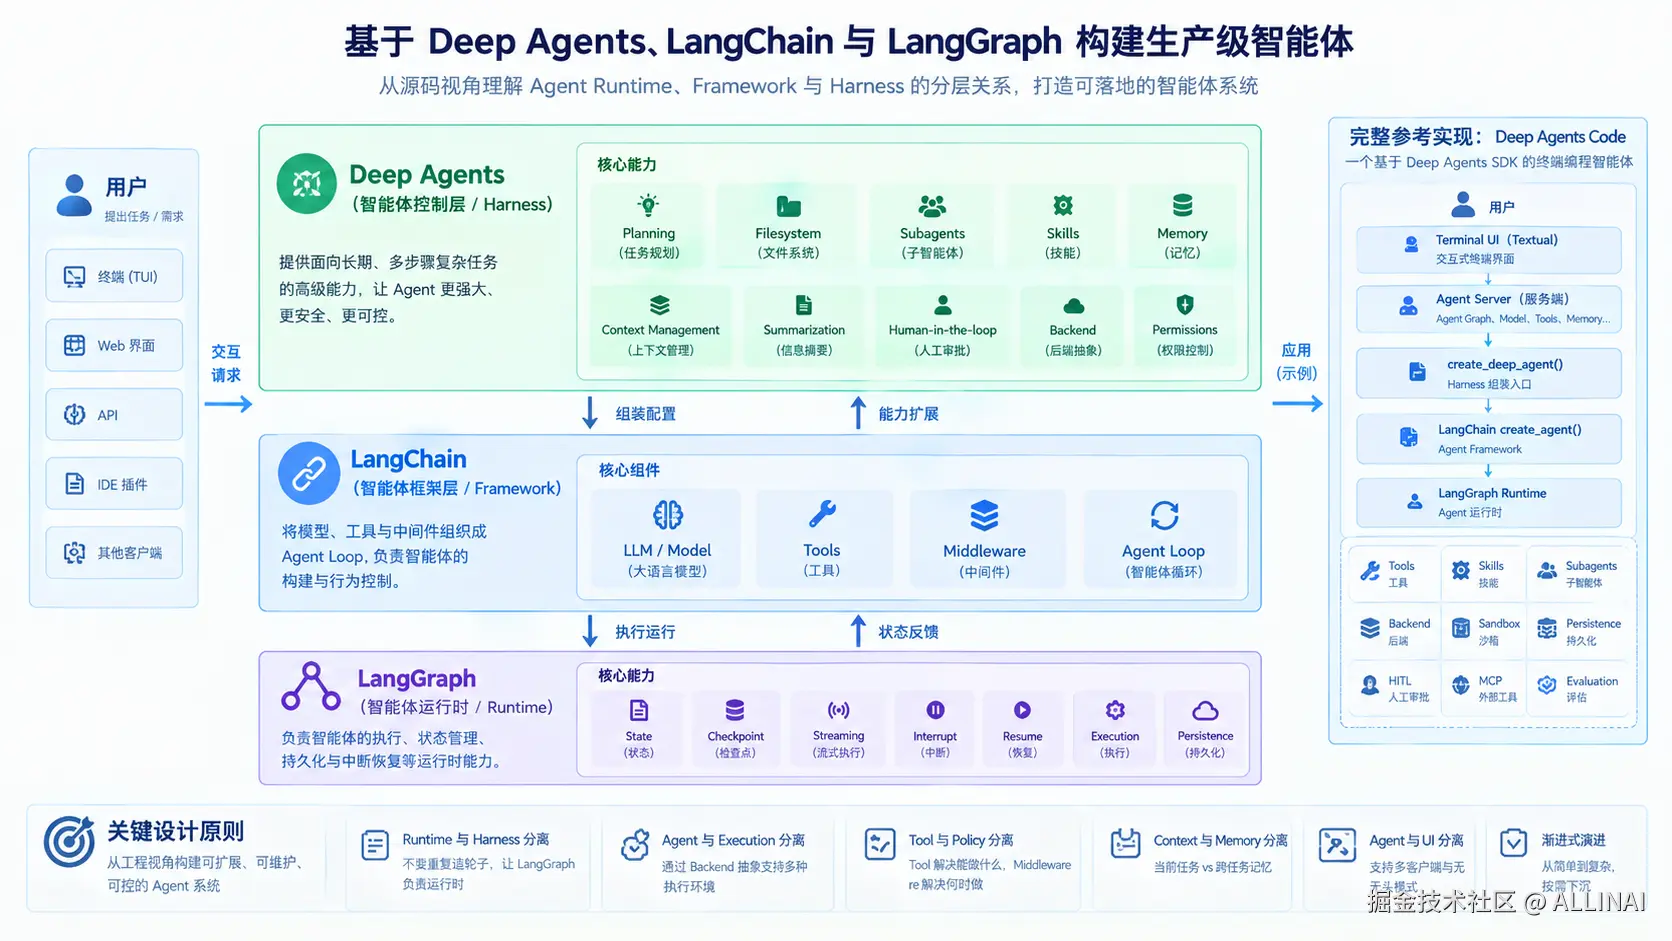
用几行代码创建一个能够调用工具的 Agent 并不困难,真正的挑战出现在任务链变长、状态需要持久化、操作必须受控之后。要理解这些能力如何落地,需要先分清运行时、框架与控制层的职责,再从 Deep Agents Code 的组装方式观察三层架构如何协同。
一、前言:真正复杂的 Agent,难点已经不只是 Prompt
最简单的 Agent(智能体)看起来非常简单:
User(用户)
   ↓
LLM(大语言模型)
   ↓
Tool(工具)
   ↓
Tool Result(工具结果)
   ↓
LLM
   ↓
Final Answer(最终答案)
使用 LangChain 创建这样一个 Agent,甚至只需要几行代码:
from langchain.agents import create_agent

agent = create_agent(
    model=model,
    tools=tools,
)
但当 Agent 真正进入复杂业务之后,问题会迅速增加:
- 如何让 Agent 处理几十步甚至上百步的长期任务?
- 如何避免 Context Window(上下文窗口)持续膨胀?
- 如何把复杂任务拆分给 Subagent(子智能体)?
- 如何让 Agent 操作文件系统?
- 如何安全执行 Shell(命令行)命令?
- 如何实现 Human-in-the-loop(人在回路)?
- 如何暂停并恢复一个长时间运行的任务?
- 如何保存 Conversation State(会话状态)?
- 如何让 Agent 跨会话拥有 Memory(记忆)?
- 如何针对不同模型调整 Agent 行为?
- 如何控制 Tool Call(工具调用)的权限?
- 如何隔离不可信代码?
- 如何进行 Trace(追踪)、Evaluation(评估)和 Debug(调试)?
这些问题已经不再属于单纯的 Prompt Engineering(提示词工程)。
它们属于:
Agent Engineering(智能体工程)
而 LangChain 生态目前提供的 Deep Agents、LangChain 和 LangGraph,恰好对应 Agent 系统中的不同抽象层。
从当前 deepagents 仓库的架构来看,可以将三者理解为:
┌──────────────────────────────────────┐
│            Deep Agents               │
│         Agent Harness(Harness层)   │
│                                      │
│ Planning / Skills / Memory           │
│ Filesystem / Subagents / Context     │
└──────────────────┬───────────────────┘
                   │
                   ▼
┌──────────────────────────────────────┐
│              LangChain               │
│       Agent Framework(框架层)      │
│                                      │
│ Model / Tools / Middleware / Loop    │
└──────────────────┬───────────────────┘
                   │
                   ▼
┌──────────────────────────────────────┐
│              LangGraph               │
│        Agent Runtime(运行时)       │
│                                      │
│ State / Checkpoint / Streaming       │
│ Interrupt / Resume / Execution       │
└──────────────────────────────────────┘
需要特别注意:
Deep Agents 并没有重新实现一个 Agent Runtime。
它是在 LangChain create_agent() 之上增加一套面向长期、多步骤复杂任务的 Agent Harness(智能体控制层),最终仍然由 LangGraph Runtime(运行时)负责执行。当前源码中的 create_deep_agent() 就是整个 Harness 的核心组装入口。
而 libs/code 中的 Deep Agents Code,则可以看作这套架构的一份完整参考实现:它不是一个新的 Runtime,而是一个建立在 deepagents SDK 之上的终端 Coding Agent(编程智能体)产品。
二、先理解三个核心抽象
在深入源码之前,必须先把三个概念区分清楚:
- Agent Runtime(智能体运行时)
- Agent Framework(智能体框架)
- Agent Harness(智能体控制层)
这是理解整个 LangChain Agent 技术栈的关键。
1. Agent Runtime:Agent 如何运行
Runtime(运行时)解决的是:
Agent 的状态如何保存、任务如何执行、中断后如何恢复。
例如:
State(状态)
   ↓
Node A(节点A)
   ↓
Node B(节点B)
   ↓
Node C(节点C)
   ↓
Checkpoint(检查点)
它主要关注:
- State(状态)
- Execution(执行)
- Checkpoint(检查点)
- Interrupt(中断)
- Resume(恢复)
- Streaming(流式执行)
- Persistence(持久化)
这正是 LangGraph 的核心职责。
当前 Deep Agents 官方架构也明确指出,LangGraph 负责 Runtime 层,包括状态、Checkpoint、Streaming 和 Interrupt 等能力。
三、LangGraph:Agent Runtime
LangGraph 是整个 Agent 技术栈更底层的 Runtime。
如果我们自己使用 LangGraph 构建一个 Agent Workflow(智能体工作流),可以显式定义:
from typing import TypedDict

from langgraph.graph import StateGraph


class AgentState(TypedDict):
    task: str
    plan: list[str]
    result: str
    status: str


def planner(state: AgentState):
    return {
        "plan": [
            "分析任务",
            "执行任务",
            "验证结果",
        ]
    }


def executor(state: AgentState):
    return {
        "result": "任务执行结果"
    }


def verifier(state: AgentState):
    return {
        "status": "completed"
    }


graph = StateGraph(AgentState)

graph.add_node("planner", planner)
graph.add_node("executor", executor)
graph.add_node("verifier", verifier)

graph.add_edge("planner", "executor")
graph.add_edge("executor", "verifier")
最终形成:
START
  ↓
Planner(规划)
  ↓
Executor(执行)
  ↓
Verifier(验证)
  ↓
END
这里最重要的不是 Graph API(图 API)本身。
而是:
执行路径是显式的。
我们可以明确规定:
Planner
   ↓
Executor
   ↓
Verifier
模型不能随意跳过 Verification(验证)阶段。
这就是 LangGraph 与普通 Agent Loop(智能体循环)的重要区别之一。
四、LangGraph 真正重要的是 State
一个 Agent 最核心的数据结构,其实不是 Prompt(提示词)。
而是:
State(状态)
例如:
from typing import TypedDict


class AgentState(TypedDict):
    messages: list
    task: str
    plan: list
    result: str
    status: str
Agent 执行过程中:
State₀
  ↓
Planner
  ↓
State₁
  ↓
Executor
  ↓
State₂
  ↓
Verifier
  ↓
State₃
State 是整个 Agent Runtime 的核心载体。
因此,设计生产级 Agent 时,一个非常重要的问题是:
哪些信息应该进入 Agent State?
例如:
messages
task
plan
current_step
tool_results
approval_state
status
而一些巨大的 Tool Result(工具结果)则未必适合直接长期存放在 State 中。
这就引出了后面的 Context Management(上下文管理)。
五、Checkpoint:让 Agent 可以暂停和恢复
传统函数调用一般是:
result = function()
执行结束之后,过程就结束了。
Agent 则可能运行很长时间:
Agent
  ↓
Plan
  ↓
Tool
  ↓
Tool
  ↓
Subagent
  ↓
Tool
  ↓
Human Approval
  ↓
继续执行
因此生产级 Agent 必须能够:
Running(运行)
   ↓
Interrupt(中断)
   ↓
Checkpoint(保存检查点)
   ↓
等待用户
   ↓
Resume(恢复)
   ↓
Continue(继续)
例如:
Agent
  ↓
准备执行危险操作
  ↓
Interrupt
  ↓
等待用户确认
  ↓
Approve
  ↓
Resume
  ↓
执行 Tool
这类能力并不是简单增加一个确认按钮就可以实现的。
它需要 Runtime 层真正支持:
State + Checkpoint + Interrupt + Resume
这也是 LangGraph 的核心价值之一。
六、第二层:LangChain Agent Framework
如果任务不需要复杂的 Graph Workflow(图工作流),就可以进一步向上使用 LangChain。
LangChain 当前的 Agent 抽象可以理解为:
Model(模型)
    ↓
Tool Call(工具调用)
    ↓
Tool Result(工具结果)
    ↓
Model
    ↓
Tool Call
    ↓
……
使用 create_agent() 即可:
from langchain.agents import create_agent


agent = create_agent(
    model=model,
    tools=tools,
)
其核心逻辑可以抽象成:
while not finished:

    response = model(messages, tools)

    if response contains tool_call:
        result = execute_tool(response)
        messages.append(result)
    else:
        return response
这就是典型的 Agent Loop(智能体循环)。
LangChain 负责的是:
如何把 Model(模型)、Tools(工具)、Middleware(中间件)组织成一个 Agent。
而真正的 Runtime 执行则交给 LangGraph。
当前 Deep Agents 官方架构也是如此:create_deep_agent() 最终会调用 LangChain 的 create_agent(),而 create_agent() 再建立在 LangGraph Runtime 之上。
七、Middleware:LangChain Agent 最重要的扩展点之一
如果只使用:
agent = create_agent(
    model=model,
    tools=tools,
)
能够完成很多简单任务。
但是复杂 Agent 往往需要:
- 动态修改 Prompt
- 动态增加或删除 Tool
- Context 压缩
- Tool Call 拦截
- Retry(重试)
- Human Approval(人工审批)
- Logging(日志)
- Model Routing(模型路由)
- Permission(权限)
- Policy(策略)
这些能力并不适合全部实现成 Tool。
因为:
Tool 解决的是“Agent 能做什么”。
而 Middleware 解决的是:
“Agent 应该如何运行,以及什么时候允许做什么”。
因此可以把两者理解为:
Tool
  ↓
能力层

Middleware
  ↓
行为控制层
八、为什么 Middleware 比增加 Tool 更重要?
假设我们需要限制:
Agent 不能随意执行 Shell 命令。
一种错误思路是:
def execute_shell(command: str):
    ...
然后期待模型自己遵守规则。
但这实际上属于:
让 LLM 自己负责安全。
这是不可靠的。
更合理的设计是:
LLM
 ↓
Tool Call
 ↓
Middleware
 ↓
Permission Check(权限检查)
 ↓
Human Approval(人工审批)
 ↓
Backend / Sandbox
 ↓
Execute
Deep Agents 当前的安全设计也明确强调:不要依赖 LLM 自我约束,而应该在 Tool、Permission、Backend 或 Sandbox 层建立真正的边界。
九、第三层:Deep Agents = Agent Harness
当 Agent 开始承担长期、多步骤任务时,单纯的:
Model + Tools + Agent Loop
往往已经不够。
我们还需要:
Planning
Filesystem
Subagents
Skills
Memory
Context Management
Summarization
Human-in-the-loop
Backend
如果每个项目都自己实现这些能力,开发成本非常高。
因此 Deep Agents 提供了:
Agent Harness(智能体控制层)
当前官方对 Deep Agents 的定位非常明确:
Deep Agents 是建立在 LangChain
create_agent()之上的、具有明确设计取向的 Agent Harness,而不是另一套 Agent Runtime。
因此:
Deep Agents
     ↓
create_agent()
     ↓
LangGraph Runtime
是理解它最准确的方式。
十、create_deep_agent() 到底做了什么?
如果只看:
from deepagents import create_deep_agent

agent = create_deep_agent(
    model=model,
    tools=tools,
)
很容易误认为:
create_deep_agent()只是一个更高级的create_agent()。
实际上它承担的是整个 Harness 的组装工作。
当前源码中的 create_deep_agent() 会负责处理:
Model
Backend
Middleware
Subagents
Skills
Memory
Permissions
Profiles
Checkpointer
Store
Response Format
最终再调用 LangChain 的 create_agent()。
可以抽象成:
create_deep_agent()
       │
       ├── Resolve Model(解析模型)
       │
       ├── Resolve Profile(解析模型配置)
       │
       ├── Resolve Backend(解析后端)
       │
       ├── Assemble Middleware(组装中间件)
       │
       ├── Build Subagents(构建子智能体)
       │
       ├── Compose Prompt(组合提示词)
       │
       └── create_agent()
                │
                ▼
          LangGraph Runtime
这也是阅读 Deep Agents 源码时最值得关注的入口。
十一、Deep Agents 的核心不是“更多 Tool”,而是 Context Engineering
复杂 Agent 最大的问题往往不是:
Tool 不够多。
而是:
模型不知道什么时候应该看到哪些信息。
例如一个 Coding Agent(编程智能体)可能同时面对:
用户任务
代码仓库
项目规范
当前文件
Git 状态
测试结果
依赖信息
历史修改
工具输出
Subagent 结果
如果全部塞进 Context Window:
Context
├── User Task
├── Repository
├── File A
├── File B
├── File C
├── Test Result
├── Git Result
├── Tool Result
└── History
最终会出现:
- Token 消耗越来越高;
- Context Window 接近上限;
- 模型注意力下降;
- 历史信息污染当前任务;
- 推理成本持续增加。
所以复杂 Agent 的核心问题逐渐变成:
Context Engineering(上下文工程)
而 Deep Agents 大量能力,实际上都是围绕这个问题设计的。
十二、Filesystem:把 Context 从模型上下文中卸载出去
Deep Agents 提供了 Filesystem(文件系统)抽象。
Agent 可以使用:
read_file
write_file
edit_file
glob
grep
execute
从而形成:
              LLM Context
                  │
        ┌─────────┴─────────┐
        │  当前任务相关信息  │
        └─────────┬─────────┘
                  │
                  ▼
             Filesystem
                  │
        ┌─────────┼─────────┐
        ▼         ▼         ▼
      file A    file B    file C
这实际上是一种:
Context Offloading(上下文卸载)
策略。
不是把所有信息永久放进模型 Context,而是:
需要的信息
    ↓
  读取

不需要的信息
    ↓
留在外部存储
对于 Coding Agent、Research Agent(研究智能体)、Document Agent(文档智能体)尤其重要。
十三、Backend:Filesystem 不等于本地磁盘
这是 Deep Agents 架构中非常重要的一层。
Agent 看到的是:
read_file()
write_file()
edit_file()
execute()
但这些操作实际可以发生在不同环境:
Local Filesystem(本地文件系统)
        │
        ├── Docker
        │
        ├── Sandbox
        │
        ├── Remote Environment
        │
        └── Cloud Execution
因此 Deep Agents 使用 Backend(后端)抽象将:
Agent Logic
与:
Execution Environment(执行环境)
分离。
可以理解成:
Agent
  ↓
Tool
  ↓
Backend
  ↓
Execution Environment
这样 Agent 不需要关心:
Shell 到底运行在本机、Docker 还是远程 Sandbox。
这也是生产级 Coding Agent 非常重要的设计。
十四、为什么 Coding Agent 必须考虑 Sandbox?
如果 Agent 可以执行:
rm -rf ./tmp
或者:
pip install some-package
甚至:
git push
那么它已经拥有真实的 Side Effects(副作用)。
此时系统就必须考虑:
Agent
  ↓
Tool
  ↓
Permission
  ↓
Sandbox
  ↓
Execution
这里有一个非常重要的概念:
Human Approval(人工审批)不等于 Sandbox(沙箱)。
人工审批解决:
“用户是否允许这次操作?”
Sandbox 解决:
“即使允许执行,执行环境是否被隔离?”
二者是完全不同的安全边界。
Deep Agents Code 当前文档也明确指出,远程 Sandbox 是处理不可信代码仓库的重要边界,而 Human Approval 只是辅助控制,并不能把本地执行环境自动变成 Sandbox。
十五、Subagent:解决复杂任务与 Context Isolation(隔离)
复杂任务经常会出现:
Main Agent
    ↓
Research
    ↓
大量搜索结果
    ↓
大量网页内容
    ↓
大量分析
    ↓
Context 爆炸
一个更合理的架构是:
                 Main Agent
                     │
          ┌──────────┼──────────┐
          ▼          ▼          ▼
      Research     Coding     Review
       Agent        Agent      Agent
          │          │          │
          ▼          ▼          ▼
       Result      Result      Result
          └──────────┼──────────┘
                     ▼
                 Main Agent
Subagent 的一个核心价值就是:
Context Isolation(上下文隔离)
主 Agent 不需要看到 Subagent 执行过程中的所有细节。
只需要得到:
Task Result
Summary
Evidence(证据)
即可。
十六、Deep Agents 中的 Subagent 是如何工作的?
当前 Deep Agents 的 SubAgentMiddleware 会为主 Agent 提供 task Tool。
主 Agent 可以通过:
task(...)
将任务委派给指定 Subagent。
例如可以声明:
from deepagents import create_deep_agent


agent = create_deep_agent(
    model="openai:gpt-5.5",
    subagents=[
        {
            "name": "researcher",
            "description": "负责技术资料研究和事实核查",
            "system_prompt": "你是一名技术研究员。",
            "model": "openai:gpt-5.5",
            "tools": [search_tool],
        }
    ],
)
主 Agent 的行为就可能变成:
User
 ↓
Main Agent
 ↓
发现需要技术调研
 ↓
task(researcher)
 ↓
Researcher
 ↓
Search
 ↓
Analyze
 ↓
Return Result
 ↓
Main Agent
当前源码中,声明式 Subagent 默认采用 isolated 模式,只接收委派任务;同时也支持实验性的 fork 模式,用于继承父 Agent 的上下文。
十七、为什么 Subagent 不应该无限增加?
Multi-Agent(多智能体)并不是越多越好。
例如:
User
 ↓
Planner
 ↓
Researcher
 ↓
Coder
 ↓
Reviewer
 ↓
Tester
 ↓
Reporter
看起来非常“Agentic(智能体化)”。
但实际上可能只是把简单函数调用复杂化了。
如果一个问题可以通过:
Function > Agent
解决,就不要使用 Agent。
如果一个问题可以通过:
Tool > Subagent
解决,也不要创建 Subagent。
只有当任务真正需要:
- 独立 Context
- 多步骤推理
- 专业领域能力
- 自主决策
时,Subagent 才真正有价值。
十八、Skills:不要把所有知识都塞进 System Prompt
另一个典型问题是:
Agent 需要很多领域知识。
例如 Coding Agent 可能需要:
Python
Docker
Kubernetes
React
SQL
Git
Testing
Security
如果全部写进 System Prompt:
System Prompt
    ↓
   巨大
同样会导致 Context 浪费。
因此 Deep Agents 提供 Skills(技能)。
一个 Skill 可以包含:
Skill
├── Instructions(指令)
├── Examples(示例)
├── Scripts(脚本)
└── Supporting Files(辅助文件)
Agent 需要时再加载。
形成:
System Prompt
      ↓
有哪些 Skill?
      ↓
Agent 判断
      ↓
加载 Skill
      ↓
   执行任务
这就是:
Progressive Disclosure(渐进式信息披露)
十九、Memory:Context 与 Memory 不应该混为一谈
Agent 项目中经常把:
Conversation History(对话历史)
和:
Memory
混为一谈。
实际上它们解决不同的问题。
Context(上下文)
解决:
当前任务需要知道什么?
Memory(记忆)
解决:
跨任务、跨会话需要保留什么?
例如:
Context
├── 当前任务
├── 当前文件
├── 当前 Tool Result
└── 当前 Plan

Memory
├── 用户偏好
├── 项目规范
├── 历史经验
└── 长期知识
Deep Agents 将 Memory 作为 Harness 能力提供,而 LangGraph 负责 Agent State 的运行时持久化;二者不要混淆。
二十、Middleware 才是 Deep Agents 真正的核心
如果真正阅读 Deep Agents 源码,会发现:
create_deep_agent()本身并没有实现所有能力。
大量功能都来自 Middleware(中间件)。
当前源码中,Deep Agents 的核心能力主要分布在:
middleware/
backends/
profiles/
其中 Middleware 负责将 Harness 行为注入 Agent Loop。
例如:
middleware/
├── filesystem.py
├── subagents.py
├── skills.py
├── memory.py
├── permissions.py
├── summarization.py
└── ...
当前源码也明确说明,Middleware 可以通过 wrap_model_call() 等机制拦截模型请求,动态过滤 Tool、注入 System Prompt Context,以及改变 Agent 的运行行为。
因此,如果真正想研究 Deep Agents:
不要只研究
create_deep_agent(),更应该研究 Middleware。
二十一、可以把 Middleware 分成三类
如果自己设计 Agent Harness,可以将 Middleware 大致分为三类。
1. Context Middleware(上下文中间件)
负责:
Prompt
Context
Memory
Skills
Filesystem
例如:
before_model()
    ↓
加载项目规范
    ↓
加载 Skill
    ↓
加载 Memory
    ↓
调用 Model
2. Control Middleware(控制中间件)
负责:
Permission
Approval
Retry
Timeout
Policy
Loop Detection
例如:
Tool Call
    ↓
Permission Middleware
    ↓
Approval Middleware
    ↓
Tool
3. Optimization Middleware(优化中间件)
负责:
Summarization
Context Compression
Caching
Model Routing
Cost Control(成本控制)
例如:
Context Too Large
       ↓
Summarization
       ↓
Continue
这种分层方式可以让整个 Agent Harness 更容易维护。
二十二、Deep Agents Code:一个完整的 Agent 产品参考实现
理解到这里,再来看:
libs/code
就会非常清晰。
Deep Agents Code 并不是重新实现一个 Agent Framework。
它是:
一个建立在 Deep Agents SDK 之上的完整 Terminal Coding Agent(终端编程智能体)。
当前仓库将它描述为一个预构建的 Coding Agent,并提供:
- Interactive TUI(交互式终端界面)
- Remote Sandbox(远程沙箱)
- Persistent Memory(持久化记忆)
- Skills
- Human-in-the-loop
- Headless Mode(无头模式)
等能力。
因此它非常适合作为:
Agent Product Architecture(智能体产品架构)的参考实现。
二十三、Deep Agents Code 的整体架构
根据当前 libs/code 的架构,可以抽象为:
                     User
                      │
                      ▼
              ┌──────────────┐
              │ Terminal UI  │
              │   Textual    │
              └──────┬───────┘
                     │
                  Streaming
                     │
                     ▼
              ┌──────────────┐
              │ Agent Server │
              └──────┬───────┘
                     │
              create_cli_agent()
                     │
                     ▼
             create_deep_agent()
                     │
                     ▼
             LangChain Agent
                     │
                     ▼
             LangGraph Runtime
                     │
       ┌─────────────┼─────────────┐
       ▼             ▼             ▼
     Model          Tools       Middleware
       │             │             │
       │             │       ┌─────┼─────┐
       │             │       ▼     ▼     ▼
       │          Backend  Skills Memory
       │                         │
       │                      Subagents
       │
       ▼
    Tool Calling
当前 libs/code 的运行流程明确采用客户端与服务端分离:
CLI
 ↓
Textual Client
 ↓
langgraph dev Server
 ↓
server_graph.make_graph()
 ↓
create_cli_agent()
 ↓
create_deep_agent()
 ↓
LangGraph Execution
也就是说:
UI 层和 Agent Graph(智能体图)执行层是分开的。
二十四、为什么 Agent UI 与 Agent Runtime 要分离?
一个初学者常见的实现方式是:
while True:
    user_input = input()

    result = agent.invoke({
        "messages": user_input
    })

    print(result)
Demo 没有问题。
但生产环境很快会遇到:
- Agent 阻塞 UI;
- Streaming 不方便;
- HITL 不方便;
- Resume 不方便;
- 多客户端困难;
- Headless 模式困难;
- Server 部署困难。
更合理的架构是:
Presentation Layer(表现层)
          │
          ▼
Agent Service(智能体服务)
          │
          ▼
Agent Runtime(智能体运行时)
Deep Agents Code 当前正是沿着这个方向设计的:终端客户端负责交互和展示,服务端负责 Agent Graph、Model、Tools、Memory、Skills 等核心能力。
二十五、Deep Agents Code 中的 Agent Server
从当前源码结构来看,几个值得重点关注的文件是:
libs/code/deepagents_code/
├── main.py
├── server_graph.py
├── agent.py
├── approval_mode.py
├── auto_mode.py
└── mcp_tools.py
其中:
main.py
负责:
CLI parsing(命令行解析)
Configuration(配置)
Textual App(终端应用)
Server Startup(服务启动)
server_graph.py
负责:
Model Resolution(模型解析)
MCP Loading(MCP 加载)
Sandbox Setup(沙箱配置)
Graph Construction(Graph 构建)
agent.py
则更加关键。
它负责组装:
Model
Goal(目标) / Resume State
Ask User
Memory
Skills
Plugins
Shell
Interpreter
Compaction(压缩)
Rubric(评分标准)
Approval Middleware
Main Agent
Subagents
也就是说:
agent.py本质上就是 Deep Agents Code 的 Agent Assembly Layer(智能体组装层)。
二十六、Human-in-the-loop:不要理解成一个简单确认框
生产级 Agent 中:
Model
 ↓
Tool Call
 ↓
Human Approval
 ↓
Execute
只是表面。
真正的 Runtime 流程应该是:
Agent
 ↓
Tool Call
 ↓
Interrupt
 ↓
Checkpoint
 ↓
等待用户
 ↓
Human Decision(决策)
 ↓
Resume
 ↓
Tool Execution
所以:
HITL 的核心不是 UI,而是 Runtime 的 Interrupt + Checkpoint + Resume。
UI 只是把 Runtime 暴露给用户。
这也是为什么 Deep Agents Code 的审批机制最终仍然依赖 LangGraph 的运行时能力。
二十七、Approval 与 Sandbox 必须分开设计
这是 Coding Agent 中非常重要的安全原则。
例如:
write_file
execute
delete
git push
可以进行:
Human Approval
但是:
Human Approval ≠ Sandbox
即使用户点击:
Approve
代码仍然应该运行在受控环境中。
因此:
Permission
   +
Human Approval
   +
Sandbox
三者承担不同责任。
当前 Deep Agents Code 的安全文档也明确将 Approval 视为安全策略,而不是执行隔离机制;对于不可信代码仓库,远程 Sandbox 才是重要的隔离边界。
二十八、MCP:Tool 能力的另一种扩展方式
现代 Agent 很多能力并不是自己实现 Python Function。
而是通过:
MCP(Model Context Protocol,模型上下文协议)
接入外部 Tool Server(工具服务器)。
于是:
Agent
  │
  ├── Native Tools(原生工具)
  │
  └── MCP Tools(MCP 工具)
可以统一进入模型的 Tool Surface(工具面)。
但这里也存在一个重要安全问题:
MCP Configuration(MCP 配置)本身也是一个 Trust Boundary(信任边界)。
因为一个 MCP Server 可能:
- 启动本地进程;
- 访问网络;
- 读取环境变量;
- 访问外部服务;
- 发送数据。
所以不能简单认为:
MCP = Tool
而应该理解为:
MCP
 ↓
External Capability(外部能力)
 ↓
Trust Boundary(信任边界)
当前 Deep Agents Code 对项目级 MCP 配置专门设计了信任和审批机制。
二十九、为什么不能把所有逻辑都交给 LLM?
这是 Agent Engineering 与传统 Workflow Engineering(工作流工程)之间非常重要的区别。
例如:
金额是否超过 10000 元?
不应该交给 LLM:
LLM 判断:
“我认为超过了。”
应该使用确定性代码:
if amount > 10000:
    require_approval()
LLM 更适合:
理解
推理
规划
自然语言交互
模糊判断
开放式探索
代码更适合:
权限
状态
金额
超时
重试
合规
数据一致性
安全边界
因此:
优秀 Agent 并不是让 LLM 决定一切,而是合理划分 Deterministic Logic(确定性逻辑)与 Agentic Logic(智能体逻辑)。
三十、什么时候应该继续使用 Deep Agents?
如果你的 Agent 主要表现为:
用户
 ↓
复杂任务
 ↓
Agent 自主规划
 ↓
Tool
 ↓
Subagent
 ↓
Tool
 ↓
最终结果
那么 Deep Agents 很适合。
典型任务包括:
- Coding Agent
- Research Agent
- Content Agent
- Data Analysis Agent
- Document Agent
- Operations Agent
这些任务通常具有:
Long Horizon(长任务周期)
+
Multi-step(多步骤)
+
Tool Use(工具调用)
+
Context Management(上下文管理)
这正是 Deep Agents 的目标场景。
三十一、什么时候应该使用 LangChain?
如果你的任务主要是:
Model
+
Tools
+
简单 Agent Loop
而不需要:
- 大量 Context 管理;
- Subagents;
- Filesystem;
- Skills;
- 复杂 Memory;
那么:
from langchain.agents import create_agent

agent = create_agent(
    model=model,
    tools=tools,
)
通常已经足够。
例如:
RAG Q&A Agent(RAG 问答智能体)
流程可能只是:
User Question
     ↓
Agent
     ↓
Vector Search
     ↓
Retrieved Documents
     ↓
LLM
     ↓
Answer
没有必要为了使用 Deep Agents 而强行引入完整 Harness。
三十二、什么时候应该下降到 LangGraph?
如果业务逻辑已经变成:
Agent
 ↓
必须审批
 ↓
执行数据库操作
 ↓
验证
 ↓
失败重试
 ↓
人工处理
那么 Graph 就开始产生价值。
例如:
START
  ↓
Agent
  ↓
Approval
  ↓
Execute
  ↓
Verify
  ↓
Success ─────→ END
  │
  ↓
Failure
  ↓
Retry
此时:
Graph 本身就是业务逻辑。
而不是单纯让 LLM 决定下一步。
三十三、Deep Agents、LangChain、LangGraph 并不是竞争关系
不要把它们理解成:
Deep Agents
VS
LangChain
VS
LangGraph
更准确的理解是:
             Agent Product
                   │
                   ▼
             Deep Agents
            Agent Harness
                   │
                   ▼
              LangChain
            Agent Framework
                   │
                   ▼
              LangGraph
             Agent Runtime
甚至可以组合:
LangGraph Workflow
       ↓
作为 Subagent
       ↓
Deep Agents
或者:
Deep Agents
       ↓
LangChain Middleware
       ↓
自定义行为
因此三者实际上形成了一套可以逐层深入的技术栈。
三十四、一个生产级 Agent 的推荐架构
如果我们现在自己构建一个企业级 Agent,可以采用下面的结构:
                         User
                          │
                          ▼
                  ┌───────────────┐
                  │   API / UI    │
                  └───────┬───────┘
                          │
                          ▼
                  ┌───────────────┐
                  │ Agent Service │
                  └───────┬───────┘
                          │
                  ┌───────▼───────┐
                  │   LangGraph   │
                  │    Runtime    │
                  └───────┬───────┘
                          │
                  ┌───────▼───────┐
                  │   LangChain   │
                  │  Agent Loop   │
                  └───────┬───────┘
                          │
                  ┌───────▼───────┐
                  │  Deep Agents  │
                  │    Harness    │
                  └───────┬───────┘
                          │
             ┌────────────┼────────────┐
             ▼            ▼            ▼
          Context        Tools      Subagents
             │            │            │
       ┌─────┼─────┐      │            │
       ▼     ▼     ▼      ▼            ▼
    Memory Skills Files Backend      Agents
                         │
                         ▼
                      Sandbox
这套架构最重要的不是组件数量。
而是:
每一层负责不同的问题。
三十五、从零构建自己的 Agent,推荐这样演进
不要一开始就:
LangGraph
+
LangChain
+
Deep Agents
+
20 个 Middleware
+
10 个 Subagent
+
MCP
+
Memory
+
Sandbox
这样很容易把系统做复杂。
更合理的演进路径是:
Phase 1
Model + Tool
    ↓
LangChain create_agent()

Phase 2
Middleware
    ↓
Context / Retry / Logging / HITL

Phase 3
Deep Agents
    ↓
Planning / Filesystem / Skills / Subagents

Phase 4
Backend
    ↓
Sandbox / Remote Execution

Phase 5
LangGraph
    ↓
Custom Workflow / Deterministic Control

Phase 6
Evaluation
    ↓
Trace / Eval / Regression

Phase 7
Production
    ↓
Persistence / Deployment / Observability
核心原则是:
只有当上层抽象不够用时,才向下深入。
三十六、Evaluation:Agent 执行成功,不代表任务成功
传统程序:
Input
 ↓
Function
 ↓
Output
比较容易判断成功与否。
Agent 则不同:
Task
 ↓
Agent
 ↓
Tool
 ↓
Tool
 ↓
Subagent
 ↓
Tool
 ↓
Final Answer
Agent 可能:
- 调用了错误的 Tool;
- 得到了错误信息;
- 推理过程正确但结果错误;
- 修改了错误的文件;
- 测试没有通过;
- 没有完成用户真正要求的目标。
所以:
Agent 必须有 Evaluation(评估)体系。
例如 Coding Agent:
Task
 ↓
Agent
 ↓
Code Changes
 ↓
Unit Test
 ↓
Static Analysis
 ↓
Evaluation
而不是:
Agent Final Answer
       ↓
      OK
当前 deepagents 仓库已经单独提供 evals 包,用于 Agent 行为评估和基准测试。
三十七、Observability:为什么 Agent 必须可观测?
传统 API:
Request
 ↓
Response
日志相对简单。
Agent:
User
 ↓
Model
 ↓
Tool
 ↓
Model
 ↓
Tool
 ↓
Subagent
 ↓
Tool
 ↓
Model
 ↓
Final
如果没有 Trace(追踪),你甚至不知道:
Agent 为什么失败。
因此应该能够观察:
Run
├── Model Call
├── Tool Call
├── Middleware
├── Subagent
├── Token Usage(用量)
├── Latency(延迟)
├── Error
└── Final Result
这也是 LangGraph、LangChain、Deep Agents 与 LangSmith 等 Observability(可观测性)和 Evaluation(评估)能力结合的重要原因。
三十八、真正的 Agent Improvement(改进) Loop
成熟的 Agent 不应该:
效果不好
 ↓
改 Prompt
 ↓
再试
 ↓
效果不好
 ↓
继续改 Prompt
更合理的是:
                 ┌──────────────┐
                 │    Agent     │
                 └──────┬───────┘
                        │
                        ▼
                    Execution
                        │
                        ▼
                       Trace
                        │
                        ▼
                    Evaluation
                        │
                        ▼
                 Failure Analysis
                        │
                        ▼
                Harness Improvement
                        │
                        └──────────→ Agent
也就是:
Agent → Trace → Evaluation → Failure Analysis → Harness Improvement → Agent
这就是 Harness Engineering(智能体控制层工程)的核心思路之一。
三十九、Deep Agents Code 最值得学习的不是 Coding Agent,而是工程方法
如果只是把 libs/code 看成:
“一个类似 Claude Code 的开源项目。”
其实低估了它的价值。
它更值得研究的是:
如何把一个 Model + Tool 的 Agent Demo,逐步工程化成一个完整的 Agent Product。
从当前源码可以看到几个非常重要的设计原则。
原则一:Runtime 与 Harness 分离
LangGraph
    ↓
Runtime

Deep Agents
    ↓
Harness
不要自己重新实现 Runtime。
原则二:Agent 与 Execution Environment 分离
Agent
 ↓
Backend
 ↓
Execution Environment
这样可以支持:
Local
Docker
Remote Sandbox
Cloud
原则三:Tool 与 Policy 分离
Tool
 ↓
能做什么

Policy
 ↓
什么时候可以做
原则四:Context 与 Memory 分离
Context
=
当前任务需要的信息

Memory
=
跨任务需要保存的信息
原则五:Agent 与 UI 分离
UI
 ↓
Agent Service
 ↓
Runtime
这样才能支持:
TUI
Web
API
Headless
IDE
ACP
Deep Agents Code 当前的客户端/服务端架构正体现了这一思想。
四十、如果要自己实现一个企业级 Coding Agent
可以进一步把前面的设计落到工程目录:
my-agent/
├── app/
│   ├── api/
│   │   └── routes.py
│   │
│   ├── agent/
│   │   ├── graph.py
│   │   ├── middleware/
│   │   │   ├── context.py
│   │   │   ├── permission.py
│   │   │   ├── approval.py
│   │   │   └── summarization.py
│   │   │
│   │   ├── tools/
│   │   │   ├── filesystem.py
│   │   │   ├── shell.py
│   │   │   └── git.py
│   │   │
│   │   ├── subagents/
│   │   │   ├── researcher.py
│   │   │   └── reviewer.py
│   │   │
│   │   └── skills/
│   │       ├── coding/
│   │       └── testing/
│   │
│   ├── backend/
│   │   ├── local.py
│   │   ├── docker.py
│   │   └── sandbox.py
│   │
│   └── evaluation/
│       ├── datasets.py
│       └── evaluators.py
│
└── tests/
对应关系:
Agent Runtime
    ↓
LangGraph

Agent Loop
    ↓
LangChain

Agent Harness
    ↓
Deep Agents / Custom Middleware

Execution
    ↓
Backend / Sandbox

Capabilities
    ↓
Tools / MCP

Specialization
    ↓
Subagents / Skills

Quality(质量)
    ↓
Evaluation / Observability
四十一、什么时候应该自己实现 Harness?
这是一个非常重要的问题。
不是所有项目都应该直接使用完整 Deep Agents。
如果你的 Agent:
非常简单
+
任务很短
+
Tool 很少
+
Context 很小
那么:
LangChain create_agent()
通常就足够。
如果你的 Agent:
任务很长
+
Tool 很多
+
需要文件系统
+
需要 Subagent
+
需要 Context Management
那么:
Deep Agents
更加合适。
如果你的 Agent:
流程高度确定
+
复杂业务规则
+
大量条件分支
+
必须人工审批
+
严格状态控制
那么:
LangGraph
的价值会更高。
四十二、最终如何理解三者?
可以用三个问题来理解。
LangGraph
回答:
Agent 怎么运行?
它解决:
State
Checkpoint
Interrupt
Resume
Streaming
Execution
LangChain
回答:
Agent 怎么构建?
它解决:
Model
Tools
Middleware
Agent Loop
Deep Agents
回答:
如何让 Agent 更适合长期、复杂、多步骤任务?
它解决:
Planning
Filesystem
Subagents
Skills
Memory
Context Management
Summarization
Permissions
Backend
所以:
Deep Agents
    ↓
Harness

LangChain
    ↓
Framework

LangGraph
    ↓
Runtime
不是三个互相竞争的产品。
而是三个可以组合的技术层。
四十三、最终架构:从 Runtime 到 Agent Product
如果把整个体系放在一起,可以得到:
                         Agent Product
                              │
                              ▼
                    ┌──────────────────┐
                    │  Deep Agents     │
                    │  Agent Harness   │
                    └────────┬─────────┘
                             │
                    ┌────────▼─────────┐
                    │    LangChain     │
                    │ Agent Framework  │
                    └────────┬─────────┘
                             │
                    ┌────────▼─────────┐
                    │    LangGraph     │
                    │  Agent Runtime   │
                    └────────┬─────────┘
                             │
               ┌─────────────┼─────────────┐
               ▼             ▼             ▼
             State        Execution     Persistence
               │             │             │
               ▼             ▼             ▼
          Checkpoint      Backend       Store
                             │
                             ▼
                          Sandbox
在这个架构之上,再增加:
Tools
MCP
Skills
Subagents
Memory
Human-in-the-loop
Evaluation
Observability
最终才形成真正完整的 Agent System(智能体系统)。
四十四、结语:Agent Engineering 正在从 Prompt Engineering 走向 Harness Engineering
今天构建 Agent,真正困难的问题已经逐渐从:
“怎么写一个好的 Prompt?”
转变成:
“如何构建一个能够可靠完成复杂任务的 Agent System?”
这意味着开发者需要同时考虑:
Model
+
Prompt
+
Tools
+
Middleware
+
Context
+
Memory
+
Subagents
+
Skills
+
Backend
+
Sandbox
+
State
+
Persistence(持久化)
+
HITL
+
Evaluation
+
Observability
而 Deep Agents、LangChain、LangGraph 恰好提供了这套体系中的不同抽象层。
从当前 deepagents 源码来看,可以把三者的关系浓缩成一句话:
LangGraph 提供 Agent 的 Runtime,LangChain 提供 Agent Loop,而 Deep Agents 则通过 Middleware、Backend、Skills、Memory 和 Subagents 等机制构建面向复杂长期任务的 Agent Harness。
而 libs/code 中的 Deep Agents Code,则进一步说明:
真正的 Agent 产品不仅需要一个 Agent Loop,还需要把 Runtime、Harness、Tool、Backend、Sandbox、Persistence、UI、Approval、MCP 和 Evaluation 组织成一个完整系统。
这也是专业 Agent 开发者应该从 Deep Agents Code 中真正学习的东西。
不是某一个 API。
而是一套完整的分层思想:
Runtime
   ↓
Framework
   ↓
Harness
   ↓
Agent
   ↓
Product
当你能够准确判断:
- 哪些事情应该由代码决定;
- 哪些事情应该交给 LLM;
- 哪些能力应该做成 Tool;
- 哪些行为应该放进 Middleware;
- 哪些任务应该拆成 Subagent;
- 哪些信息应该进入 Context;
- 哪些信息应该进入 Memory;
- 哪些执行必须经过 Permission;
- 哪些操作必须进入 Sandbox;
- 哪些流程应该由 LangGraph 显式控制;
你才真正进入了 Agent Engineering(智能体工程) 的核心领域。
五、参考源码
本文重点参考以下 Deep Agents 官方源码与架构文档:
deepagents核心 SDKlibs/ARCHITECTURE.mdlibs/code/ARCHITECTURE.mdlibs/code/deepagents_code/agent.pylibs/code/deepagents_code/server_graph.pylibs/code/deepagents_code/approval_mode.pylibs/code/deepagents_code/auto_mode.pylibs/deepagents/deepagents/graph.pylibs/deepagents/deepagents/middleware/libs/deepagents/deepagents/backends/libs/deepagents/deepagents/profiles/
其中最值得源码阅读的路径,可以按照下面的顺序进行:
libs/ARCHITECTURE.md
        ↓
libs/deepagents/deepagents/graph.py
        ↓
libs/deepagents/deepagents/middleware/
        ↓
libs/deepagents/deepagents/backends/
        ↓
libs/code/deepagents_code/agent.py
        ↓
libs/code/deepagents_code/server_graph.py
        ↓
libs/code/deepagents_code/approval_mode.py
这个阅读顺序基本对应:
整体架构
   ↓
Agent 组装
   ↓
Middleware
   ↓
Backend
   ↓
完整 Agent 产品
   ↓
安全与执行策略
如果你正在自己开发 Agent,这比单纯从 create_deep_agent() 的 API 文档开始阅读更容易建立完整的架构认知。
相关文章
- ChatGPT Plus切换Codex入口后,为何模型与额度会发生变化? 09-20
- asp文件用什么软件编辑 09-20
- asp文件如何打开 09-20
- ASP基础知识5BScript基本元素讲解 09-20
- 从 Deep Agents Code 源码拆解 LangChain 与 LangGraph 的生产级智能体工程 09-20
- ASP基础知识Command对象讲解 09-20