




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
Java转向AI工程化第6周:构建可控、可协作的Agent
时间:2026-09-16 13:20:01 编辑:袖梨 来源:一聚教程网
让模型成功调用一次工具,只能证明Agent具备基本执行能力;进入真实业务后,架构选择、上下文膨胀、工具故障、版本兼容和协作失控都会迅速暴露。站在Java工程化视角,需要把这些问题纳入统一设计,并为智能体补齐编排、治理、评估与可观测能力。
Java开发者转型AI工程化Week 6:让Agent从能调工具到可控可协作——架构可选、工具可控、多体协作、质量可度量
作者: 一位正在转型的Java开发者
时间: 2026年5月
系列: Java开发者AI工程化转型记录(Week 6/9)
标签: ReAct, Plan-and-Execute, Reflexion, Tool Calling, Multi-Agent, MCP, 可观测
前言:Week 3埋下的三个伏笔
Week 3我第一次写出能自主行动的Agent——@Tool注解让方法变成模型可调用的工具,AiServices把LLM、记忆和工具装配成一个可运行的对象。当时我很兴奋,觉得"Agent不过如此"。
真到要用的时候才发现,那只是能跑。Week 5结束时我意识到,真正难的是另外三个问题:架构该选哪一种(ReAct不是唯一答案)、工具怎么管(加个@Tool只是开始,版本、错误、安全、可观测一件都没解决)、多个Agent怎么协作(单个Agent解决不了复杂任务,但Java生态居然没有趁手的框架)。
如果说Week 5是"让RAG学会思考",Week 6就是"让Agent学会在工程约束下行动"。
Day 1:三种架构范式——ReAct、Plan-and-Execute、Reflexion
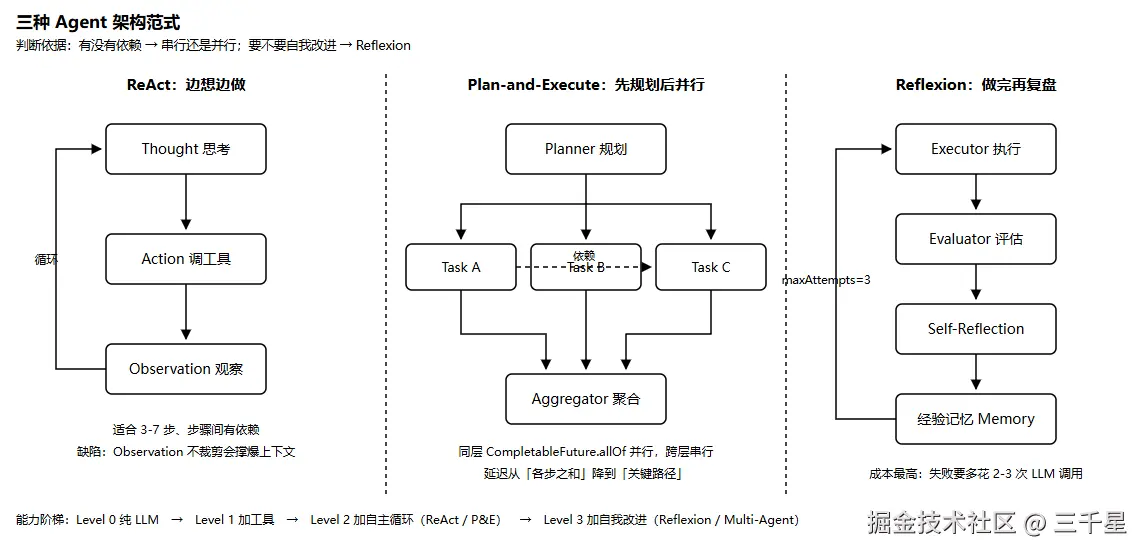
三种范式解决的是三类不同的问题:ReAct边想边做,适合步骤少、前后有依赖的任务;Plan-and-Execute先规划再并行,适合能拆开的子任务;Reflexion多了评估与反思,适合允许失败重试、且同类任务会反复出现的场景。
ReAct:一步一想一观察
ReAct是Week 3就见过的老朋友:Thought → Action → Observation 循环,模型每步先说想法、再调工具、然后把结果塞回上下文,直到给出答案。
for (int i = 0; i < maxIterations; i++) {
    ChatResponse r = [email protected](new Prompt(messages, ch@tOptions));
    AssistantMessage am = r.getResult().getOutput();

    if (am.getToolCalls().isEmpty()) {
        return AgentResult.done(am.getText());  // 收敛:不再调工具
    }
    for (ToolCall tc : am.getToolCalls()) {
        messages.add(executeToolCall(tc).toAssistantMessage());  // 回灌观察结果
    }
}
return AgentResult.maxIterationsReached();
核心洞察:这段骨架代码有个致命缺陷——它没有任何Observation长度裁剪。工具返回一份5000字的文档,就原样塞进messages,十步之后上下文必然爆炸。Week 3我写的时候没意识到,因为Demo里的工具都只返回一句话。真实项目里,裁剪策略(截断、摘要、只留关键字段)是ReAct能不能用的前提,而maxIterations=10只是防止无限循环的最后一道保鲜。
Plan-and-Execute:先画依赖图,再并行跑
ReAct的串行循环天然慢——每一步都要等上一步。Plan-and-Execute换个思路:先让LLM把任务拆成带依赖关系的步骤,没有依赖的并行跑。
// 规划阶段:LLM输出带 depends_on 的步骤列表
record Step(String stepId, String tool, List<String> dependsOn, boolean canParallelWith) {}

// 执行阶段:按依赖图拓扑分层,同层并行
DependencyGraph graph = new DependencyGraph(steps);
for (List<Step> layer : graph.topologicalLayers()) {
    layer.stream()
        .map(s -> CompletableFuture.supplyAsync(() -> execute(s), executor))
        .toList()
        .forEach(CompletableFuture::join);   // 同层并行,跨层串行
}
关键设计:延迟从Σ(每一步) 降到关键路径长度。查天气、查航班、查酒店三件互不依赖的事,ReAct要三次串行往返,P&E一次并行就搞定。代价是规划阶段本身要一次LLM调用,而且Token集中在规划期——好处是执行期可以清掉历史,反而更省。
Reflexion与四级能力阶梯
Reflexion在"执行"之外加了三件事:评估、反思、写经验记忆。失败之后不是简单重试,而是让模型自己总结"这次哪里错了、下次该怎么做",存进经验库供后续任务检索。
| 级别 | 能力 | 典型形态 |
|---|---|---|
| Level 0 | 纯LLM推理 | 不带工具的对话 |
| Level 1 | + 工具调用 | 单个Tool Calling |
| Level 2 | + 自主循环 | ReAct / Plan-and-Execute |
| Level 3 | + 自我改进 | Reflexion / Multi-Agent |
深层感悟:我的实际体感是——大多数业务停在Level 2。Level 3的Reflexion看起来美好,但每次失败都要多花两三次LLM调用(评估一次、反思一次、检索经验一次),而经验库的收益要跑上几十次同类任务才显现。在调用次数有限、单次延迟敏感的场景里,这个账算不过来。
Day 2:Tool Calling工程化——工具不是函数,是产品
五原则与Schema四要素
Week 3我给工具加个@Tool就完事了。这一天的核心认知是:工具描述的质量直接决定Agent的决策质量,因为Schema是模型理解工具的唯一途径。
// 坏Schema:模型不知道query该多长,也不知道limit的上限
@Tool("搜索")
String search(String query, int limit);

// 好Schema:把"给模型看的API文档"写全
@Tool("在知识库中检索相关文档片段")
String searchDocuments(
    @P("检索关键词,不超过5个词,不要写完整句子") String query,
    @P("返回条数,1-20,默认5") int limit
);
关键收获:写@P描述时我给自己定了个规矩——描述里必须写清"边界"和"反例"。"不超过5个词"比"关键词"有用得多,"仅支持只读操作,不要传DELETE"比"执行SQL"有用得多。这和给人写接口文档是同一件事,只是读者从人换成了模型。
错误三分法:临时重试、业务降级、系统熔断
工具调用会失败,但不同失败要区别对待:
| 错误类型 | 判定 | 处置 | 参数 |
|---|---|---|---|
| 临时错误 | 超时、限流、503 | 指数退避重试 | 100ms × 2^(n-1),最多3次 |
| 业务错误 | 参数非法、查无此单 | 不重试,直接降级返回 | 把错误原因回灌给模型 |
| 系统错误 | 下游长期不可用 | 熔断 | 失败率50%,滑动窗口10 |
long delay = 100L * (1L << (attempt - 1));       // 100ms, 200ms, 400ms
delay += ThreadLocalRandom.current().nextLong(50);  // 加抖动,防重试风暴
深层类比:这套分类和Java微服务里的重试治理是一模一样的。临时错误对应网络抖动,业务错误对应4xx不该重试,系统错误对应需要熔断的雪崩源。唯一的新东西是"降级返回值要回灌给模型"——传统服务降级返回的是兜底数据,Agent降级返回的必须是模型能理解的错误描述,否则它会以为调用成功了。
工具也要版本号:语义化版本 + ToolAdapter兼容层
工具一旦上线就会被多个Agent调用,改名和改参数都是破坏性变更:
| 变更类型 | 含义 | 调用方需要改吗 |
|---|---|---|
| MAJOR | 删除工具 / 改参数类型 / 改返回结构 | 需要适配 |
| MINOR | 新增工具 / 新增可选参数 / 新增返回字段 | 自动兼容 |
| PATCH | 修Bug / 优化描述 | 无需感知 |
工程挑战:ToolAdapter是这里的关键——它让老调用方继续用v1签名,内部转发到v2实现,做参数重命名和默认值填充。这和我们做API网关版本兼容的思路完全一致,只是兼容的对象从"下游服务"变成了"模型的调用习惯"。一个反直觉的点是:工具描述改一个字,也可能让模型行为大变,所以描述变更我一律按MINOR处理。
Day 3:Multi-Agent——Java生态的空白与机会
四模式 × 三通信:一张表选清楚
| 消息队列(BlockingQueue) | 共享状态 | 事件驱动(EventBus) | |
|---|---|---|---|
| 串行 | 强依赖、结果需逐步传递 | 简单,但需同步 | 少见 |
| 并行 | 独立任务,各自收件箱 | 需处理写冲突 | 并行触发后聚合 |
| 层级 | Supervisor下发、Worker回传 | Supervisor可见全局 | 事件广播给Worker |
| 混合 | 最灵活,调试最难 | 易出竞态 | 松耦合、可溯源 |
核心洞察:选型的两个判断点——有没有依赖决定了串行还是并行,要不要集中决策决定了层级还是去中心化。多数业务是"层级 + 消息队列"的组合:Supervisor做规划与验收,Worker之间通过消息传递,既有控制力又不至于让Supervisor成为性能瓶颈。
工程挑战:主流Multi-Agent框架全是Python
这是我这周最意外也最兴奋的发现:
| 框架 | 语言 | 编排模型 | Java SDK |
|---|---|---|---|
| CrewAI | Python | Role-Based,层级协作 | 无 |
| AutoGen | Python | 对话式,支持循环 | 无 |
| LangGraph | Python | 状态图,支持循环与持久化 | 无 |
工程挑战:三个主流框架,Java SDK一栏全是"无"。Java在做企业级Multi-Agent时,要么自己实现状态图,要么通过HTTP/gRPC去调Python服务。这当然是劣势,但换个角度——这也意味着Java侧还没有事实标准,谁先把工程化做扎实,谁就有机会定义它。而且Multi-Agent的难点从来不是图怎么画,而是消息契约、可观测、故障恢复这些"脏活",恰好是Java团队的强项。
自实现状态图:三I张Map + steps>20
没有框架就自己搭,核心是三I张Map:
private final Map<String, AgentNode> nodes = new HashMap<>();
private final Map<String, List<Edge>> edges = new HashMap<>();
private final Map<String, Function<AgentState, String>> conditions = new HashMap<>();

public AgentState executeGraph(AgentState state) {
    String current = "router";
    while (!"END".equals(current)) {
        state.merge(nodes.get(current).execute(state));

        String next = conditions.containsKey(current)
            ? conditions.get(current).apply(state)   // 条件边:如 reviewer 打回 coder
            : edges.get(current).get(0).target();    // 固定边

        current = next;
        if (state.incrementStep() > 20) {
            throw new IllegalStateException("步骤数超限,疑似死循环");
        }
    }
    return state;
}
关键设计:为什么三I张Map就够?因为业务图结构简单,不需要引入图数据库或DSL。真正有价值的是那条conditions里的回环边——reviewer可以打回coder重做,这才是Multi-Agent相比DAG流水线的本质区别:DAG只能往前走,Agent图能回退。而steps > 20是必须加的保鲜,回环边一旦条件写错就会无限循环。聚合结果时我用"加权 + 冲突检测",每个Agent输出带confidence,权重乘置信度后再由LLM做最终聚合。
Day 4:评估与可观测——让Agent的行为可被追问
四维评估与F1阈值0.8
Week 5评估的是RAG的答案质量,Week 6评估的是Agent的过程质量——多了两个维度:
| 维度 | 指标 | 阈值 |
|---|---|---|
| 任务完成度 | 成功率 / 准确率 / 步骤完整率 | >90% / >85% / >95% |
| 工具调用准确性 | 选择准确率 / 参数正确率 | >90% / >92% |
| Token效率 | 单次消耗 / 上下文增长 / 压缩率 | — |
| 响应延迟 | TTFT / 总时长 / 阶段分布 | P50<3s / P99<10s |
工具准确率用的是F1而不是准确率:precision = 正确调用 / 实际调用,recall = 正确调用 / 期望调用,F1 = 2PR/(P+R),阈值0.8。
关键收获:为什么不是准确率?因为漏调和误调的代价不对称,而且正样本稀少。一次任务里期望调3个工具、实际调了3个、其中2个正确——准确率是67%,但F1会把"漏掉的那一个"和"多调的那一个"都算进去。更实际的原因是,Agent经常什么都不调就直接回答,这时候准确率的分子分母都失去意义。
TracedAgent装饰器:零侵入埋点
可观测性最难的是"不想污染业务代码"。解法是装饰器:
public class TracedAgent implements Agent<String, String> {
    private final Agent<String, String> delegate;   // 被包装的真实Agent

    @Override
    public String process(String input) {
        Span span = tracer.startSpan("agent.execute");
        try {
            String result = delegate.process(input);   // 原样转发
            tracer.recordDecision(span, result);
            return result;
        } catch (Exception e) {
            tracer.logError(span, e);
            throw e;
        } finally {
            span.end();
        }
    }
}
设计哲学:为什么选装饰器而不是注解AOP?装饰器是编译期可见的强类型组合——你能明确看到哪个Agent被包了、包的顺序是什么,调试时调用链一目了然。AOP虽然零侵入,但切面失效时很难排查,而且在Agent这种"动态组装"的场景里,装饰顺序本身就是业务逻辑的一部分。
三支柱落地与Langfuse四层
| 支柱 | 落地方式 |
|---|---|
| 日志 | MDC结构化日志,自动脱敏 password / token / api_key |
| 指标 | Micrometer,publishPercentiles(0.5, 0.95, 0.99) |
| 追踪 | Span树,类型分 ROOT / AGENT_LOOP / LLM_CALL / TOOL_CALL / RETRIEVAL |
Langfuse把追踪组织成四层:Trace(一次完整请求)→ Span(一段逻辑)→ Generation(每次LLM调用,记录model与usage)→ Score(自动评分)。
感悟:调试Agent最大的障碍不是看不到日志,而是看不到"它当时为什么这么想"。所以我在Span里除了记录工具名和参数,还强制记录模型的决策文本(那句Thought)。多花几十个Token,换来的是出问题时能完整回放推理过程——这是Agent可观测性区别于传统APM的地方。
Day 5:MCP——AI应用的USB-C
从N×M到N+M:集成成本的量级下降
MCP(Model Context Protocol)要解决的问题很朴素:3个模型要用4个工具,硬编码就要写12个适配器;标准化之后,工具方实现4个Server、模型方接3个Client,总共7个。
硬编码集成:  3 模型 × 4 工具 = 12 个适配器
MCP 标准化:  3 模型 + 4 工具 = 7  个实现
深层类比:这就是USB-C。在USB-C之前,每种设备都要配一根专用线;之后,设备方和主机方各自遵循同一套规范,互不关心对方是谁。MCP的真正价值不是"又一个协议",而是让工具供给方和消费方解耦——Agent工程师的活儿从"写工具"变成"选工具、管工具、审工具"。
三层架构与四大概念
| 概念 | 是什么 | 谁来用 |
|---|---|---|
| Tools | 可调用的函数,带 name / description / inputSchema | 模型调用 |
| Resources | 可读的数据,带 uri / mimeType | 应用读取 |
| Prompts | 预置的提示词模板,带参数 | 用户或应用触发 |
| Roots | 可访问的目录边界 | 安全沙箱 |
协议跑在JSON-RPC 2.0上,当前版本2024-11-05,initialize / tools/list / tools/call 三个方法就够跑起来。
感悟:四大概念里我最看好Resources——它把"数据"和"工具"分开了。以前要让模型读一份文件,得写一个readFile(path)工具;现在文件是Resource,应用可以直接读出来塞进上下文,不需要模型绕一圈。少一次工具调用,就少一次出错机会和一笔Token。
Java侧现状:Spring AI原生,LangChain4j需自写DynamicTool
| 框架 | MCP Client | 动态增删工具 |
|---|---|---|
| Spring AI | 原生McpClient + McpToolCallbackProvider | 支持 |
| LangChain4j | 需自写DynamicTool适配 | 需自行实现 |
关键感悟:选型结论是——需要运行时动态增删工具的场景,Spring AI更省事;纯静态工具集、且已经在用LangChain4j的项目,自写DynamicTool也不是大事。但这里有个更值得注意的信号:MCP让"工具"从代码里的一个注解,变成了可以通过配置接入的外部服务,工具治理从此有了独立的一层。
Day 6:企业级智能客服——六天知识的总装
五条路径与14类意图
Day 6把前五天装进了一个智能客服系统。Router先识别意图,再决定走哪条路:
| 路径 | 触发条件 | 走哪个Agent |
|---|---|---|
| KB_ONLY | 产品咨询、正策问答 | KBAgent |
| TOOL_ONLY | 查订单、查物流 | ToolAgent |
| KB_AND_TOOL | 既要查资料又要查系统 | 两者并行 |
| TRANSFER | 投诉、情绪激动 | 转人工 |
| DIRECT | 打招呼、闲聊 | 直接回复 |
QueryIntent一共14个值,分四组:知识库类(PRODUCT_INFO / POLICY_QUERY / FAQ / HOW_TO)、工具类(ORDER_QUERY / RETURN_REQUEST / REFUND_STATUS / CHANGE_ADDRESS)、复杂类(COMPLAINT / SUGGESTION / COMPLICATED)、闲聊类(GREETING / CHITCHAT / UNKNOWN)。
深层感悟:14个意图看着多,但真正需要LLM判断的不到一半。"你好""谢谢"这种用正则就能挡掉,剩下的才交给模型。这和Week 5 Day 6的两级路由是同一个思路——把LLM用在刀刃上,本身就是最重要的成本优化。
双模型降本与Supervisor转人工三条件
// 贵模型做路由判断与最终把关,便宜模型做常规生成
@Bean ChatModel ch@tModel()     { return openAi("gpt-4-turbo",   0.7, 2000); }
@Bean ChatModel fastChatModel() { return openAi("gpt-3.5-turbo",  0.5, 1000); }
Supervisor决定转人工的三个条件,任一命中即转:全部来源置信度 < 0.5、命中负面情绪词(投诉、非常不满意、严重、强烈、太差)、质量检查未通过。
设计哲学:转人工不是失败,是产品契约的一部分。我的原则是"宁可多转,不可错答"——客服场景里,一次错误的退款承诺带来的损失,远超十次转人工的成本。所以阈值定得偏保守,而且转人工时必须带上完整上下文(对话历史 + AI已经做过的分析),否则用户要重述一遍,体验反而比纯人工更差。
我改的坑:一个漏掉的右括号,和一条"包含'无法'就转人工"的规则
先看第一个,一处编译都过不去的硬伤:
// 原文(Day6 L779):少了一个右括号
String allContent = results.stream()
    .map(PartialResult::content)
    .collect(Collectors.joining(" ");
第二个更隐蔽,是逻辑上能跑、但会持续误伤的那类:
// 原文(Day6 L829):包含任一关键词就判质量不合格
String[] rejectionPhrases = {"无法", "不知道", "不清楚"};
for (String phrase : rejectionPhrases) {
    if (answer.contains(phrase)) return false;
}
调试洞察:这条规则会把合法且诚实的回答全部误杀——"我无法确认库存,但可以帮您先下单,到货后优先发货"是一句很好的客服话术,却因为含"无法"被判不合格;同样,"这个参数我不清楚,我帮您查一下"也会被拦。更讽刺的是,这段代码自己的兜底文案就写着"抱歉,我无法准确回答您的问题"——它连自己都通不过自己的检查。
改法是让LLM判分当主判据,关键词只作为低置信度时的兜底:
private boolean passQualityCheck(String answer, String query) {
    double score = llmJudge.score(query, answer);     // 主判据:语义层面判断
    if (score >= 0.8) return true;
    if (score <= 0.4) return false;
    // 仅在模型也没把握时,才看是否有明确的拒答信号
    return !containsHardRejection(answer);
}
这提醒我一件事:用关键词判断语义,本质上是在用字符串匹配模拟理解。它在Demo里看起来很聪明,一旦上线遇到真实用户的多样表达就会频繁翻车。
Week 6复盘:三个核心突破
1. 从"能跑的架构"到"可选的架构"
Week 3我以为ReAct就是Agent的全部。这一周才建立起完整的选型观:有依赖的多步任务用ReAct,可并行的独立任务用Plan-and-Execute,对质量要求高且允许失败的用Reflexion,超出单Agent能力边界的用Multi-Agent。架构选择终于有了依据,而不是只会用锤子看什么都像钉子。
2. 从"能调的工具"到"可控的工具"
加个@Tool只是起点。真正让工具可托付的是四件事:Schema写成给模型看的API文档、错误按临时/业务/系统三分、语义化版本加兼容层、安全四层加可观测三支柱。这些没有一件是新发明,全是从Java后端搬过来的老经验——只是保护的對象从MySQL变成了模型调用。
3. 从"单兵作战"到"协作生态"
Multi-Agent让复杂任务可以拆分协作,MCP让工具接入从N×M降到N+M。但这一周最大的收获是一个判断:Java生态在Multi-Agent这块是空白。CrewAI、AutoGen、LangGraph全是Python,Java SDK一个都没有。这是劣势,也是机会——而填补它需要的是消息契约、可观测、故障恢复这些脏活,恰好是Java团队做了十年的事。
待解决的深层问题
1. Multi-Agent通信契约没有Java侧事实标准
我自实现的三I张Map能跑,但换个项目又要重写一遍。Agent之间传的是什么?是自然语言、结构化JSON,还是某种事件对象?失败怎么通知、结果怎么对齐、上下文怎么共享?这些问题在Python生态里也没完全解决,但至少有LangGraph这样的参考实现。Java侧连参考都没有。
2. 涌现行为的可预测性
层级架构里Supervisor还能控制全局,但Swarm这类去中心化架构靠局部规则产生全局行为——"涌现"听起来很美,工程上却是不可预测的同义词。怎么保证一群Agent不会一起跑偏?目前只能靠事后看Trace复盘,缺少运行时的约束手段。(Week 8 Day 1会再碰到这个问题。)
3. Agent评估的成本悖论
跑一次完整评估,消耗的Token比跑一次真实业务还多。工具选择准确率要人工标注期望工具集,答案质量要LLM当裁判,多维指标要跑几十个case。评估是为了省钱还是更费钱,取决于采样策略——但我还没找到既能保证统计显著性、又不燒钱的采样比例。
给同行者的建议
这一周最想分享的是:把Agent当分布式系统来写。
一开始我把Agent当成"会调API的对象",于是所有的坑都踩了一遍——工具没有幂等、错误没有分类、调用没有追踪、失败没有降级。后来我把它当成"一个由不确定组件构成的分布式服务",一切就顺理成章了:工具就是微服务,需要契约和版本;调用就是远程请求,需要重试和熔断;多Agent协作就是服务编排,需要可观测和幂等。
你不需要重新发明分布式系统的轮子,只需要认识到Agent就是一个分布式系统。
Week 6解决的是"怎么让Agent可控可协作",Week 7要面对的是另一件事——把这些散落各处的零件,收敛成一台敢上线的机器。
相关文章
- .net core利用PdfSharpCore操作PDF实例教程 09-16
- 使用.NETMAUI开发ChatGPT客户端的流程 09-16
- 手把手带你定制.NET 6.0的Middleware中间件 09-16
- 为 Agent 构建记忆能力:关键不是全量保存,而是精准召回 09-16
- 什么是JWT超详细讲解 09-16
- Java转向AI工程化第6周:构建可控、可协作的Agent 09-16