




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
Spring AI 实战:结构化输出与多模态能力详解
时间:2026-09-21 12:28:01 编辑:袖梨 来源:一聚教程网
大模型返回自然语言很方便,但一旦结果需要进入 Java 业务流程,自由文本就容易带来字段缺失、格式漂移和重复解析等问题;图片输入又会进一步增加模型与接口适配的复杂度。下面从 ChatClient 的实体映射入手,逐步梳理结构化输出的可靠性配置、多模态调用方式及实际使用边界。
本篇目标:让 ChatClient 的输出直接是 Java record(前端不用再正则解析 JSON),再让 AI 看得懂宠物的皮毛照片自动出初判结论。
技术栈:Spring AI 2.0 + Spring Boot 4 + JDK 21,文本模型 DeepSeek;多模态切换到 OpenAI 兼容的视觉模型
前置知识:《ChatClient & Prompt 篇》、《Function Calling》、《RAG & VectorStore》
01 一个反复出现的痛点:模型的"自由文本"进了 Java 就是场灾难
在前面的案例里,你已经见过让模型"输出症状单"的能力——
PetSymptom symptom = [email protected]()
        .user("...")
        .call()
        .entity(PetSymptom.class);    // 看似一行解决,但里面坑不少
当时只是轻描淡写地提了一句。这期我们把"让模型输出 Java 对象"这件事彻底讲透,再顺手把"让模型看图"也一并补上。
? 类比
模型的"自由文本回答"就像口述:生动、有温度,但没法被程序消费。 结构化输出是给口述配一位速记员——模型说的每句话都被实时整理成清单,代码可以直接遍历、存库、做判断。
多模态则是给口述配一台投影仪——模型不再只听你说什么,还能"看见"你拍的皮毛照片。
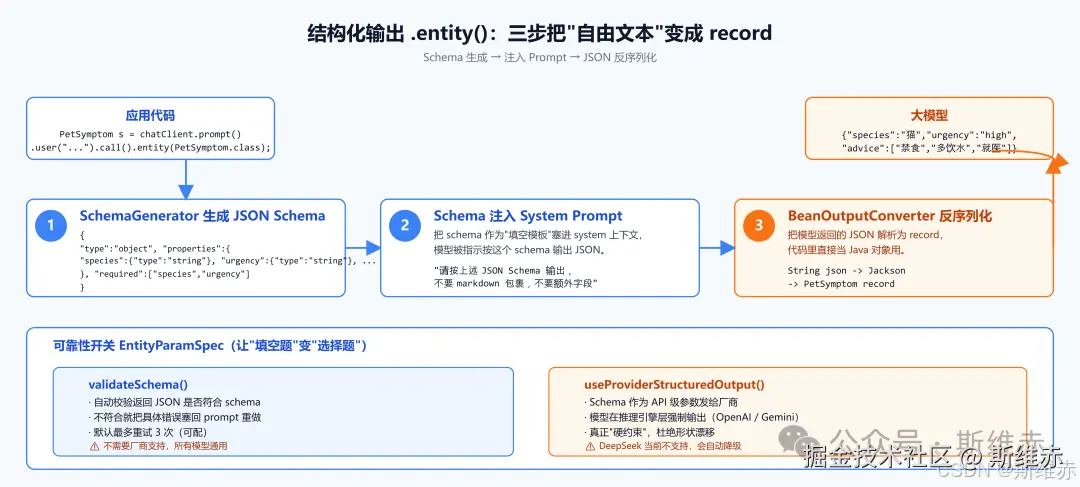
02 入门:.entity(Class),三步把"自由文本"变成 record
2.1 定义 record 作为目标类型
package com.pet.clinic.dto;

import java.util.List;

public record PetSymptom(
        String species,         // 物种:猫/狗/兔...
        String mainIssue,       // 主要症状描述
        String duration,        // 持续时间,如"3 天"
        String urgency,         // 紧急程度:low / medium / high
        List<String> advice     // 给宠主的初判建议
) {}
2.2 一次调用
PetSymptom symptom = [email protected]()
        .user("我家橘猫已经吐了 3 天,没精神,请给出症状摘要")
        .call()
        .entity(PetSymptom.class);
symptom.urgency() 就是 "high",symptom.advice() 就是一个 List<String>,直接可路由、可入库、可 if-else。
2.3 背后发生的三件事
| # | 框架做的事 | 作用 |
|---|---|---|
| ① | 用 SchemaGenerator 把 record 转成 JSON Schema | 给模型一份"填空模板",告诉它要输出什么字段、什么类型 |
| ② | JSON Schema 作为系统提示注入 prompt | 模型按模板生成 JSON,而不是"自由发挥" |
| ③ | 用 BeanOutputConverter 把模型返回的 JSON 反序列化为 record | 直接当 Java 对象用,不再 ObjectMapper.readTree(...) |
这一步对所有模型通用——不需要模型支持 OpenAI 的 response_format、不需要厂商提供"结构化输出"特性。缺点是软约束:模型被劝着"请按这个 JSON 输出",但没有强制,偶尔会多一个字段、少一个字段、或者包一层 markdown 代码块。
? 类比
这三步就像让模型做"语文考试中的填空题":题目(JSON Schema)写清楚要填哪些空、改卷人(反序列化器)按模板批改。但填空题毕竟不是选择题,学生还是可能答歪。
03 泛型:.entity(ParameterizedTypeReference)
.entity(Class) 只能处理"非泛型"——如果想要 List<PetSymptom> 或 Map<String, PetSymptom>,必须用 ParameterizedTypeReference(因为 Java 泛型擦除):
// 列表:一次给三个症状单
List<PetSymptom> symptoms = [email protected]()
        .user("请为常见的猫、狗、兔子各生成一条典型症状记录")
        .call()
        .entity(new ParameterizedTypeReference<List<PetSymptom>>() {});

// 映射:按物种分组
Map<String, PetSymptom> bySpecies = [email protected]()
        .user("请按物种给出 3 条症状记录")
        .call()
        .entity(new ParameterizedTypeReference<Map<String, PetSymptom>>() {});
一个小坑:泛型套泛型时,模型的 JSON 嵌套层数一多就容易出错。能扁平就扁平,能拆成两次调用就别硬塞。
04 可靠性开关:EntityParamSpec 让"填空题"变"选择题"
EntityParamSpec 暴露两个独立、可组合的开关,让结构化输出从"看模型心情"变成"程序可预期":
4.1 validateSchema() —— 自愈重试
开了这个开关,Spring AI 会自动校验模型返回的 JSON 是否符合 schema,不符合就把具体错误追加到 prompt 里,让模型重做(默认最多 3 次):
PetSymptom symptom = [email protected]()
        .user("...")
        .call()
        .entity(PetSymptom.class, spec -> spec.validateSchema());
错误信息长这样:"The required field
urgencyis missing"——把这条塞回 prompt,模型就明白"哦这次得补上"。
4.2 useProviderStructuredOutput() —— Provider 侧强制
开启后,schema 会作为 API 级参数发给模型厂商,由厂商在推理引擎层强制输出(OpenAI 的 response_format=json_schema、Gemini 的 responseSchema 等)。这是真正硬约束——模型不返回合法 JSON 都出不来。
PetSymptom symptom = [email protected]()
        .user("...")
        .call()
        .entity(PetSymptom.class, spec -> spec.useProviderStructuredOutput());
4.3 两个都开,暴力解决"形状漂移"
PetSymptom symptom = [email protected]()
        .user("...")
        .call()
        .entity(PetSymptom.class, spec -> spec
                .useProviderStructuredOutput()  // 第一道闸:厂商硬约束
                .validateSchema());             // 第二道闸:自动重试兜底
⚠️ DeepSeek 注意
useProviderStructuredOutput()要求模型厂商实现原生结构化输出。DeepSeek 当前 API 暂未支持 OpenAI 那套response_format协议——Spring AI 检测到不支持时自动降级为软约束。所以在你这套 DeepSeek 链路上,这个开关基本等同.entity(Class);要"硬约束"得换 OpenAI / Gemini 等支持原生结构的厂商。
4.4 速查表
| 你的需求 | 写法 |
|---|---|
| 多数场景,能用就行 | .entity(Type.class) |
| 需要 List / Map | .entity(new ParameterizedTypeReference<...>(){}) |
| 字段偶尔会缺 / 多了字段 | .entity(Type.class, spec -> spec.validateSchema()) |
| 厂商支持原生结构化、要求 100% 合法 | .entity(Type.class, spec -> spec.useProviderStructuredOutput()) |
| 关键业务、不容许形状漂移 | .entity(Type.class, spec -> spec.useProviderStructuredOutput().validateSchema()) |
| 还要拿 token 用量 | .responseEntity(...)(同套重载) |
05 .entity() 为什么不能流式?.responseEntity() 的妙用
.entity()只能在 .call() 路径用,不能在 .stream() 路径用。原因简单而本质:
流式响应是逐 chunk 推的,每个 chunk 都不完整 JSON;类型解析需要完整 JSON。
所以如果你非要"流式地拿到结构化对象",没办法——只能 .call() 等完整结果。**stream() 注定是文本流**。
但 .entity() 还有个同胞兄弟:.responseEntity(...),签名和 .entity 完全一致,只是返回 ResponseEntity<ChatResponse, T>,让你同时拿到解析后的对象 + 原始 ChatResponse:
ResponseEntity<ChatResponse, PetSymptom> result = [email protected]()
        .user("...")
        .call()
        .responseEntity(PetSymptom.class);

PetSymptom symptom = result.entity();
ChatResponse raw = result.response();
long totalTokens = raw.getMetadata().getUsage().getTotalTokens();
实战里这个特别有用:记 token 用量做计费、做坚控、做限流。
06 多模态:让模型"看见"宠物的皮毛照片
很多宠物场景缺不了"看图"——宠主发来一张猫皮毛的照片,"这是猫藓还是过敏?"。文本模型干不了这活,需要视觉模型。
6.1 Spring AI 多模态 API
Spring AI 的 UserMessage 设计得很干净:文本走 content,图片/音频/视频走可选的 media 列表。
// ① 底层 API
Resource photo = new ClassPathResource("/uploads/pet-skin-001.jpg");
UserMessage userMessage = UserMessage.builder()
        .text("请观察这张猫皮毛照片,判断是否有猫藓或过敏症状。")
        .media(new Media(MimeTypeUtils.IMAGE_JPEG, photo))
        .build();

ChatResponse response = [email protected](new Prompt(userMessage));
String result = response.getResult().getOutput().getText();
或者用 ChatClient 的 Fluent API 更顺:
// ② ChatClient 写法(推荐)
String result = [email protected]()
        .user(u -> u
                .text("请观察这张猫皮毛照片,判断是否有猫藓或过敏症状。")
                .media(MimeTypeUtils.IMAGE_JPEG, new ClassPathResource("/uploads/pet-skin-001.jpg")))
        .call()
        .content();
?
media只对UserMessage有意义
SystemMessage/AssistantMessage没有media字段(系统提示、模型回复都是纯文本)。多模态输出(让模型生图、生音频)也不走聊天路径,要用专门的ImageModel/SpeechModel,别想当然把图塞 Assistant。
6.2 实战:宠物皮毛初判接口
@PostMapping("/skin-check")
public SkinCheckResult check(@RequestParam("file") MultipartFile file) throws IOException {
    // 把上传的文件转成临时 Resource 交给 Spring AI
    Resource photo = file.getResource();
    String mime = file.getContentType() != null ? file.getContentType() : "image/jpeg";
    MimeType mimeType = MimeType.valueOf(mime);

    String text = [email protected]()
            .system("你是宠物皮肤科 AI 助理。基于图片做初判;不要替代兽医诊断,输出末尾必须包含「最终请以兽医面诊为准」。")
            .user(u -> u.text("请判断这张宠物的皮毛状况。")
                        .media(mimeType, photo))
            .call()
            .content();

    return new SkinCheckResult(text);
}
6.3 ⚠️ 选模型时绕不开的坑:DeepSeek hosted API 不收图片
| 厂商 | 模型 | 多模态 | Spring AI 接入 |
|---|---|---|---|
| OpenAI | gpt-4o / gpt-4-vision-preview | ✅ | spring-ai-starter-model-openai(换 base-url + model) |
| Anthropic | Claude 3.x 系列 | ✅ | spring-ai-anthropic |
| Gemini 1.5/2.x | ✅ | spring-ai-vertex-ai-gemini | |
| Mistral AI | Pixtral 系列 | ✅ | spring-ai-mistral-ai |
| Ollama | LLaVA / BakLLaVA / Llama 多模态 | ✅(本地) | spring-ai-ollama |
| DeepSeek(托管 API) | deepseek-v4-pro / deepseek-v4-flash | ❌ 暂不收图 | 仍可走 spring-ai-starter-model-openai,只是不能用 .media(...) |
OpenAI 兼容是一把双刃剑:换 base-url 就能切厂商,但某些厂商(DeepSeek、部分国产)只实现了对话兼容、没实现视觉兼容。
? 实战选型
要纯文本 + Function Calling + RAG → 继续用 DeepSeek
deepseek-v4-flash(便宜、量大、能用);要看图 → 临时把
base-url切到https://api.openai.com、模型名改gpt-4o-mini,其它代码一行不用改;要看得起 + 跑得起 DeepSeek-VL2 → 拉本地 vLLM,OpenAI 兼容端点对齐,模型名换
deepseek-vl2之类。
切厂商的成本 = 改两行 application.yml + 换 Key。这正是 ChatClient 抽象的红利。
07 结构化输出 vs Tool Calling:什么时候用哪个?
这是面试和实战都被反复问的问题。一张表说清:
| 维度 | .entity() 结构化输出 | @Tool 工具调用 |
|---|---|---|
| 目标 | 拿到一个结构化数据对象 | 触发一个应用侧动作 |
| 模型"动"了什么 | 没动任何东西,只返回数据 | 真正调用了你的代码(查 DB / 发请求) |
| 典型场景 | 工单分类、症状摘要、用户意图解析 | 查排班、下订单、发邮件 |
| Schema 强制方式 | JSON Schema(软约束 / Provider 硬约束) | 工具定义(本身就是结构化) |
| 能不能组合 | ✅ 在结构化输出的同时作为工具的输入 | ✅ 工具参数就是结构化对象 |
它们其实是一对搭档:
// 场景:让 AI 自己决定要不要"开处方"
// ① 结构化输出:先让 AI 理解病情,输出结构化的"处置建议"
PetSymptom symptom = [email protected]()
        .user("...")
        .call()
        .entity(PetSymptom.class);

// ② 工具调用:拿到 symptom 后,让 AI 决定是否调用挂号工具
if ("high".equals(symptom.urgency())) {
    String reply = [email protected]()
            .user("根据" + symptom + ",帮我挂一个今天的号")
            .tools(clinicTools)
            .call()
            .content();
}
也可以让模型一次完成(结构化输出 + 工具调用在同一轮)—— Spring AI 完全支持,只需在 prompt 里写明"如果 urgency=high 就调用 makeAppointment"。
08 总结
回头看阶段2 走过的路:
| 篇 | 解决的核心问题 |
|---|---|
| ChatClient & Prompt | 把"和模型说话"做成"写 Java 代码" |
| Function Calling | 让模型动手查系统 / 调接口 |
| RAG & VectorStore | 让模型带私域知识答问题 |
| 结构化输出 & 多模态 | 让模型说结构化的话 + 看见图 |
| 至此,"Agent = LLM + Prompt + Memory + Tools + RAG + 结构化 + 多模态"的所有零件你都拿到了。 |
下一阶段预告: LangChain4j架构学习
想继续的学习的点个【赞】和【收藏】让主编知道!
顺手点个【关注】,感谢各位学习路上的朋友。
相关文章
- 使用 Docker 部署 nanobot:从零搭建轻量个人 AI 助手 09-21
- 伴AI可信上下文实践:统一快照、可追溯 Wiki 与 Passkey 治理 09-21
- 两台机器部署 vLLM:何时需要接入 Ray? 09-21
- 一套API Key接入并切换多款海内外代码大模型 09-21
- AI时代如何学习:我的实践方法与思考 09-21
- Spring AI 实战:结构化输出与多模态能力详解 09-21