




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
AI Coding进入CD发布流程后,哪些环节能真正交给AI?
时间:2026-09-16 12:10:01 编辑:袖梨 来源:一聚教程网
CI通过、预发正常,并不代表代码进入生产后就一定可靠。真实用户、历史数据和业务风险会让上线发布比持续集成复杂得多。当AI Coding接入CD流程后,它可以承担任务跟踪、证据收集与故障修复,但涉及止损和放量的关键判断,仍需要明确的人机分工。
《AI Coding 工程化:从个人提效到组织升级》第 15 期
这个系列主要聊 AI Coding 怎样从个人工具进入团队研发流程。本期继续往上线发布走:代码进入生产以后,哪些事可以让 AI 继续做,哪些决定必须留给人。
前几期,我们先后把 CI 和测试闭环接进了 AI Coding。
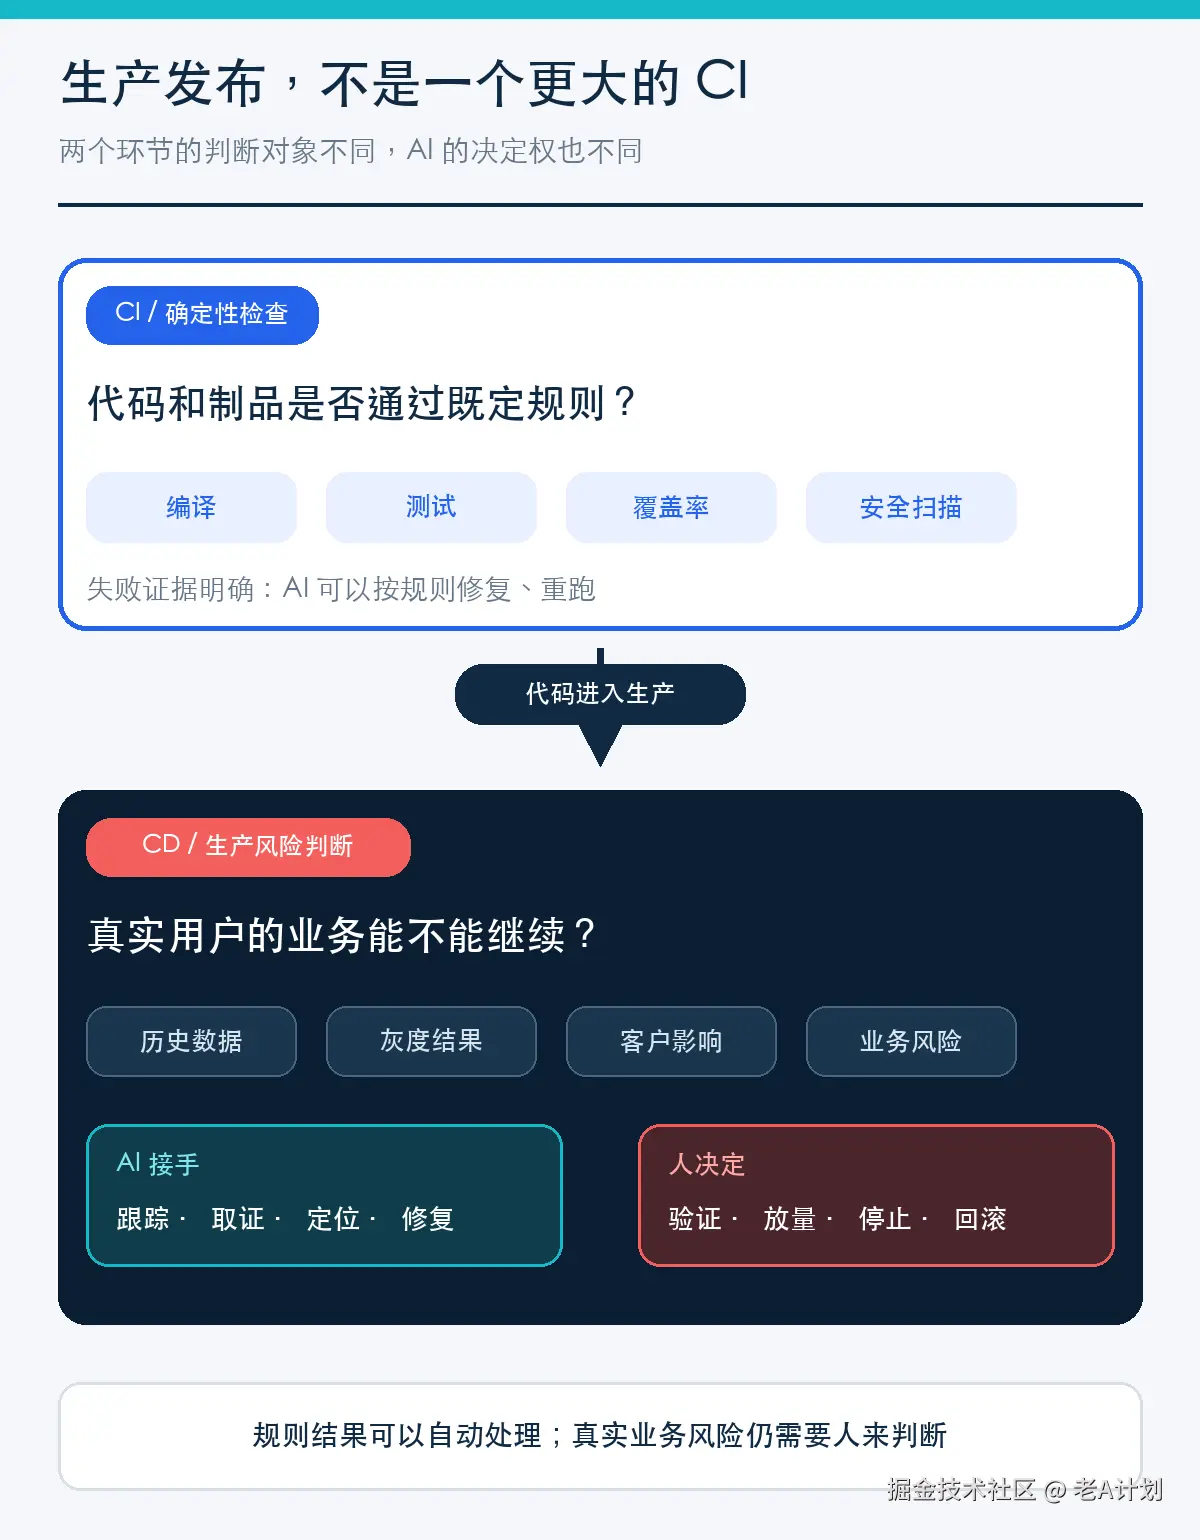
在这些环节里,大部分结果都是明确的:编译有没有通过,测试用例是成功还是失败,单测覆盖率有没有达到门槛。AI 拿到失败证据以后,可以修代码、重新验证。
代码合并以后,流程再往下就是上线发布。我们最开始也是顺着 CI 的思路往后接:既然公司已经有发布平台,那就封装一层 Skill,让 Coding Agent 能触发任务、查询状态、读日志和查数据。
做起来并不难。真正需要想清楚的是,生产发布不是一个更大的 CI。
CI 主要回答“代码是否通过了既定规则”;上线发布还要面对真实用户、历史数据和业务结果。灰度出了异常,是继续放量、暂停观察,还是马上回滚,错一次就可能影响真实客户。
所以这一期我想讲的,不再是怎么给 AI 多接几个操作,而是它进入生产发布以后,到底能接走哪些工作,决定权又该留在谁手里。
一次老用户灰度,把这条边界暴露得很清楚
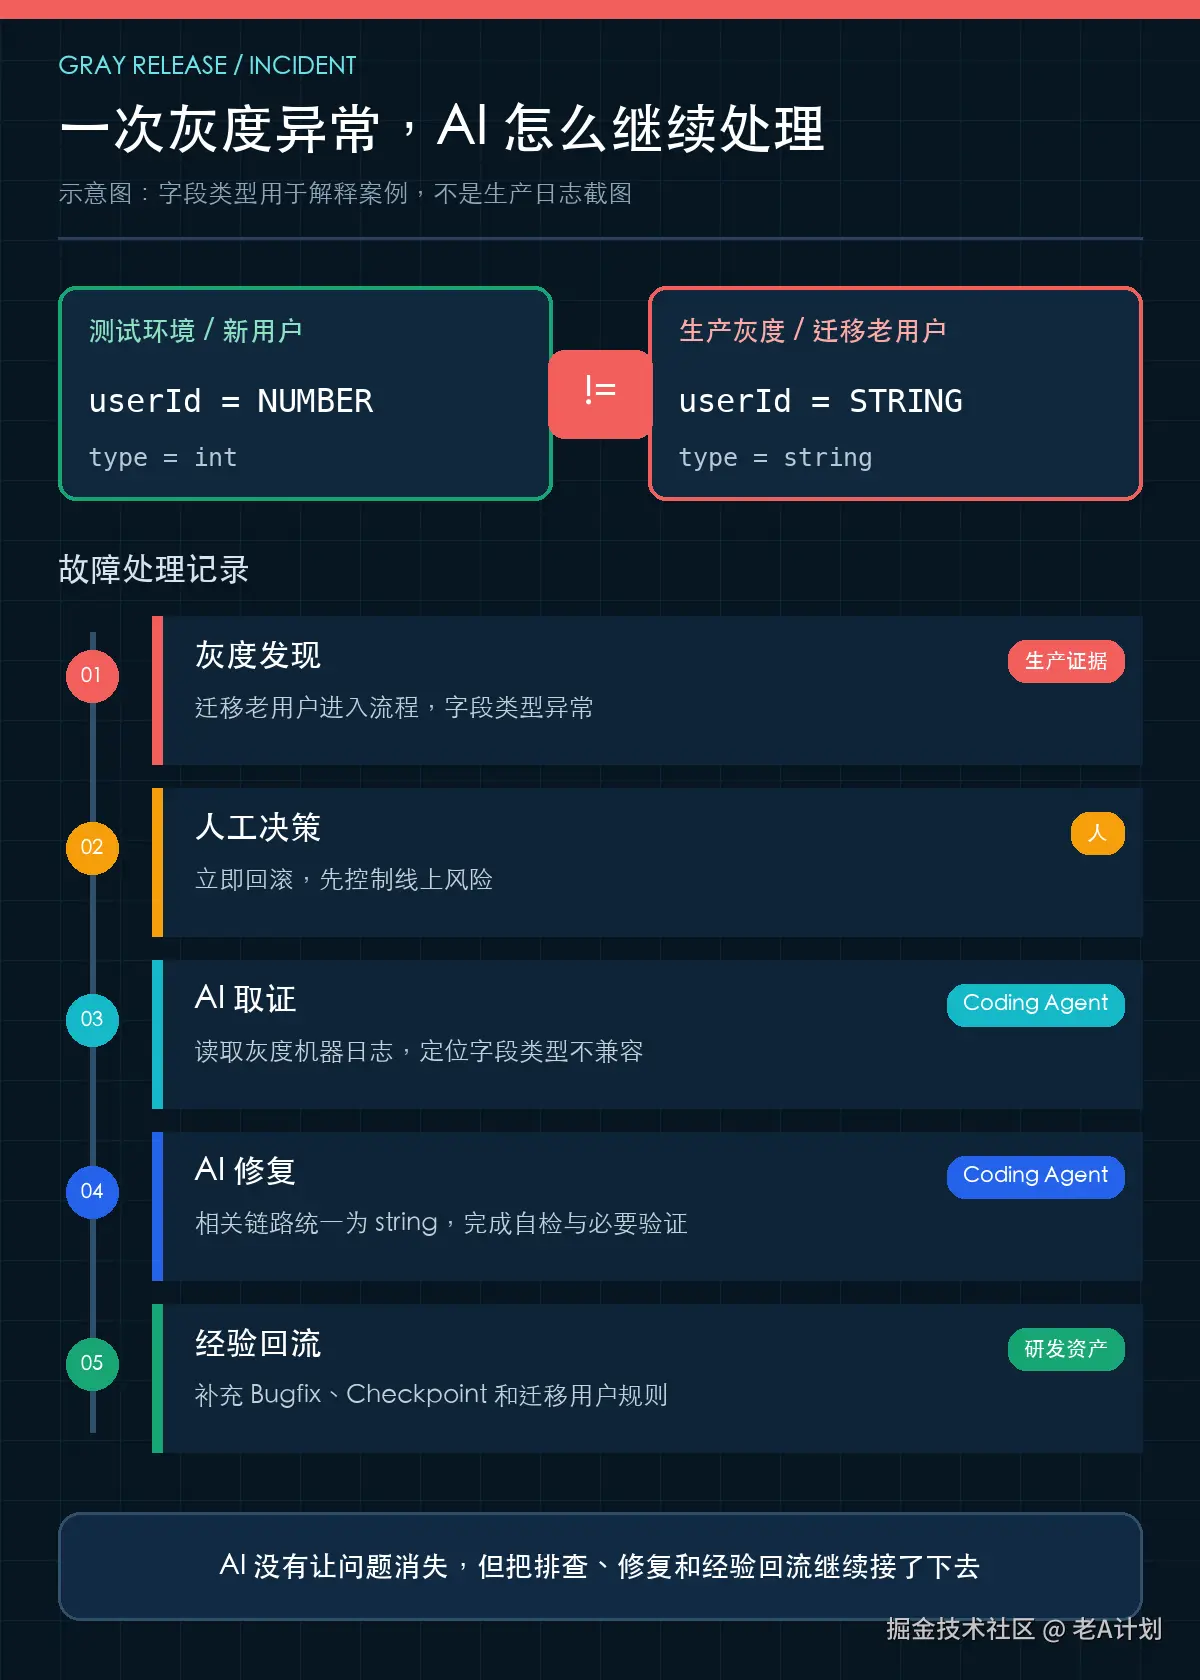
我们有一个系统,早期从老系统迁移过一批用户。这批数据里的 userId 是字符串,后来新增用户的 userId 都是数字,测试环境里也只有新数据。
所以很多新代码一直按照 int 处理,以前也没出过问题,因为那些功能只服务新用户。
后来做了一个新需求,实际覆盖范围包含迁移老用户。AI 看了现有代码和测试数据,继续把 userId 当成 int。编译、测试和预发回归都没问题,CI 也全绿。
到了生产灰度,正好有一个迁移老用户跑进来,而且还是产品自己的账号,整个流程当场报错。
如果没有这个账号碰巧跑到灰度,这个 Bug 可能要过很久才会被发现。
但是在当时,先做什么没有什么可讨论的:人工马上回滚。
用户流程已经失败,先把线上风险控制住,没有必要等 AI 查完原因再决定。人已经在发布平台上,直接点回滚也比再向 Coding Agent 发一条命令更快。
回滚之后,问题处理再交给 Coding Agent。它读取灰度机器的日志,很快定位到 userId 的类型不兼容,然后把相关链路统一调整为 string,完成自检和必要验证,再回到发布流程。
用这次故障来看,AI 和人分别该管什么
这次灰度里,AI 不是没帮上忙,人也不是只在最后兜底。他们处理的是两类不同的问题。
| 阶段 | AI 与人的分工 |
|---|---|
| 准备 | **AI:**执行平台检查,按指令触发任务。**人:**结合业务和团队安排,决定什么时候发布。 |
| 灰度 | **AI:**查询进度,通知关键节点。**人:**验证真实业务流程,因为平台成功不等于客户的事情办成了。 |
| 异常 | **AI:**保留任务上下文,准备日志和数据证据。**人:**根据真实用户和业务风险,决定停止、回滚还是继续观察。 |
| 修复 | **AI:**查日志、查数据、定位问题、修代码并自检。**人:**确认修复结果,承担再次放行的责任。 |
这张表里最重要的,是把“执行和诊断”与“业务决策”分开。
AI 可以替人盯任务状态,也可以把日志、数据和代码放在一起查问题。但灰度是否通过,不是只看系统有没有报错,还要看客户的流程有没有跑通,业务结果对不对,风险能不能接受。这些目前仍然需要人来判断。
这也是 CD 与 CI 很不一样的地方。CI 失败了,Agent 可以按照规则修复后重跑;生产灰度出现异常,要先由人判断是否立即止损,然后再让 AI 沿着证据链继续工作。
接入省下来的,是问题发生后的“重新接管”
如果只看动作数量,这次灰度里人工做的事情仍然不少:产品验证了真实流程,发现异常后有人点了回滚,修复完成以后还要重新验证和放量。
这些工作并不应该为了“全自动”强行去掉。
接入后减少的,主要是问题回到开发以后的那段时间。
以前回滚后,开发人员要重新打开需求和代码,找灰度机器,复制日志,再到数据库里查用户状态。如果不是当时那个开发来处理,还要先花时间理解这次改动。
Coding Agent 还在同一个任务里,手上有需求、设计、代码和测试记录,再通过 Skill 取回生产证据,可以直接接着往下查。
所以,对这套接入,我更看重的是:生产暴露问题以后,是不是还要把整个任务重新交给人,还是 AI 能带着原来的上下文继续查、继续修。
至于发布按钮是人点还是 AI 点,并不重要。
代码修好了,这个坑也要留下来
这次问题修完以后,我们没有只留一个代码提交。
Bugfix Skill 会在需求过程文档中记录问题、原因和处理结果,Checkpoint 也会留下这次修复的状态。“迁移老用户的 userId 是字符串”这条规则,经过人工确认后也会补进项目知识库。
这样下一次需求再涉及同一批用户,Coding Agent 就有机会在需求澄清、设计和测试阶段提前拿到这个条件,不用再等生产灰度来提醒一次。
项目知识不可能一上来就写全。我们更实际的做法,是跟着真实需求、测试结果和生产反馈不断补充。代码修掉了当前问题,文档和知识库则帮下一次需求少踩一次同样的坑。
写在最后
回到开头的问题:AI Coding 接入上线发布,能接手到哪一步?
在我们现在的流程里,它可以执行平台检查、跟踪状态、通知节点,也可以在问题出现后查日志、查数据、修代码、做自检,最后把有价值的生产反馈留回文档和知识库。
发布时机、真实业务验证、放量和回滚,现阶段仍然由人决定。
这不是“全自动上线”,但它把代码合并以后最容易断掉的那段上下文接了起来:人先控制风险,AI 带着证据继续处理问题。老A觉得,这才是现阶段 AI Coding 进入生产发布最有价值的地方。
相关文章
- 为 Agent 构建记忆能力:关键不是全量保存,而是精准召回 09-16
- 什么是JWT超详细讲解 09-16
- Java转向AI工程化第6周:构建可控、可协作的Agent 09-16
- 文件监控 Agent 为何频频失灵:事件与动作层解析 09-16
- 从一句“支持语音识别”到可开发规格:用 AI 完善 PRD 09-16
- AI开发与成本告警,为什么应该配套使用 09-16