

平时做技术实践时,很多问题不是概念不会,而是细节没串起来。拿“.NET上位机踩坑:大小端和字节序”来说,它看着像小点,放到项目里常会牵出环境、配置、兼容性和维护成本。下面按实际采用顺序,把思路、关键写法和容易踩坑的地方讲清楚,便于大家直接对照操作。
前言
大家好,我是 wacky。
结合项目来看,今天聊个具体的坑——字节序和大小端。这坑我刚入行那会儿踩过,盯着采集上来的温度显示 1.347e-38,一度怀疑人生。
很多上位机新手有个错觉:从 PLC 把寄存器读上来,转换一下不就是个数了吗?实际上真没那么轻松。一个 32 位浮点数跨两个寄存器,中间隔着"大小端"和"字节序"两道关,任何一道没对齐,你看到的就是天书。
这个坑确实是.NET上位机开发里最容易让人懵的地方,核心问题就是 PLC和上位机的字节序不一致,导致读上来的浮点数完全不对。
理解这一步时,轻松说,大端(Big-Endian)是高位字节存低地址,像人写字;小端(Little-Endian)是低位字节存低地址,x86 架构默认这种方式。工控里 PLC 常用大端,而你的.NET 程序用 BitConverter 默认按小端解析,两边没对齐,数据就乱了。
理解这一步时,更麻烦的是,一个 32 位浮点数占 4 个字节、2 个 Modbus 寄存器,实际存在 四种字节顺序在这个场景下,,工控里用 ABCD、BADC、CDAB、DCBA 表示(A 是最高位字节,D 是最低位字节)。
一、大小端到底是什么
实际处理时,大小端(endianness)说的是:一个多字节的数,它的各个字节在内存里的存储顺序。
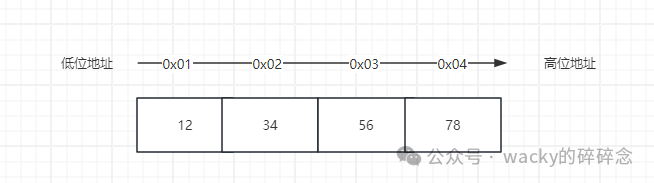
理解这一步时,大端(big-endian):也叫大端模式或者网络字节序,在大端模式中,数据的高位字节,存储在低位地址内,而低位字节,存储在高位地址内。
落到代码里,举个例子,现在有一个数字0x12345678,按照大端存储,那么就是高位字节0x12存储在低位地址,低位字节0x78存储在高位地址。
如图所示:
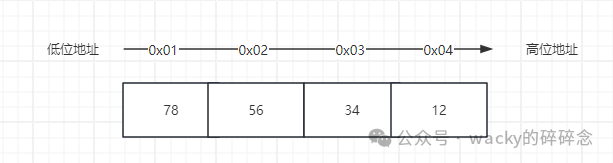
实际处理时,小端(little-endian):也叫小端模式或者主机序。小端模式和大端模式刚好相反,数据的高位字节在高位地址内,而低位字节,存储在低位地址内。
理解这一步时,继续以0x12345678为例,按照小端存储,就是低位字节0x78存储在低位地址,高位字节0x12存储在高位地址。
如同所示:
一句话总结:大端像人写字(高位先写),小端像 x86 存数(低位先放)。
理解这一步时,工控程序里真正的麻烦在于:PLC 用大端、上位机用小端是常态。你从 Modbus 把字节读上来,直接丢给 BitConverter.ToSingle,出来的往往不是原来的数——因为字节顺序没对齐,你必须按照PLC的大小端去解析。
二、工控用 ABCD / BADC / CDAB / DCBA 四种记号
结合项目来看,光说"大小端"还不够细。一个 32 位浮点数 = 4 字节 = 2 个 Modbus 寄存器,所以实际应用中还存在大端反转、小端反转的情况。所以其实有四种字节顺序,而工控领域习惯用四个字母描述这 4 个字节的顺序,记法固定——A 是最高位字节,D 是最低位字节:
using System.ComponentModel;
namespace BigAndLittleDian
{
    internal enum DataFormat
    {
        [Description("按照顺序排序")]
        ABCD = 0,
        [Description("按照单字反转")]
        BADC = 1,
        [Description("按照双字反转")]
        CDAB = 2,
        [Description("按照倒序排序")]
        DCBA = 3,
    }
}
大小端模式只是一种规定数据存储的字节顺序方式,在与不同的硬件进行通信时,上位机程序需要根据对方的大小端模式进行正确的解析和处理,而且不同类型的硬件大小端模式是在设计时已经确定,一般不会发生改变。
三、经典翻车现场:浮点数读成 1.347e-38
场景:PLC 那边把温度存成 32 位 float,占两个保持寄存器。比如地址 40001 是高字、40002 是低字(也可能反过来,这个和厂商有关)。
结合项目来看,你的.NET 程序从 Modbus 读到两个 ushort,随后 BitConverter.ToSingle 一转,期望得到 25.5。结果屏幕上蹦出来 1.347e-38,或者一个几万的数。
在这个场景下,为什么?因为 BitConverter 默认按小端(DCBA)解析。PLC 那边如果是大端(ABCD)或者字序有反转(CDAB),你直接 ToSingle,等于把字节全打乱重新拼,最后出来的结果当然不是原值。
实际处理时,当年我对着这个玩意儿纠结了半天,最后才发现是设备的字节序是 CDAB,而我按 ABCD 读了。差这一个字母,结果就天差地别。
四、C# 示例:四种顺序怎么转
核心思路:不管设备用哪种顺序存,先把读到的 4 个字节重排成 .NET 需的 DCBA(小端),再 ToSingle。下面我们能够定义一个函数,把四种情况一网打尽:
namespace BigAndLittleDian
{
    internal static class ReadAndWrite
    {
        // 从 2 个寄存器还原浮点数
        static float ReadFloat(ushort reg0, ushort reg1, DataFormat order)
        {
            byte[] raw = new byte[4];
            BitConverter.GetBytes(reg0).CopyTo(raw, 0);
            BitConverter.GetBytes(reg1).CopyTo(raw, 2);
            byte[] dcb = order switch
            {
                DataFormat.ABCD => new[] { raw[3], raw[2], raw[1], raw[0] },  // 大端
                DataFormat.DCBA => raw,                                      // 小端
                DataFormat.BADC => new[] { raw[2], raw[3], raw[0], raw[1] }, // 单字反转
                DataFormat.CDAB => new[] { raw[1], raw[0], raw[3], raw[2] }, // 双字反转
                _ => raw
            };
            return BitConverter.ToSingle(dcb, 0);
        }
        // 反过来:把浮点数按指定顺序写进 2 个寄存器
        static ushort[] WriteFloat(float value, DataFormat order)
        {
            byte[] dcb = BitConverter.GetBytes(value);
            byte[] raw = order switch
            {
                DataFormat.ABCD => new[] { dcb[3], dcb[2], dcb[1], dcb[0] },
                DataFormat.DCBA => dcb,
                DataFormat.BADC => new[] { dcb[2], dcb[3], dcb[0], dcb[1] },
                DataFormat.CDAB => new[] { dcb[1], dcb[0], dcb[3], dcb[2] },
                _ => dcb
            };
            return new[] { BitConverter.ToUInt16(raw, 0), BitConverter.ToUInt16(raw, 2) };
        }
    }
}
要点:不要靠猜,如果没有手册,那么就把四种组合都试一遍。PLC 里写的是123.45,分别用 ABCD / BADC / CDAB / DCBA 读,哪种正确就采用哪种,随后写进设置。
五、怎么更快判断是不是这个坑
几个典型症状:整数偶尔对、浮点必错 —— 基本就是字节/字序问题。
数值数量级完全不对:1e-38、1e+38、或者动辄几万 —— 字节被重排了。
排查办法很朴素:把原始的 4 个字节(或 2 个寄存器)借助日志打印出来,和 PLC 监控里的值对照,按 ABCD / BADC / CDAB / DCBA 四种组合算一遍,哪种对就能确定该采用哪种。
后记
落到代码里,字节序和大小端看似是个很小的知识点,实际上是上位机最经典的坑之一。它本质上是"你和 PLC 对数据格式的约定没对齐",就类似于我们Web前后端来开发接口,要约定好数据格式。我们把字节序的几种读取都封装好,把接口文档定义清楚,那么这个坑就填平了。
理解这一步时,踩坑系列虽然没有体系可言,但是每个问题深究起来确实也很有意思,也希望能帮助到正在学习或者已经入坑的你们,诸君共勉!
落到代码里,总的来说,.net大小端和字节序适合结合实际项目边做边理解。先抓住核心思路,再逐步补上细节和边界处理,最后效果会更稳定,也更容易复用。