最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
llm-from-scratch:AI Agent 工具实践指南
时间:2026-10-05 09:24:01 编辑:袖梨 来源:一聚教程网
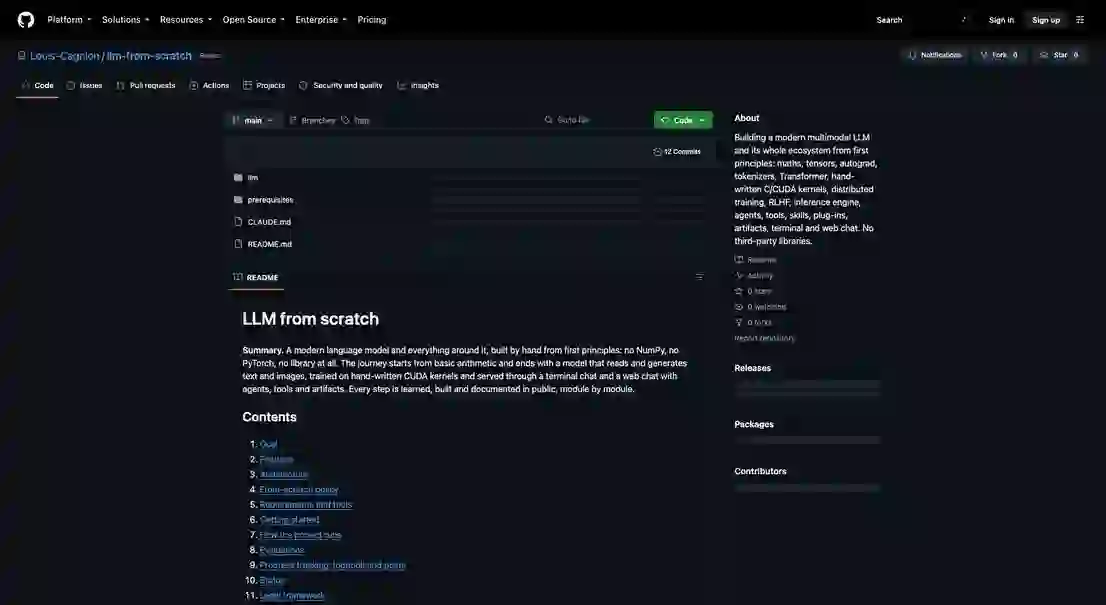
实际看llm-from-scratch,先要确认它的用途:从基本原理构建现代多模式 LLM 及其整个生态系统:数学、张量、autograd、分词器、Transformer、手写 C/CUDA 内核、分布式训练、RLHF、推理引擎等相关能力。部署与运行环境里,权限、依赖和环境差异会放大维护成本。我会在非生产环境复现一次安装与运行,检查依赖锁定、权限边界、日志、回滚和资源消耗。它适合愿意维护环境并重视故障恢复的工程团队;采用前仍要看维护状态和试跑结果。
LLM 从头开始
总结。 现代语言模型及其周围的一切,都是根据第一原则手工构建的:没有 NumPy,没有 PyTorch,根本没有库。该旅程从基本算术开始,以读取和生成文本和图像的模型结束,该模型在手写的 CUDA 内核上进行训练,并通过终端聊天和与代理、工具和工件的网络聊天提供服务。每一步都是公开地、逐个模块地学习、构建和记录的。
内容
- 目标
- 特点
- 架构
- 从头开始正策
- 要求和工具
- 入门
- 项目如何运行
- 评估
- 进度跟踪、日志和帖子
- 状态
- 法律框架
- 存储库布局
- 本项目中使用AI
- 贡献者
目标
获取从头开始编写、训练和服务现代语言模型所需的每一项技术知识,以便代码库可以在给定相同量的训练数据和计算的情况下遵循已发布的前沿模型配方。这项工作按顺序遵循两个学习计划:从零开始的 先决条件计划,以及从最基本的组件到最少组件构建完整堆栈的 LLM 计划。三个诚实的警告构成了这个目标:
- 封闭边界模型的具体配方并不公开。 LLM 计划涵盖了已发布的最新技术;达到前沿质量还需要数千个 GPUs 和大量人类反馈数据,该计划在扩展档案(模块 L69)中考虑了这些数据,而不是假装一台机器可以做到这一点。
- 一切都是在一台笔记本电脑 GPU 上小规模构建和验证的;分布式部件通过多个过程进行模拟,直到真正的硬件可用。
- 图像既是输入(理解屏幕截图、文档、照片)又是输出(通过扩散和原生图像标记生成);音频超出范围。
特点
完成的系统的作用是,LLM 计划模块中内置的每个功能都在括号中给出:
- 模型:具有旋转嵌入的纯解码器 Transformer、RMSNorm 和 SwiGLU (L14)、现代注意力变体、专家混合、状态空间层和长上下文(L30 到 L32)、图像理解(L64)和图像生成(L65、L66)。
- 训练:手写张量和自动微分(L02、L03)、带有手写内核的 C 和 CUDA 引擎,包括 FlashAttention(L16 到 L22)、混合精度和 8 GB 内存技术(L21、L22)、数据、张量、管道和带有手写集合的专家并行性(L35,L36),缩放法则(L38)。
- 数据:分词器 (L10)、压缩解码器 (L11)、TLS 1.3 客户端 (L39)、网络爬行和提取 (L40)、过滤、重复数据删除和混合 (L41)。
- 训练后:监督微调(L25、L52)、奖励模型和 RLHF(L54)、直接偏好优化和宪法 AI(L55)、推理强化学习(L56、L57)、工具使用(L58)、安全性(L59)、蒸馏为一系列模型大小(L60)。
- 推理:KV 缓存、连续批处理、分页注意力和前缀缓存 (L26)、量化 (L27)、加载已发布的开放权重模型 (L28)、结构化输出和推测解码 (L29)。
- 产品:消息API,具有流和令牌计费(L43)、会话、长对话历史记录和压缩(L45)、终端聊天(L46)、网络聊天(L47)、工件(L48)、工具、代理、技能和插件(L49至L51)、工作水平和模型类型(L61)、应用程序中的多模式输入和输出(L67)。
建筑
软件堆栈,从底层向上;每层仅使用其下面的层:
| 图层 | 组件 | 模块 |
|---|---|---|
| 数值核心 | 数学库、伪随机数、张量、自动微分、模块、优化器 | L01至L05 |
| 发动机 | CPU、CUDA 内核上的 C 引擎、GPU 训练后端、图形编译器 | L16至L22、L31、L34 |
| 数据 | Unicode 和正则表达式、分词器、压缩和数据格式、TLS 和 HTTPS、爬行、过滤、图像 | L09至L12、L39至L42、L63 |
| 型号 | Transformer 及其变体、专家混合、状态空间模型、视觉编码器、扩散模型 | L13至L15、L30至L32、L64至L66 |
| 培训 | 预训练、分布式训练、评估、训练后 | L23至L25、L35至L38、L52至L60 |
| 推理 | 推理引擎、量化、开放权重加载、结构化生成 | L26至L29 |
| 产品展示 | API 服务器、会话、终端和网络聊天、工件、工具、代理、技能、插件、工作量级别 | L43至L51、L61、L62、L67 |
每个算法组件都存在两次:一个纯 Python 参考,首先编写以理解它,以及一个 C 或 CUDA 版本以提高速度,始终根据参考进行验证。
从头开始的正策
规则:平台可以使用;堆栈的每个算法都是手工编写的。模块 L00 中编写的脚本会根据允许列表检查每个导入。
允许
- 平台:硬件指令和映射到它们的内在函数(AVX2,FMA,F16C; CUDA
__expf,PTX),操作系统(系统调用,来自os.urandom的熵),编译器和驱动程序。 - Python 管道:文件和进程(
os、sys、io、pathlib、shutil、tempfile、subprocess、signal)、二进制数据(struct、ctypes、mmap)、网络和并发(socket、select、selectors、asyncio、threading、multiprocessing)、端子(termios、tty)、工装(argparse、logging、unittest、time)、语言助手(dataclasses、typing、enum、functools、itertools)。 - C:标准库和POSIX(
malloc、pthread、mmap、套接字)。 - CUDA 工具包:
nvcc、NVRTC、运行时和驱动程序 APIs、仅包装硬件类型和指令的标头(cuda_fp16.h、cuda_bf16.h、mma.h、cooperative_groups、cuda_pipeline)、分析器(Nsight、NVTX)。 - 浏览器:HTML、CSS 和 JavaScript,因为它提供了它们。
- 数据:数据集和已发布的开放权重模型,由作者自己的代码加载;在真实集群上,RDMA 动词驱动程序接口。
- 测试预言机:外部程序运行一次以产生预期的输出,从不导入或链接。
手工重写,从未导入
- 每个第三方包:NumPy、PyTorch、JAX、SciPy、tokenizer、HTTP 和图像库。
- 实现堆栈算法的标准Python模块:
math、random、statistics、re、json、heapq、bisect、hashlib、hmac、secrets、base64、ssl、urllib、http、zlib、gzip、zipfile、sqlite3、unicodedata。 - C 语言:
libm(expf、logf、...)、BLAS、LAPACK、OpenMP 运行时、任何第三方库的软件函数。 - 在GPU上:cuBLAS、cuDNN、CUTLASS、CUB、Thrust、libcu++、cuRAND、NCCL、Triton。
- 在浏览器中:前端和CSS框架。
math.exp 等标准函数在测试中仍然可用,作为手写副本的参考。
要求和工具
- 操作系统:Linux(在Ubuntu 24.04上开发)。
- 语言和编译器:Python 3.12(仅限标准库)、GCC 12 和 Make、NVIDIA CUDA 工具包(
nvcc,安装在必备模块 SY03 中)。 - 其他工具:Git、Web 浏览器和用于
/professor会话的 Claude Code。 - 开发机器:NVIDIA GeForce RTX 3070笔记本电脑GPU(安培,计算能力8.6,内存8个GB),AMD Ryzen “Rembrandt”处理器(8 核、16 线程,AVX2、FMA 和 F16C,无 AVX-512),RAM 的 14 个 GB,大约 160 个 GB 的可用磁盘空间。一旦可以估计培训成本,租用云 GPUs 将在模块 SY05 中讨论并在模块 L38 中决定。
开始使用
- 克隆存储库:
git clone [email protected]:Louis-Cagnion/llm-from-scratch.git。 - 阅读 先决条件计划:其推荐顺序给出了第一个模块(MA01、MA02、MA03、IN01、IN02、 ME01)。
- 打开存储库根目录下的 Claude Code 并激活
/professor:Claude 读取 CLAUDE.md 和进度文件,然后提供下一个模块或其直接评估。 - 代码从 LLM 计划 的模块 L00 开始,该模块设置源布局、测试工具和策略检查;这个 README 然后记录了如何运行它们。
项目如何运行
- 顺序:先决条件计划优先,最终评估通过后才算完成; LLM 计划从最基本的模块到最少的模块,都有第一个工作文本模型,您可以在其 VI 部分的末尾与之聊天。
- 教学模式:所有工作都是用Claude Code以
/professor模式完成:解释、问题和渐进式提示,从来没有现成的解决方案。学习课程以法语进行;该存储库中的每个文档都是英文的。 - 实践:每个模块将理论与程序结合起来,以完成或从零开始编写,针对与模块评估不同的情况。
- 没有关于先验知识的假设:先决条件从算术开始。任何模块都可以通过直接评估来跳过,因此不需要任何假设,也不会在已经掌握的内容上浪费时间。
- 复习:在 LLM 计划的每个部分之前,对其所依赖的先决条件进行简短检查;差距会送回对相关模块的审查。
评价
- 模块评估:模块仅通过其评估来验证,评估以模块定义的格式(练习、推导、代码、解释)测试模块文件中列出的每项能力。 LLM 模块还需要可交付成果:作者编写的代码、通过的测试、报告的测量结果。
- 当场生成:评估练习是在评估时以
/professor模式创建的,从未提前编写,并对照练习日志进行检查。 - 绝不相同的练习:如果一个练习重复了先前的陈述,或者它的答案可以从先前练习的记忆中重现(具有相同值或相同上下文的相同结构),则该练习算作已经见过的练习。允许使用新的背景和新的价值观来测试相同的能力,以便必须再次计算出答案。
- 通过分数:100 %。失败的评估会导致有针对性的审查,然后根据新的练习进行新的评估。
- 直接评估:在启动模块之前,可以直接对其进行评估;通过它可以验证模块。在 LLM 计划中,它仅取代学习,而不取代可交付成果。
- 先决条件的最终评估:每个课程一次(数学多次),通过新练习至少测试每个模块的每个能力一次,每次课程 100%。复习失败后,单独重新参加新的练习;每次会议时都会进行最终评估。
进度跟踪、日志和帖子
progress/modules.md:经过验证的模块及其日期。progress/exercises/<module>.md:模块的每次学习和评估练习(日期、种类、能力、结构、背景和价值观),因此不会重复使用。logbook/YYYY-MM-DD.md:每个工作日一个文件,每个会话一个部分,针对组合:做了什么、如何做、阻止了什么、决定了什么、衡量了什么、学到了什么。每个条目均由 Claude 在会议中起草,然后由作者更正和验证。posts/:LinkedIn 后草稿,每个里程碑一个(验证模块块、训练第一个模型、测量结果),从日志中编写。
状态
两个计划均已设计(49 个必备模块,70 个 LLM 模块)。每个必备模块都有其详细的文件;接下来是 LLM 计划的模块文件。学习从先决条件的第一阶段开始。
法律框架
- 虽然该项目保持私有,但《EU AI 法案》(条例 2024/1689)没有任何规定:当模型或 AI 系统投放市场或投入使用时,其义务适用,并且不包括仅用于科学研究的工作。
- 一旦模型或聊天向其他人开放,用户必须被告知他们正在与 AI 系统对话,生成的图像必须带有机器可读的标记,并且通用 AI 模型的提供者承担文档和版权义务。
- 除了 10²⁵ 浮点训练运算之外,模型被认为会带来系统性风险,并承担更多职责。
- 训练数据提出了其自身的版权、许可和 GDPR 问题。
模块 L68 详细介绍了所有这些内容。
存储库布局
| 路径 | 内容 |
|---|---|
prerequisites/ |
先决条件计划及其模块文件 |
llm/ |
LLM 计划及其模块文件 |
progress/ |
经过验证的模块和练习日志 |
logbook/ |
组合的每日日志 |
posts/ |
LinkedIn 后草稿 |
src/, tests/, tools/, docs/ |
LLM 计划的代码、其测试、帮助脚本和技术文档(在模块 L00 中创建) |
CLAUDE.md |
克劳德代码课程说明 |
数据集和模型权重存储在存储库外部。
本项目中使用AI
Claude Code (Anthropic) 与作者一起设计了两个学习计划,并由独立的 Claude 代理人审查它们是否缺少主题和顺序错误;以/professor模式担任老师(讲解、提示、现场评价);并起草日志条目和帖子草稿,并由作者更正和验证。模型及其工具的所有代码均由作者编写。
相关文章
- moodle-quizsmith:AI Agent 工具实践指南 10-05
- margo:AI Agent 工具实践指南 10-05
- anima-prompt-naturalang:实践指南 10-05
- gemini-antigravity-cli:实践指南 10-05
- API-Sentinel:实践指南 10-05
- LangAlpha:AI Agent 工具实践指南 10-05