




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
AI Coding 接入企业内网:从浏览器 Token 过渡到官方 MCP 的权限治理
时间:2026-09-21 20:48:01 编辑:袖梨 来源:一聚教程网
当 Coding Agent 开始查询企业日志、数据库和内部知识库,登录身份就会成为绕不开的工程问题。团队既不能用一个高权限公共账号代替所有人,也不适合要求每位成员长期手工维护 Token。要让自动化真正落地,需要在接入方式、个人权限、平台审计和生产环境边界之间建立清晰规则。
《AI Coding 工程化:从个人提效到组织升级》第 16 期
这个系列主要聊 AI Coding 怎样从个人工具进入团队研发流程。上一期讲 Coding Agent 怎样进入上线发布;这一期继续往里走,看看它查询日志、数据库和内部文档时,身份与权限应该怎么接。
让 Coding Agent 查一次日志,最先卡住的往往不是模型,而是登录。
测试失败以后,它已经拿着需求、设计、代码和报错信息,下一步需要去日志平台找调用链,再到数据库核对状态。开发人员自己处理很简单,打开平台,登录,然后查询。
轮到 Coding Agent,问题就来了:它用谁的账号?能看哪些数据?Token 谁来维护?出了问题又算谁的?
最省事的办法,看起来是给它一个公共账号,权限尽量开大。另一个办法,是让每个使用者手工配置一遍 Token。
这两种我们都没有用在日志和数据库上。公共账号会混淆权限和责任,手工配置 Token 又会把使用门槛推给每个同事。
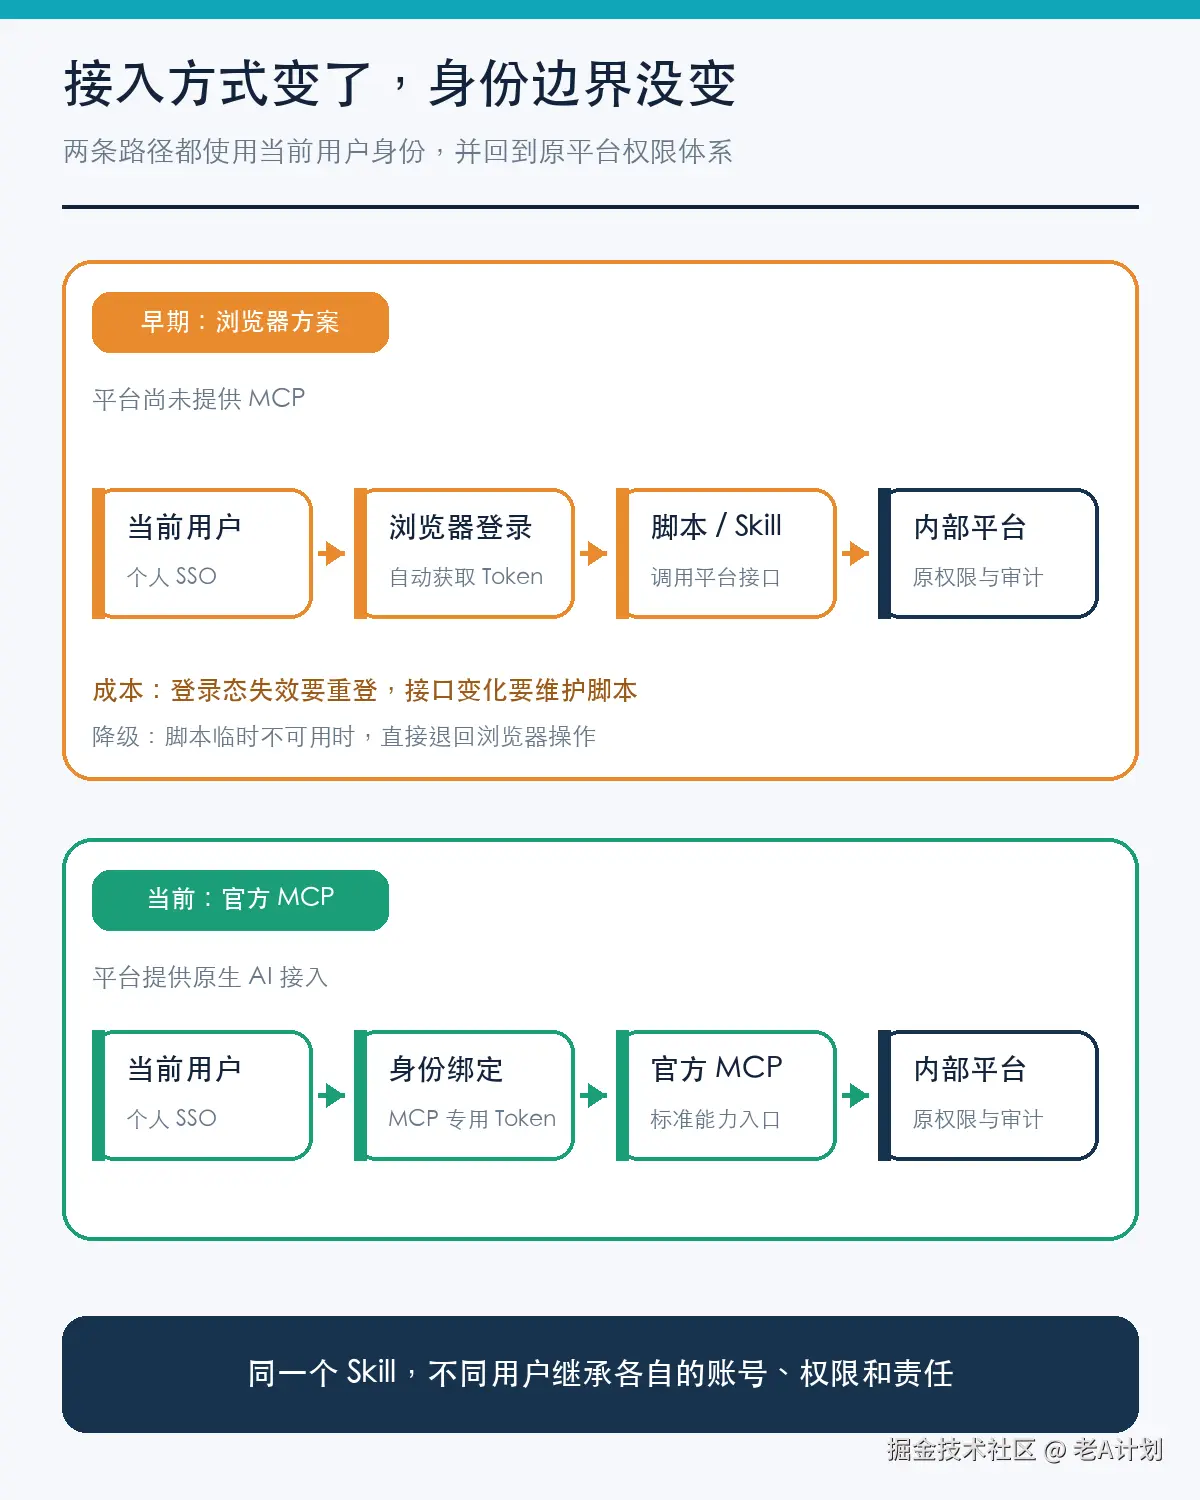
我们实际走过两条路:平台还没有提供 MCP(Model Context Protocol,模型上下文协议)时,先让 AI 操作浏览器完成 SSO(Single Sign-On,单点登录),自动获取 Token(登录令牌);平台后来提供官方 MCP,再逐步切到与个人账号绑定的标准接入。
接入方式变了,但有一件事从来没变:Coding Agent 能做什么,仍然取决于当前这个人原本能做什么。
平台没有 MCP,我们先让 AI 自己登录
早期很多内部平台都没有为 AI 提供专门入口。
为了让 Coding Agent 能查日志、查数据库,我们先让它操作浏览器,通过公司的 SSO 完成登录,获取当前登录态下的接口凭证,再由脚本调用平台接口。
这条路的好处很直接:不用等平台改造,也不用让每个同事先研究一遍接口。登录、查询和结果整理可以封装进 Skill,执行任务时自动完成。
Token 既可以提前配置,也可以临时获取。我们大多数时候选择自动获取,因为一旦要求每个人手工维护配置,Skill 的使用门槛马上就高了。
这套方案并不是在平台之外另开一条通道。**浏览器方案可以自动化登录和查询,但继承的仍然只是当前使用者原本拥有的权限。**一个人原本看不到某个项目的日志,换成 Coding Agent 以后依然看不到。
当然,它也有维护成本。
登录态有有效期,失效后需要重新登录;平台接口发生变化,脚本也要跟着调整。好在这类内部平台一般不会频繁改接口,即使脚本暂时失效,也可以让 AI 退回浏览器直接操作,只是速度慢一些,也会多消耗一些 Token。
浏览器 Token 能让流程先跑起来,但登录态和接口变化决定了它更适合作为过渡方案。
官方 MCP 出现以后,变化的不只是少写几个脚本
后来,日志、数据库等中间件平台陆续开始提供 MCP。
官方 MCP 的价值不只是少写几个脚本,而是把身份、权限和审计重新放回平台原生链路。
用户先通过 SSO 登录,平台提供一个专用于 MCP 的 Token,并与个人账号绑定。Coding Agent 再通过 MCP 调用查询能力,不需要自己适配每个页面和接口。
表面看,最大的变化是接入更方便、维护更稳定。但对企业来说,更重要的是身份链路终于回到了平台原生能力里。
同一个日志查询 Skill,不同同事使用时,看到的项目范围可以不同;同一个数据库查询能力,也会继续遵守各自原有的账号权限。查询由谁发起、能查什么、留下什么记录,平台都能沿用原来的安全和审计机制。
我们没有再为 AI 单独实现慢 SQL 控制、字段脱敏或者日志脱敏。原数据库平台会拦截慢 SQL,敏感字段本来就是脱敏的,日志平台提供的也是脱敏日志。
Skill 负责把能力接给 Coding Agent,安全边界仍由原平台负责。
如果为了接入 AI,又在外面复制一套账号、权限、脱敏和审计,不仅建设成本高,两套规则以后还可能不一致。官方 MCP 的价值,就在于不需要把这些已经成熟的能力重新做一遍。
公共账号不是不能用,要看它读的是什么
我们也不是所有地方都坚持使用个人账号。
像读取内部公共文档,团队成员看到的内容基本一致,也不涉及个人差异化权限,就可以使用公共账号。这样配置一次,大家都能使用。
日志和数据库不一样。不同项目、不同岗位能够访问的数据范围本来就不同,所以必须绑定个人账号。谁发起查询,就使用谁的权限,出了问题也由谁负责。
到了生产环境,我们通常只开放查询,不通过这类 Skill 做写入操作。生产修改仍然留在原来的研发和发布流程里,不会因为 Coding Agent 能调用工具,就顺手给它增加写权限。
公共内容可以共用身份,敏感系统必须绑定个人账号,生产写操作继续留在原流程里。
| 接入对象 | 使用身份 | 权限与控制 | 我们的处理 |
|---|---|---|---|
| 公共文档 | 公共账号 | 内容对团队一致 | 统一接入,减少重复配置 |
| 日志与数据库 | 个人账号 | 继承个人权限、脱敏和审计 | 同一 Skill,不同人拥有不同权限 |
| 生产写操作 | 不通过这类 Skill 开放 | 继续走原有业务与发布流程 | 不为了自动化扩大权限 |
这里真正要避免的,不是公共账号这三个字,而是为了省事,给 Coding Agent 一个所有人都能使用、又远超个人权限的“万能账号”。
两条路不冲突,可以按平台成熟度逐步演进
如果现在要给一个内部平台接入 Coding Agent,老A会按下面的顺序判断。
我们的选择顺序很清楚:官方 MCP 优先,浏览器 Token 过渡,浏览器直接操作兜底。
平台已经提供官方 MCP,就优先使用 MCP。身份绑定、权限、安全和审计都更完整,团队也不用长期维护浏览器脚本。
平台暂时没有 MCP,但已有稳定的 Web 界面和接口,就通过浏览器完成 SSO,自动获取 Token,再把查询能力封装成脚本或 Skill。它不如官方 MCP 稳定,但能让流程先跑起来。
脚本因为登录态或接口变化临时不可用,就退回浏览器直接操作。任务仍然能继续,只是效率和 Token 成本会差一些。
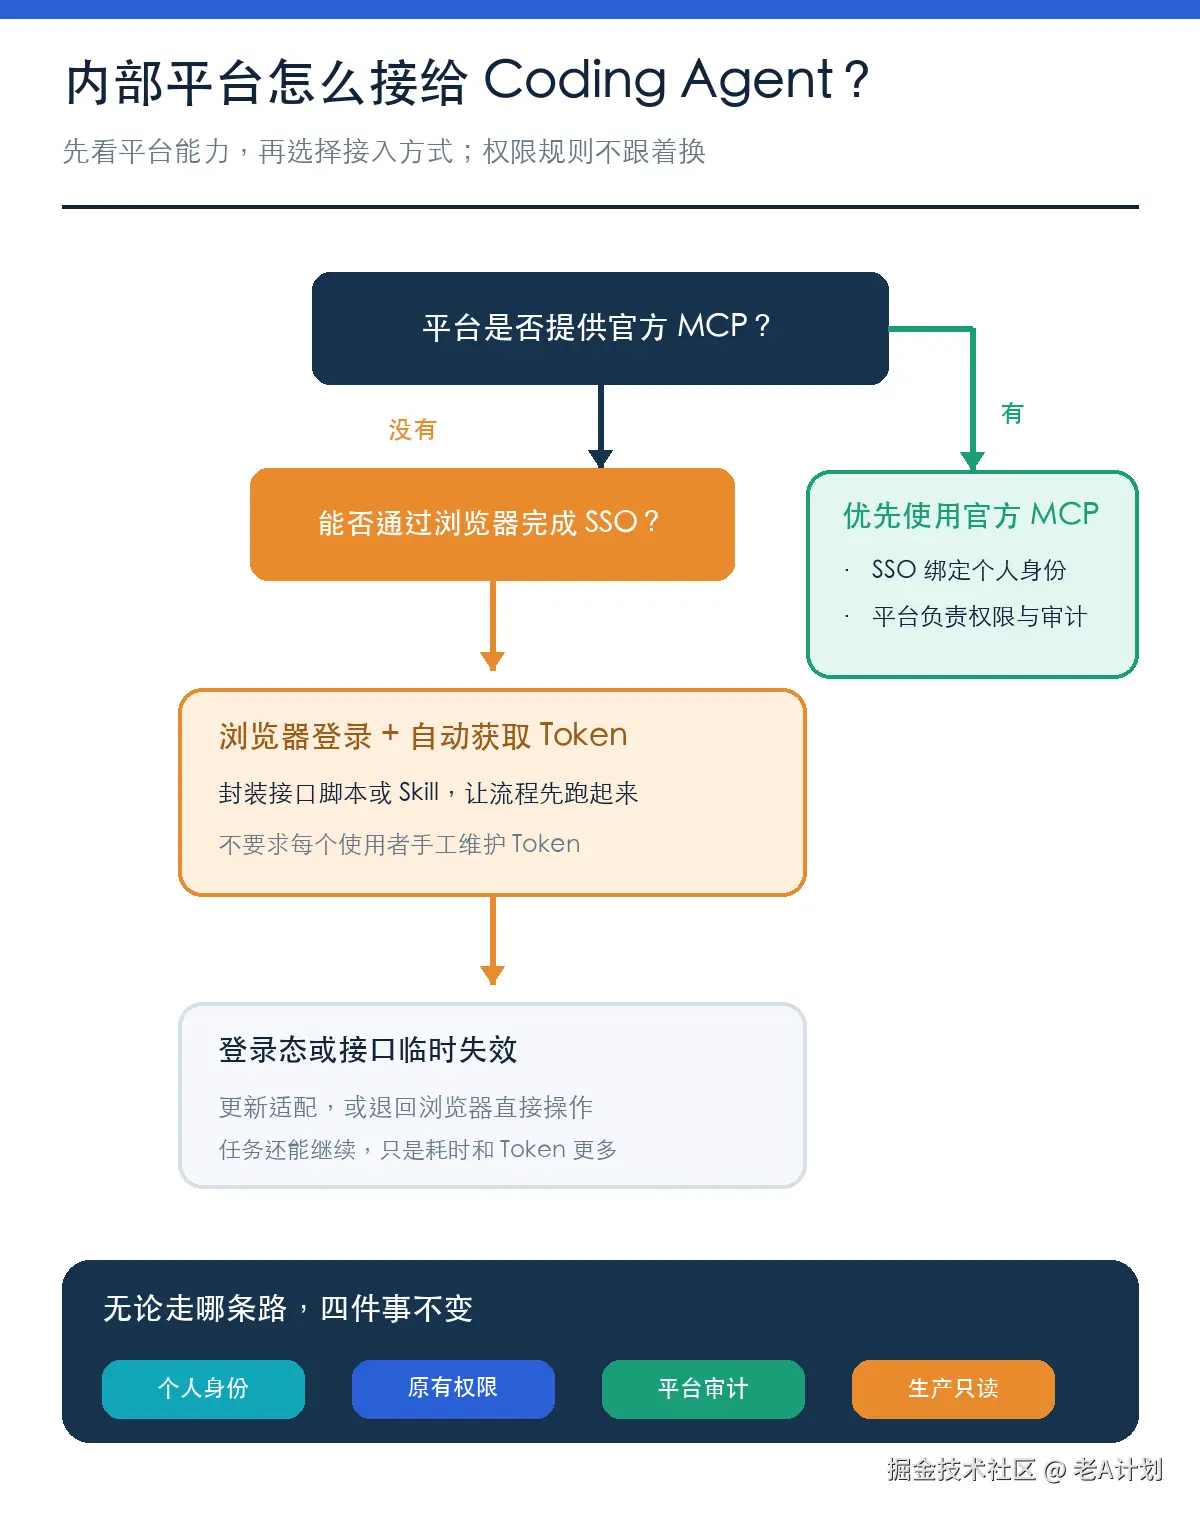
三条路径可以前后衔接。前一条暂时走不通,就向下退一级,先保证任务还能继续。
**认证和状态恢复应该由 Skill 自动处理,不能把 Token 配置成本推给每个使用者。**对团队成员来说,他只需要发起“查日志”或“查数据库”的任务,不应该先变成这套工具的运维人员。
写在最后
AI Coding 进入企业研发以后,迟早要接触日志、数据库、监控和内部知识库。只会读代码,它就很难独立完成测试、排障和修复闭环。
但接入内部能力,不等于给 Coding Agent 重新发一套更大的权限。
我们的做法,是在平台能力还不完整时,先用浏览器 SSO 和自动获取 Token 把流程跑通;平台提供官方 MCP 以后,再切回更标准、更稳定的身份链路。
接入方式可以不断演进,账号和权限仍然沿用原平台。公共内容可以使用公共身份,敏感系统绑定个人账号,生产环境默认只读,高风险写操作继续留在原来的流程里。
老A认为,这才是 Coding Agent 接入企业内网时最重要的边界:让 AI 获得当前这个人已经拥有的能力,而不是让它绕过这个人原本就要遵守的规则。