




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
用 RAG 扩展答疑机器人的知识边界
时间:2026-09-21 20:26:01 编辑:袖梨 来源:一聚教程网
大模型掌握的知识受训练数据和更新时间限制,面对企业内部资料或特定领域问题时,往往无法直接给出可靠答案。RAG 可以在生成回复前检索外部知识,将相关内容作为上下文交给模型。下面先拆解索引与检索生成的工作流程,再用 LlamaIndex 搭建支持索引持久化和多轮问答的机器人。
从 利用大模型构建答疑机器人 一文中了解到,RAG 可以有效扩展大模型的知识范围。那么下面来了解下 RAG 的工作原理,以及如何利用 RAG 技术使问答机器人能为我所用。
RAG 的工作原理
为了更好的理解什么是 RAG,可以想象这样一个场景:
我们在做这样一道小学数学题,有一张饼,切 3 刀,最多可以得到多少块?答案是 7 块。
那切 100 刀呢?如果忘记了切饼公式,很难想象要花多久可以算出来。但如果这时手边有一本数学参考书,经查询后,我们套入公式 (n^2 + n + 2) / 2 可以很快计算出结果。RAG 就可以充当参考书的角色。
类比到大模型也是如此,训练的数据中如果没有某个知识点(比如说公司使用的项目管理工具是什么?),直接向他提问相关问题会得不到准确答案。如果在大模型生成内容时,将相关上下文给它作为参考,那么大模型回答的准确率也将大大提高。
由此可见,上下文工程多么重要,它可以为大模型提供恰到好处的上下文窗口信息,为其完成特定任务提供参考。如果信息太少,模型还会一问三不知,如果信息太多或无关,模型的性能会下降,成本也会增高。
而 RAG,正是上下文工程中重要的一环,用来解决大模型训练知识不足的问题。RAG 应用通常包含建立索引、检索生成两部分。
建立索引
在查找“切饼公式”的过程中,你可能会先根据目录标记进行快速查找。类似,RAG 在回答前就做好了标记,这一过程叫做建立索引,它包括以下四个步骤:
-
文档解析
就像你会将书上看到的视觉信息理解为文字一样,RAG 应用也会将知识库文档进行加载并解析为大模型可以理解的文字形式。
-
文本分段
你通常不会在做“切饼”这一道题时,把整本数学书都翻一遍,而是去查找与问题最相关的几页。因此你会把参考书做一个大致的分段。类似的,RAG 也会在文档解析后对文本进行一个分段,便于后续能快速找到与问题最相关的内容。
-
文本向量化
在查找“切饼公式”的过程中,你会在参考书中找到与之最相关的段落,再去作答。在 RAG 应用中,通常需要借助 Embedding 模型分别对段落与问题进行数字化表示,在进行相似度比较后找出最相关的段落。数字化表示的过程就叫做文本向量化。
-
存储索引
存储索引将向量化后的段落存储为向量数据库,这样 RAG 应用就无需在每次进行回复时都重复以上步骤,从而可以增加响应速度。
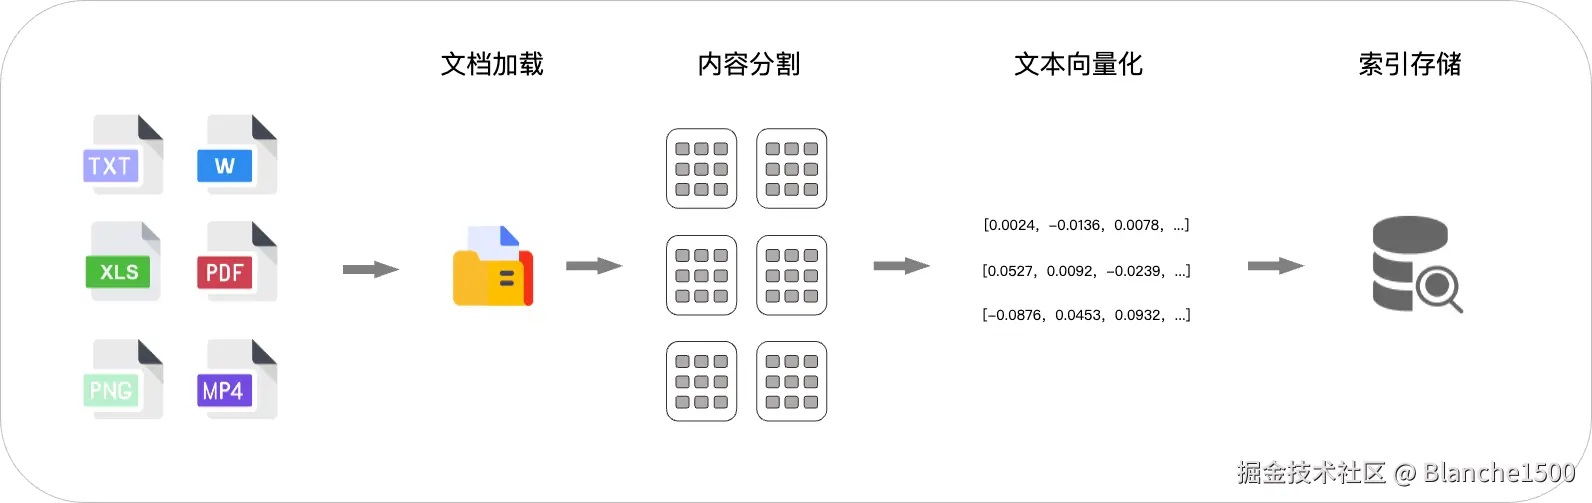
在建立索引后,RAG 应用就可以根据用户的问题检索出相应的文本段了。
检索生成
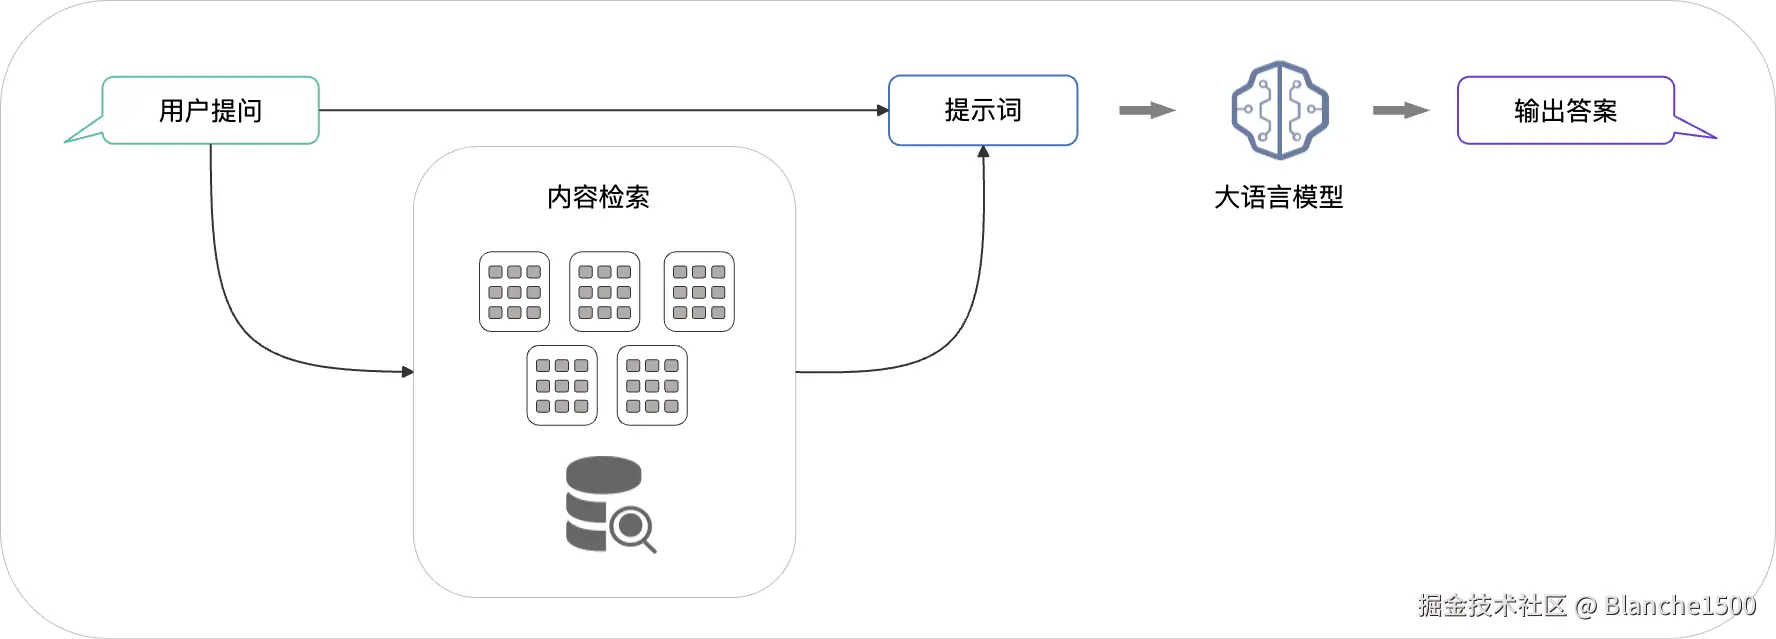
检索就像去参考书中查找公式的过程,生成则是找到公式后,根据公式和问题进行回答的过程。
-
检索
检索阶段会召回与问题最相关的文本段。通过 embedding 模型对问题进行文本向量化,并与向量数据库的段落进行文本相似度比较,找出最相关的段落。检索是 RAG 应用中最重要的环节,想象下,如果你找错了公式,那么给出的结果一定是不准确的。因而找到最匹配的内容是保证后续生成质量的第一步。
-
生成
在检索到相关文本段后,RAG 应用会将问题与文本段通过提示词模版生成最终的提示词,由大模型生成回复,这个阶段更多是利用大模型的总结能力。这个提示词模版的设计,是上下文工程中另一个关键环节。我们不仅要提供参考资料,还要明确指示大模型如何使用这些资料来生成答案。
## 创建 RAG 应用

借助 LlamaIndex,我们可以很快实现上述功能。

```Python
import os
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader, Settings
from llama_index.core.bridge.pydantic import PrivateAttr
from llama_index.llms.openai_like import OpenAILike
from typing import List, Any
from llama_index.core.embeddings import BaseEmbedding
from openai import OpenAI as OpenAIClient

api_key = os.environ.get("API_KEY")
base_url = "https://xxx"

# 自定义 Embedding
class ArkEmbedding(BaseEmbedding):
    _client: Any = PrivateAttr()
    _model: str = PrivateAttr()

    def __init__(self, model: str, api_key: str, base_url: str, **kwargs):
        super().__init__(**kwargs)
        self._model = model
        self._client = OpenAIClient(api_key=api_key, base_url=base_url)

    def _get_query_embedding(self, query: str) -> List[float]:
        resp = self._client.embeddings.create(model=self._model, input=[query])
        return resp.data[0].embedding

    def _get_text_embedding(self, text: str) -> List[float]:
        resp = self._client.embeddings.create(model=self._model, input=[text])
        return resp.data[0].embedding

    def _get_text_embeddings(self, texts: List[str]) -> List[List[float]]:
        resp = self._client.embeddings.create(model=self._model, input=texts)
        return [d.embedding for d in resp.data]

    async def _aget_query_embedding(self, query: str) -> List[float]:
        return self._get_query_embedding(query)

    async def _aget_text_embedding(self, text: str) -> List[float]:
        return self._get_text_embedding(text)

# 配置 Embedding
Settings.embed_model = ArkEmbedding(
    model="你使用的 embedding 模型",
    api_key=api_key,
    base_url=base_url,
)

# 配置 LLM
Settings.llm = OpenAILike(
    model="你使用的模型",
    api_key=api_key,
    api_base=base_url,
    is_ch@t_model=True,
)

# 建索引 + 查询
documents = SimpleDirectoryReader("./docs").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine(streaming=True)
response = query_engine.query("我们公司IT问题可以找谁?")
response.print_response_stream()
```

保存与加载索引
运行以上代码会发现,建立索引的过程很耗时。如果能将索引保存在本地,用到的时候直接加载索引,将大幅提升回复速度。
# 将索引保存为本地文件
index.storage_context.persist("knowledge_base/test")
print("索引文件保存到了knowledge_base/test")
# 将本地索引文件加载为索引
from llama_index.core import StorageContext,load_index_from_storage
storage_context = StorageContext.from_defaults(persist_dir="knowledge_base/test")
index = load_index_from_storage(storage_context,embed_model=ArkEmbedding(
    model="你使用的 embedding 模型",
    api_key=api_key,
    base_url=base_url,
))
print("成功从knowledge_base/test路径加载索引")
从本地加载索引后,测试看下是否可以正常提问:
print("正在创建提问引擎...")

query_engine = index.as_query_engine(
    # 设置为流式输出
    streaming=True,
    llm=OpenAILike(
        model="你使用的大模型",
        api_base="https://xxx",
        api_key=os.getenv("DAPI_KEY"),
        is_ch@t_model=True
        ),
    embed_model=ArkEmbedding(
        model="你使用的 embedding 模型",
        api_key=os.getenv("API_KEY"),
        base_url="https://xxx",
        )
    )

print("正在生成回复...")
streaming_response = query_engine.query('IT部门可以联系谁?')
print("回答是:")
streaming_response.print_response_stream()
RAG 多轮对话
from llama_index.core import PromptTemplate
from llama_index.core.llms import ChatMessage, MessageRole
from llama_index.core.ch@t_engine import CondenseQuestionChatEngine

# 定义问题改写的提示词模板
custom_prompt = PromptTemplate(
    """
    给定一段对话历史(人类与助手之间)和人类的后续问题,
    请将该问题改写为一个独立的问题,包含对话中所有相关的上下文信息。

    <对话历史>
    {ch@t_history}

    <后续问题>
    {question}

    <改写后的独立问题>
"""
)

# 模拟历史对话信息
custom_ch@t_history = [
    ChatMessage(role=MessageRole.USER, content="开发工程师有哪些细分类型?"),
    ChatMessage(role=MessageRole.ASSISTANT, content="开发工程师是综合性技术岗位。"),
]

# 创建查询引擎
query_engine = index.as_query_engine(
    streaming=True,
    llm=OpenAILike(
        model="你使用的模型",
        api_base="https://xxx",
        api_key=os.getenv("API_KEY"),
        is_ch@t_model=True
    ))

# 创建支持多轮对话的聊天引擎
ch@t_engine = CondenseQuestionChatEngine.from_defaults(
    query_engine=query_engine,
    condense_question_prompt=custom_prompt,
    ch@t_history=custom_ch@t_history,
    llm=OpenAILike(
        model="你使用的模型",
        api_base="https://xxx",
        api_key=os.getenv("API_KEY"),
        is_ch@t_model=True
    ),
    verbose=True  # 开启详细输出,可以看到改写后的问题
)

# 提问时只说「核心职责是什么」,不提及「开发工程师」
streaming_response = ch@t_engine.stream_ch@t("核心职责是什么?")
for token in streaming_response.response_gen:
    print(token, end="")