




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
性能、成本与部署:AI Agent生产化优化指南
时间:2026-09-17 09:30:02 编辑:袖梨 来源:一聚教程网
AI Agent 在演示环境中能够完成任务,并不代表它已经适合生产使用。多轮循环会放大模型调用延迟,长上下文与重复请求会持续推高费用,而部署方式又直接影响伸缩能力和运维成本。要解决这些问题,需要同时审视推理链路、预算护栏与基础设施架构。
第 23 章 性能、成本与部署
本章要解决的问题
Agent 每轮任务要花几块钱、响应要十几秒——性能和成本怎么平衡?生产部署用什么架构?
章节大纲
- 23.1 推理加速(缓存/量化/蒸馏)
- 23.2 Token 成本优化模型与预算控制
- 23.3 生产部署架构:无服务器/容器/K8s
- ? 解决方案:成本预算模板 + 延迟优化前后对比案例
23.1 推理加速
23.1.1 延迟从哪来:Agent 的"延迟"
Agent 慢不是一次调用慢,而是多次调用 + 串行循环的累积:
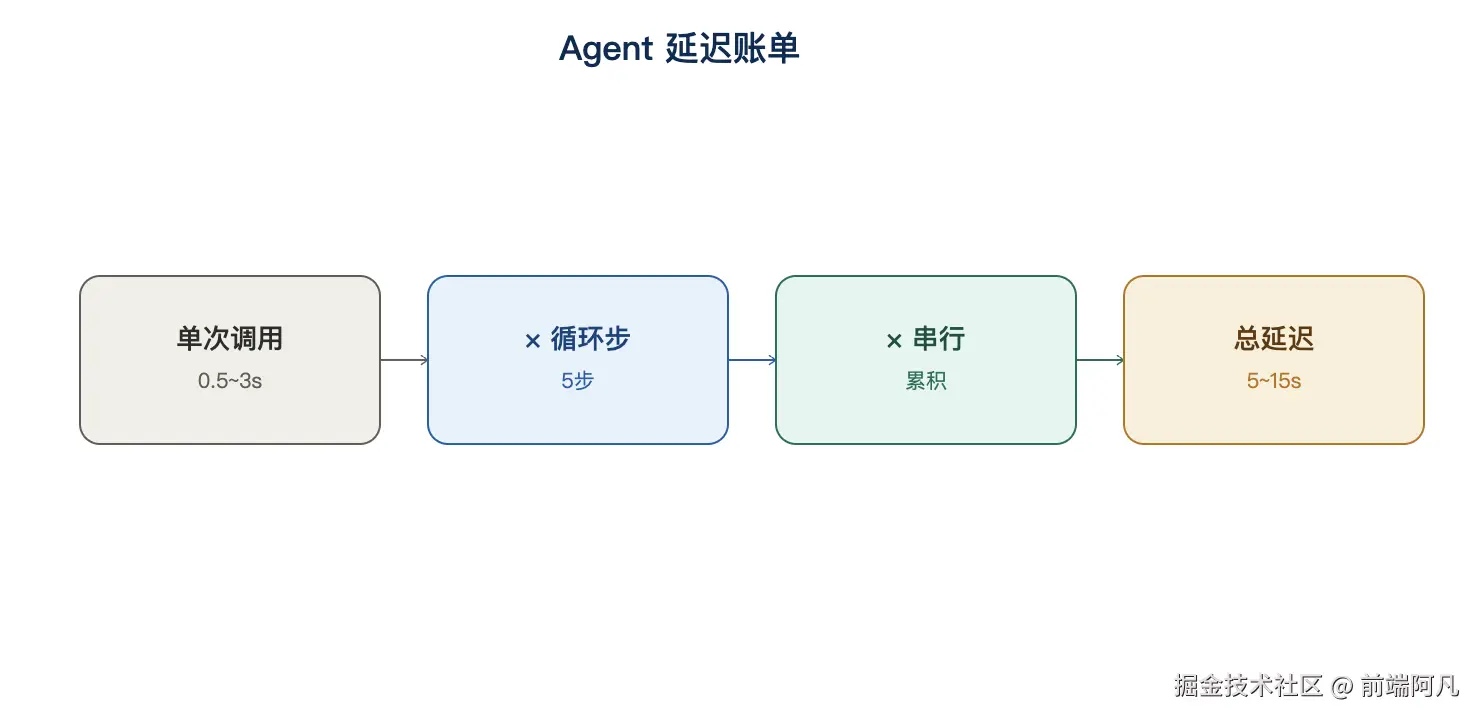
图 1:Agent 延迟
单次 LLM 调用:0.5~3s
Agent 循环 5 步:5 × (思考 + 工具) ≈ 5~15s
  ↑ 循环次数(第6章)是延迟的最大放大器
先减次数,再加速度——优化延迟的第一动作是减少不必要的循环步数(能一步完成别绕五步),然后才是单次加速。
23.1.2 推理加速手段(按成本递增)
| 手段 | 原理 | 加速效果 | 适用 |
|---|---|---|---|
| 流式输出(stream) | 首 token 即返回,边生成边展示 | 感知延迟大幅下降 | 交互场景 |
| Prompt 缓存(KV Cache) | 相同前缀复用计算结果(第 2 章 KV 缓存) | 长上下文省 50-90% 计算 | 固定系统提示词 |
| 小模型路由 | 简单任务走小模型(第 11 章模型路由) | 单次调用快 3-10 倍 | 简单子任务 |
| 并行化 | 独立子任务并发(第 12 章) | 总时长降到最慢分支 | 独立子任务 |
| 量化/蒸馏(私有化时) | 模型瘦身 | 通常 2-5 倍(视模型和硬件) | 自部署模型 |
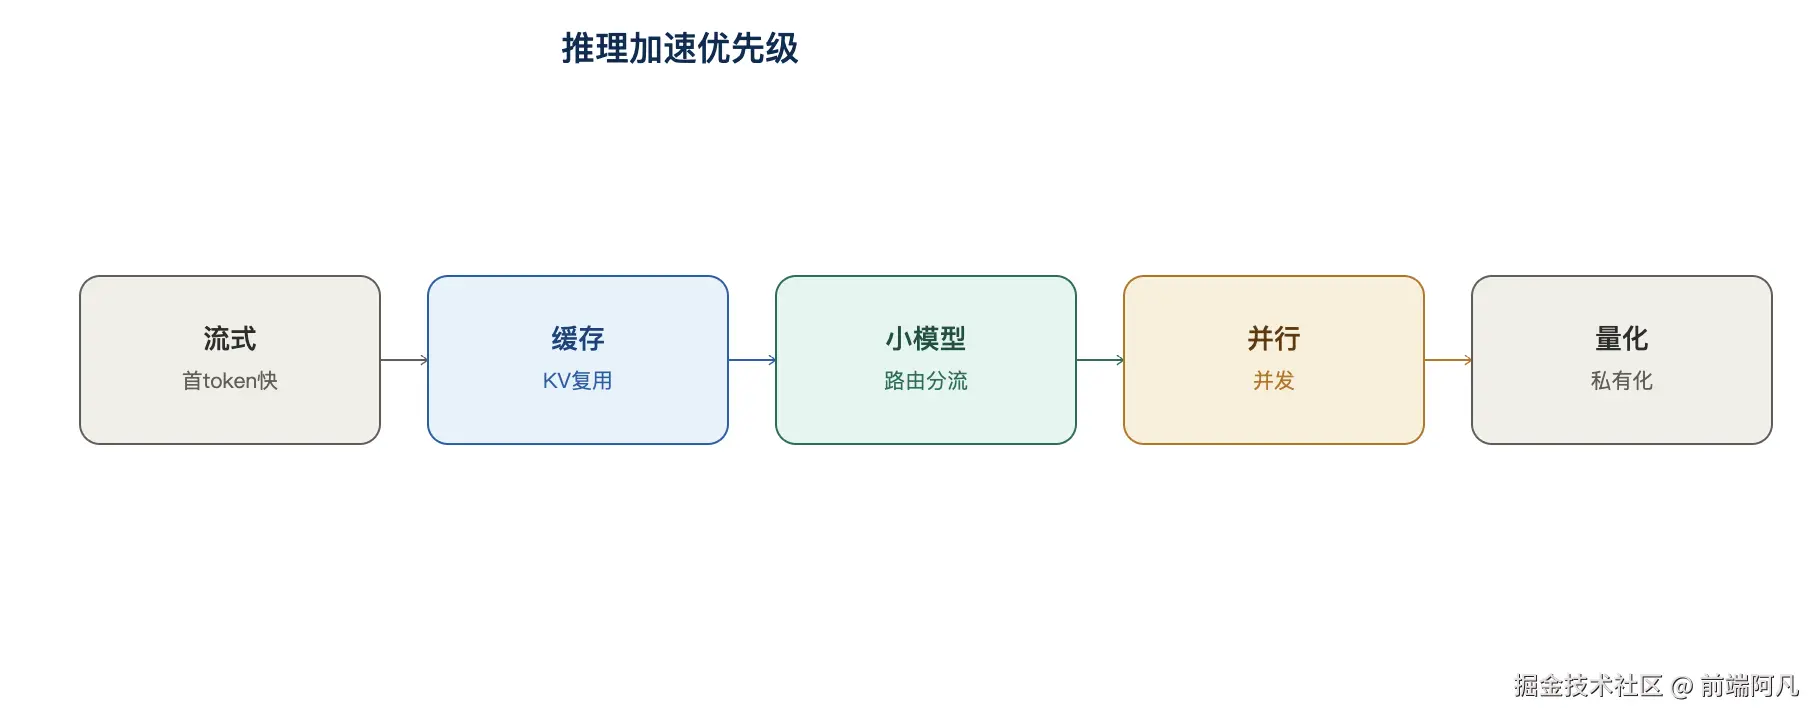
图 2:推理加速优先级
优先级排序:流式 → 缓存 → 小模型路由 → 并行化 →(私有化时)量化蒸馏。前四步不换模型就能做,性价比最高。
23.2 Token 成本优化模型与预算控制
23.2.1 成本公式:找到
单任务成本 = 单价 × (输入token + 输出token) × 调用次数
              ↑      ↑                       ↑
           模型定价  上下文长度(第3章)      循环步数(第6章)
三个,三个优化方向:
| 优化手段 | 呼应 | |
|---|---|---|
| 单价 | 小模型路由 / 批量折扣 | 第 11 章 |
| 输入长度 | 上下文压缩 / 按需投喂 / 缓存 | 第 3 章 |
| 调用次数 | 减少循环 / 无进展检测 / 结果缓存 | 第 6 章 |
23.2.2 成本优化的五个"金矿"
| 金矿 | 做法 | 典型收益 |
|---|---|---|
| Prompt 缓存 | 固定系统提示词开 KV Cache | 输入成本降 50-90% |
| 结果缓存 | 相同/相似问题命中缓存(第 24 章 C1/C2) | 高频问答零成本 |
| 小模型路由 | 简单任务走小模型 | 简单请求降 60%+ |
| 上下文裁剪 | 历史压缩 + 工具结果精简 | 输入降 30-50% |
| 循环收敛 | 停止条件 + 无进展检测 | 步数降 30-50% |
23.2.3 成本预算模板
上线前必须设预算护栏(呼应第 24 章 G5 预算封顶):
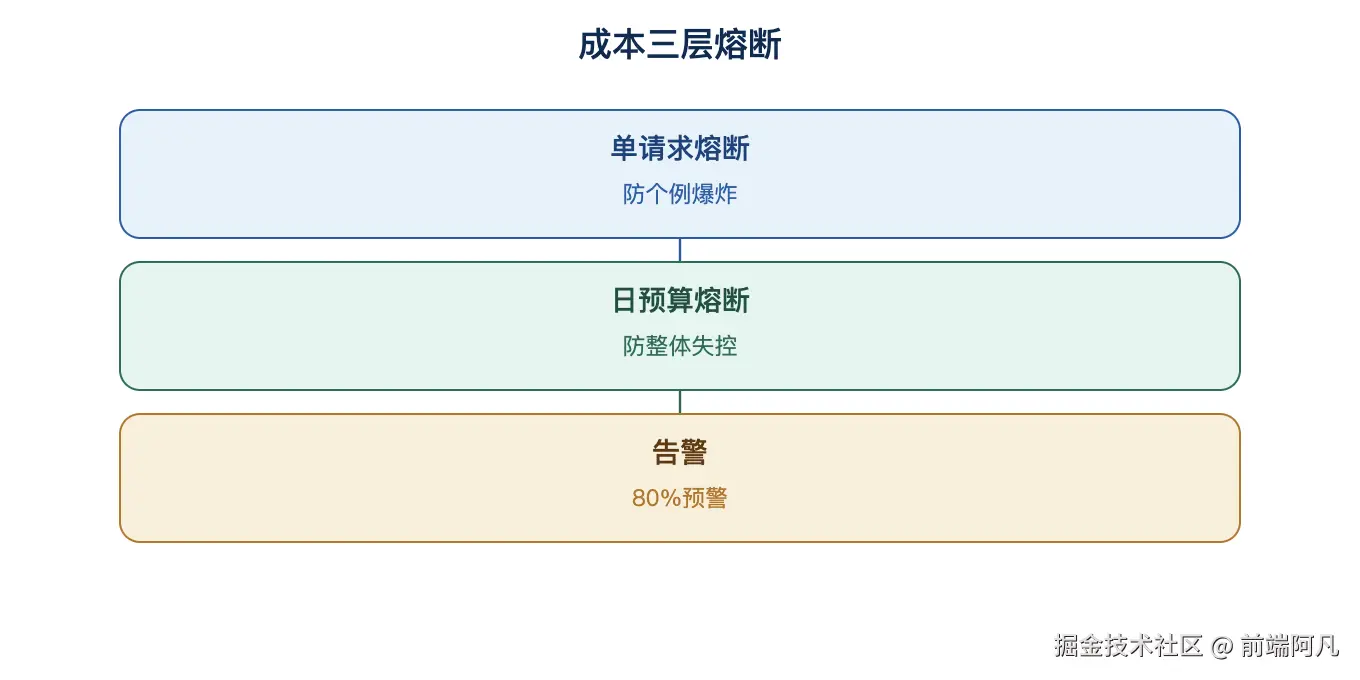
图 3:成本三层熔断
BUDGET_CONFIG = {
    "per_request": {            # 单请求上限
        "max_tokens": 4000,     # 输出上限(防失控长文)
        "max_steps": 8,         # 循环步数上限
        "max_cost_usd": 0.05,   # 单任务费用上限
    },
    "per_day": {
        "max_cost_usd": 500,    # 日预算
        "alarm_at": 0.8,        # 用满 80% 告警
        "kill_at": 1.0,         # 用满 100% 熔断
    },
}

def check_budget(usage, config):
    if usage.cost > config["per_request"]["max_cost_usd"]:
        return "task_killed"     # 单任务熔断
    if usage.day_cost / config["per_day"]["max_cost_usd"] >= 1.0:
        return "day_killed"      # 日预算熔断
    return "ok"
三层熔断:单请求熔断(防个例爆炸)→ 日预算熔断(防整体失控)→ 告警(提前预警)。
23.3 生产部署架构
23.3.1 三种部署形态对比
| 形态 | 特点 | 适用 | 典型场景 |
|---|---|---|---|
| 无服务器(Serverless) | 按调用计费、自动伸缩、零运维 | 流量波动大、起步快 | 客服 API、轻量 Agent |
| 容器(Docker + 编排) | 可控、可移植、环境一致 | 中等规模、自定义依赖 | 标准生产形态 |
| K8s | 大规模、高可用、弹性 | 大流量、微服务化 | 企业级平台 |
选型逻辑:起步用无服务器(快、省),流量稳定后用容器/K8s(可控、省成本)。
23.3.2 生产 Agent 的部署架构图
┌────────────────────────────────────────────┐
│              接入层(API Gateway)            │
│   限流 / 鉴权 / 路由(第11章)               │
├────────────────────────────────────────────┤
│              Agent 服务层(无状态)           │
│   会话管理 → Agent 循环(第6章)             │
│   ├─ 模型调用层(LLM API / 私有模型服务)     │
│   ├─ 工具调用层(MCP / 工具服务)            │
│   └─ 记忆层(Redis / 向量库)               │
├────────────────────────────────────────────┤
│              数据与基础设施层                 │
│   PostgreSQL / Redis / 向量库 / 对象存储      │
│   追踪坚控(Langfuse/OTel)+ 日志             │
└────────────────────────────────────────────┘
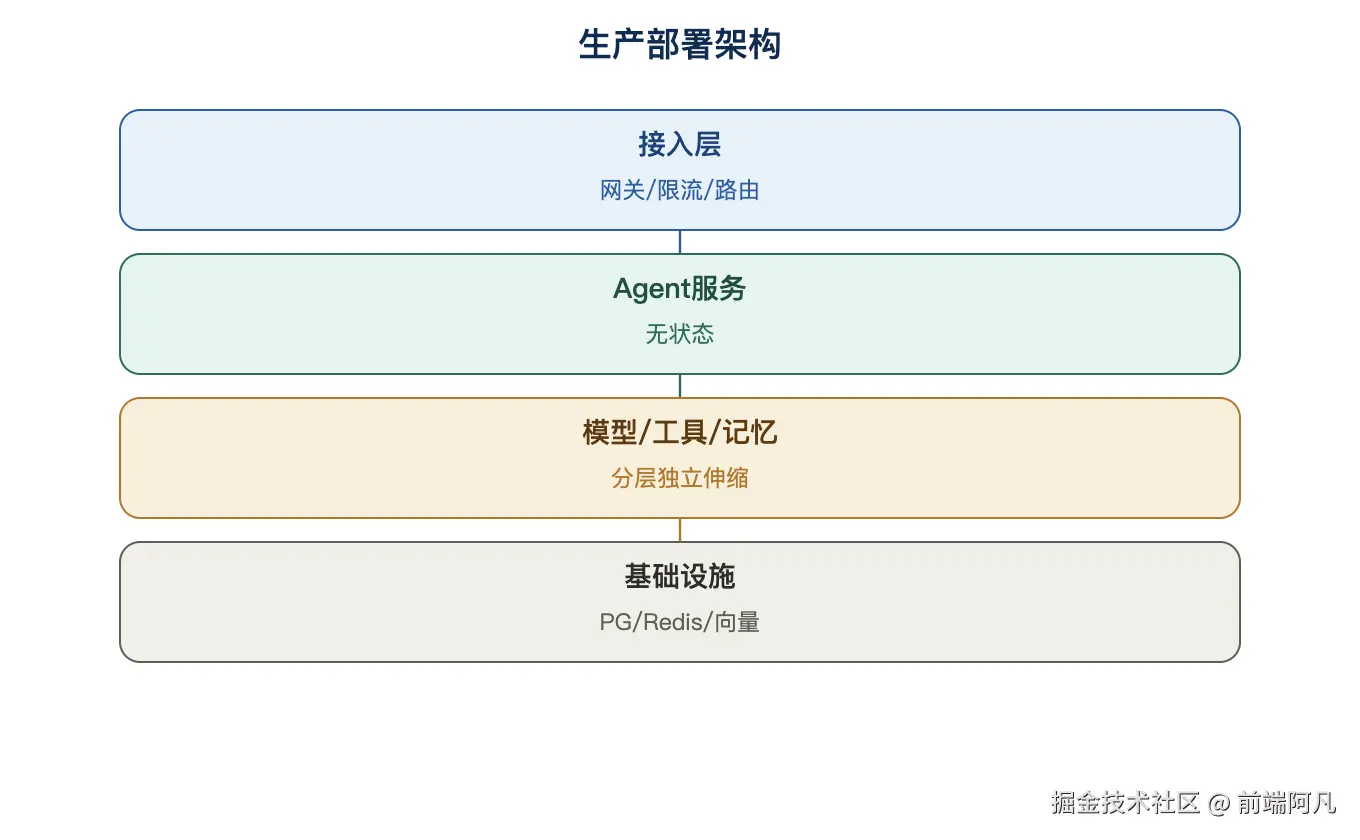
图 4:生产部署架构
设计要点:
- Agent 服务无状态:会话状态放 Redis(第 3/9 章),服务可水平扩展。
- 模型/工具/记忆分层:各自独立伸缩(模型流量大、工具依赖外部)。
- 可观测性贯穿:每层都有 trace(第 21 章)。
23.3.3 部署的可靠性清单
| 关注点 | 手段 |
|---|---|
| 高可用 | 多副本 + 负载均衡 |
| 弹性 | 自动伸缩(按 QPS/队列长度) |
| 容灾 | 备用模型 failover(第 24 章 B3) |
| 版本 | 蓝绿发布 / 灰度(第 20 章) |
| 可回滚 | 配置版本化(第 24 章 G4) |
23.4 完整实战:一次真实的成本优化改造
用一个贯穿案例演示"成本从哪来、怎么量化、怎么降、降到多少"。
23.4.1 现状:一个"烧钱"的客服 Agent
场景:某客服 Agent 单次会话平均成本 0.42 元,团队觉得太贵。先拆解成本构成:
| 环节 | 每次调用成本 | 调用次数/会话 | 小计 |
|---|---|---|---|
| 主模型问答(大模型) | 0.06 元 | 5 次 | 0.30 元 |
| 路由判断(大模型) | 0.04 元 | 1 次 | 0.04 元 |
| 情绪分析(大模型) | 0.03 元 | 1 次 | 0.03 元 |
| 工具结果回填(大模型再生成) | 0.05 元 | 1 次 | 0.05 元 |
| 合计 | 8 次调用 | 0.42 元 |
观察:8 次调用全是大模型,其中"路由判断""情绪分析"这类简单任务用大模型是杀鸡用牛刀。
23.4.2 优化方案(第 23.2 五个金矿逐一应用)
| 优化 | 做法 | 省下的成本 |
|---|---|---|
| 小模型路由 | 路由/情绪分析换小模型(qwen-turbo,成本为大模型的 1/5) | 0.04+0.03 → 0.014 元 |
| Prompt 缓存 | 固定系统提示词开 KV Cache(第 24 章 C3) | 主问答输入成本降 60% |
| 结果缓存 | 相同问题命中缓存(高频问题零成本) | 约 20% 会话命中 |
| 循环收敛 | 无进展检测 + 停止条件(第 6 章) | 平均调用 5 次 → 4.2 次 |
| 上下文裁剪 | 工具结果精简回填 | 单次输入降 25% |
23.4.3 优化前后对比
| 指标 | 优化前 | 优化后 | 变化 |
|---|---|---|---|
| 单会话成本 | 0.42 元 | 0.16 元 | ↓ 62% |
| 平均调用次数 | 8 次 | 6.3 次 | ↓ 21% |
| P95 延迟 | 8.2s | 5.4s | ↓ 34% |
| 会话成功率 | 85% | 86% | ↑ 1pp(评测回归确认无退化) |
# 优化后的成本计算(验证)
COST_MODEL = {
    "big_model": 0.06, "small_model": 0.012,   # 每千token单价
}
def estimate_session_cost(plan):
    """按调用计划估算单会话成本"""
    cost = 0
    for step in plan["steps"]:
        model = "small_model" if step["simple"] else "big_model"
        tokens = step["input_tokens"] * (0.4 if step["cached"] else 1.0)
        cost += COST_MODEL[model] * tokens / 1000
    return round(cost, 3)

print(estimate_session_cost(new_plan))   # ≈ 0.16 元
23.4.4 关键经验:降本不能牺牲质量
- 每次优化都跑评测回归(第 20 章)——本例成功率 85%→86% 证明无退化,这是"敢降本"的前提。
- 先量化再动手:23.4.1 的成本拆解表格是优化的"地图",不知道钱花在哪就别谈优化。
- 小模型路由是最大:简单任务换小模型,收益立竿见影。
- 缓存是"":Prompt 缓存 + 结果缓存改配置就能省,不用改逻辑。
- 降本有下限:成本降到影响质量(评测分数下滑)就停——目标是最优性价比,不是最低成本。
23.4.5 部署选型的成本视角
| 流量规模 | 推荐形态 | 成本特征 |
|---|---|---|
| < 1 万次/月 | 无服务器(API 按量) | 零起步成本 |
| 1-50 万次/月 | API + 缓存层 | 缓存省大头 |
| > 50 万次/月 | 私有化部署(开源模型) | 固定成本摊薄 |
部署形态本身也是成本优化(呼应第 2 章选型)——在长期、稳定、高吞吐场景下,私有化可能比 API 更经济;但需计入 GPU 采购/租用、运维人力和模型更新成本,低利用率时反而不划算。
? 解决方案:成本预算模板 + 延迟优化对比案例
解决方案速查表
| 现象 | 根因 | 解决方案 |
|---|---|---|
| 成本失控 | 无熔断 | 三层预算熔断 |
| 响应慢 | 循环多/单次慢 | 减步数 + 流式 + 小模型 |
| 缓存失效 | 前缀不一致 | 固定系统提示词 + 缓存检查 |
| 私有化慢 | 模型未优化 | 量化 + 蒸馏 |
| 流量崩 | 无伸缩 | 自动伸缩 / 无服务器 |
实战提示
- 先减次数再加速度:循环步数是延迟最大放大器,先优化它。
- 五个金矿按序挖:缓存 → 小模型路由 → 裁剪 → 收敛,从便宜的做起。
- 三层熔断必须有:单请求 / 日预算 / 告警,缺一不可。
- 无状态设计:Agent 服务无状态,状态外置(Redis/DB),才能伸缩。
- 部署形态可演进:无服务器起步,流量稳定后转容器/K8s——别一上来就上重架构。