




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
AI深度推理如何工程化:用 bl pipeline 编排多步破解流程
时间:2026-09-15 17:30:01 编辑:袖梨 来源:一聚教程网
面对密码分析、合同审查等复杂任务,一次模型调用往往难以稳定覆盖所有推理环节。真正影响结果的,不只是模型是否会“思考”,还有推理预算、步骤依赖、数据传递与知识检索如何协同。下面将从工程视角拆解这些问题,并用 bl pipeline 展示一条可验证、可复现的实现路径。
昨天 Hacker News 上一条帖子炸了:Claude Fable 5.1 用 40 分钟破解了 Cyphral Distich,一段从 1650 年代流传至今的密码。471 个赞,200 条评论。
抛开"AI 好厉害"的情绪,从工程视角看,这件事真正值得拆解的是:Fable 的推理过程不是一次性调用,而是一条多步编排的推理链——分析字符频率、提出加密假设、逐一验证、排除错误路径、收窄到正确解法。
这个模式,用 bl pipeline 可以在本地复现。
深度推理模式:--enable-thinking 的工程含义
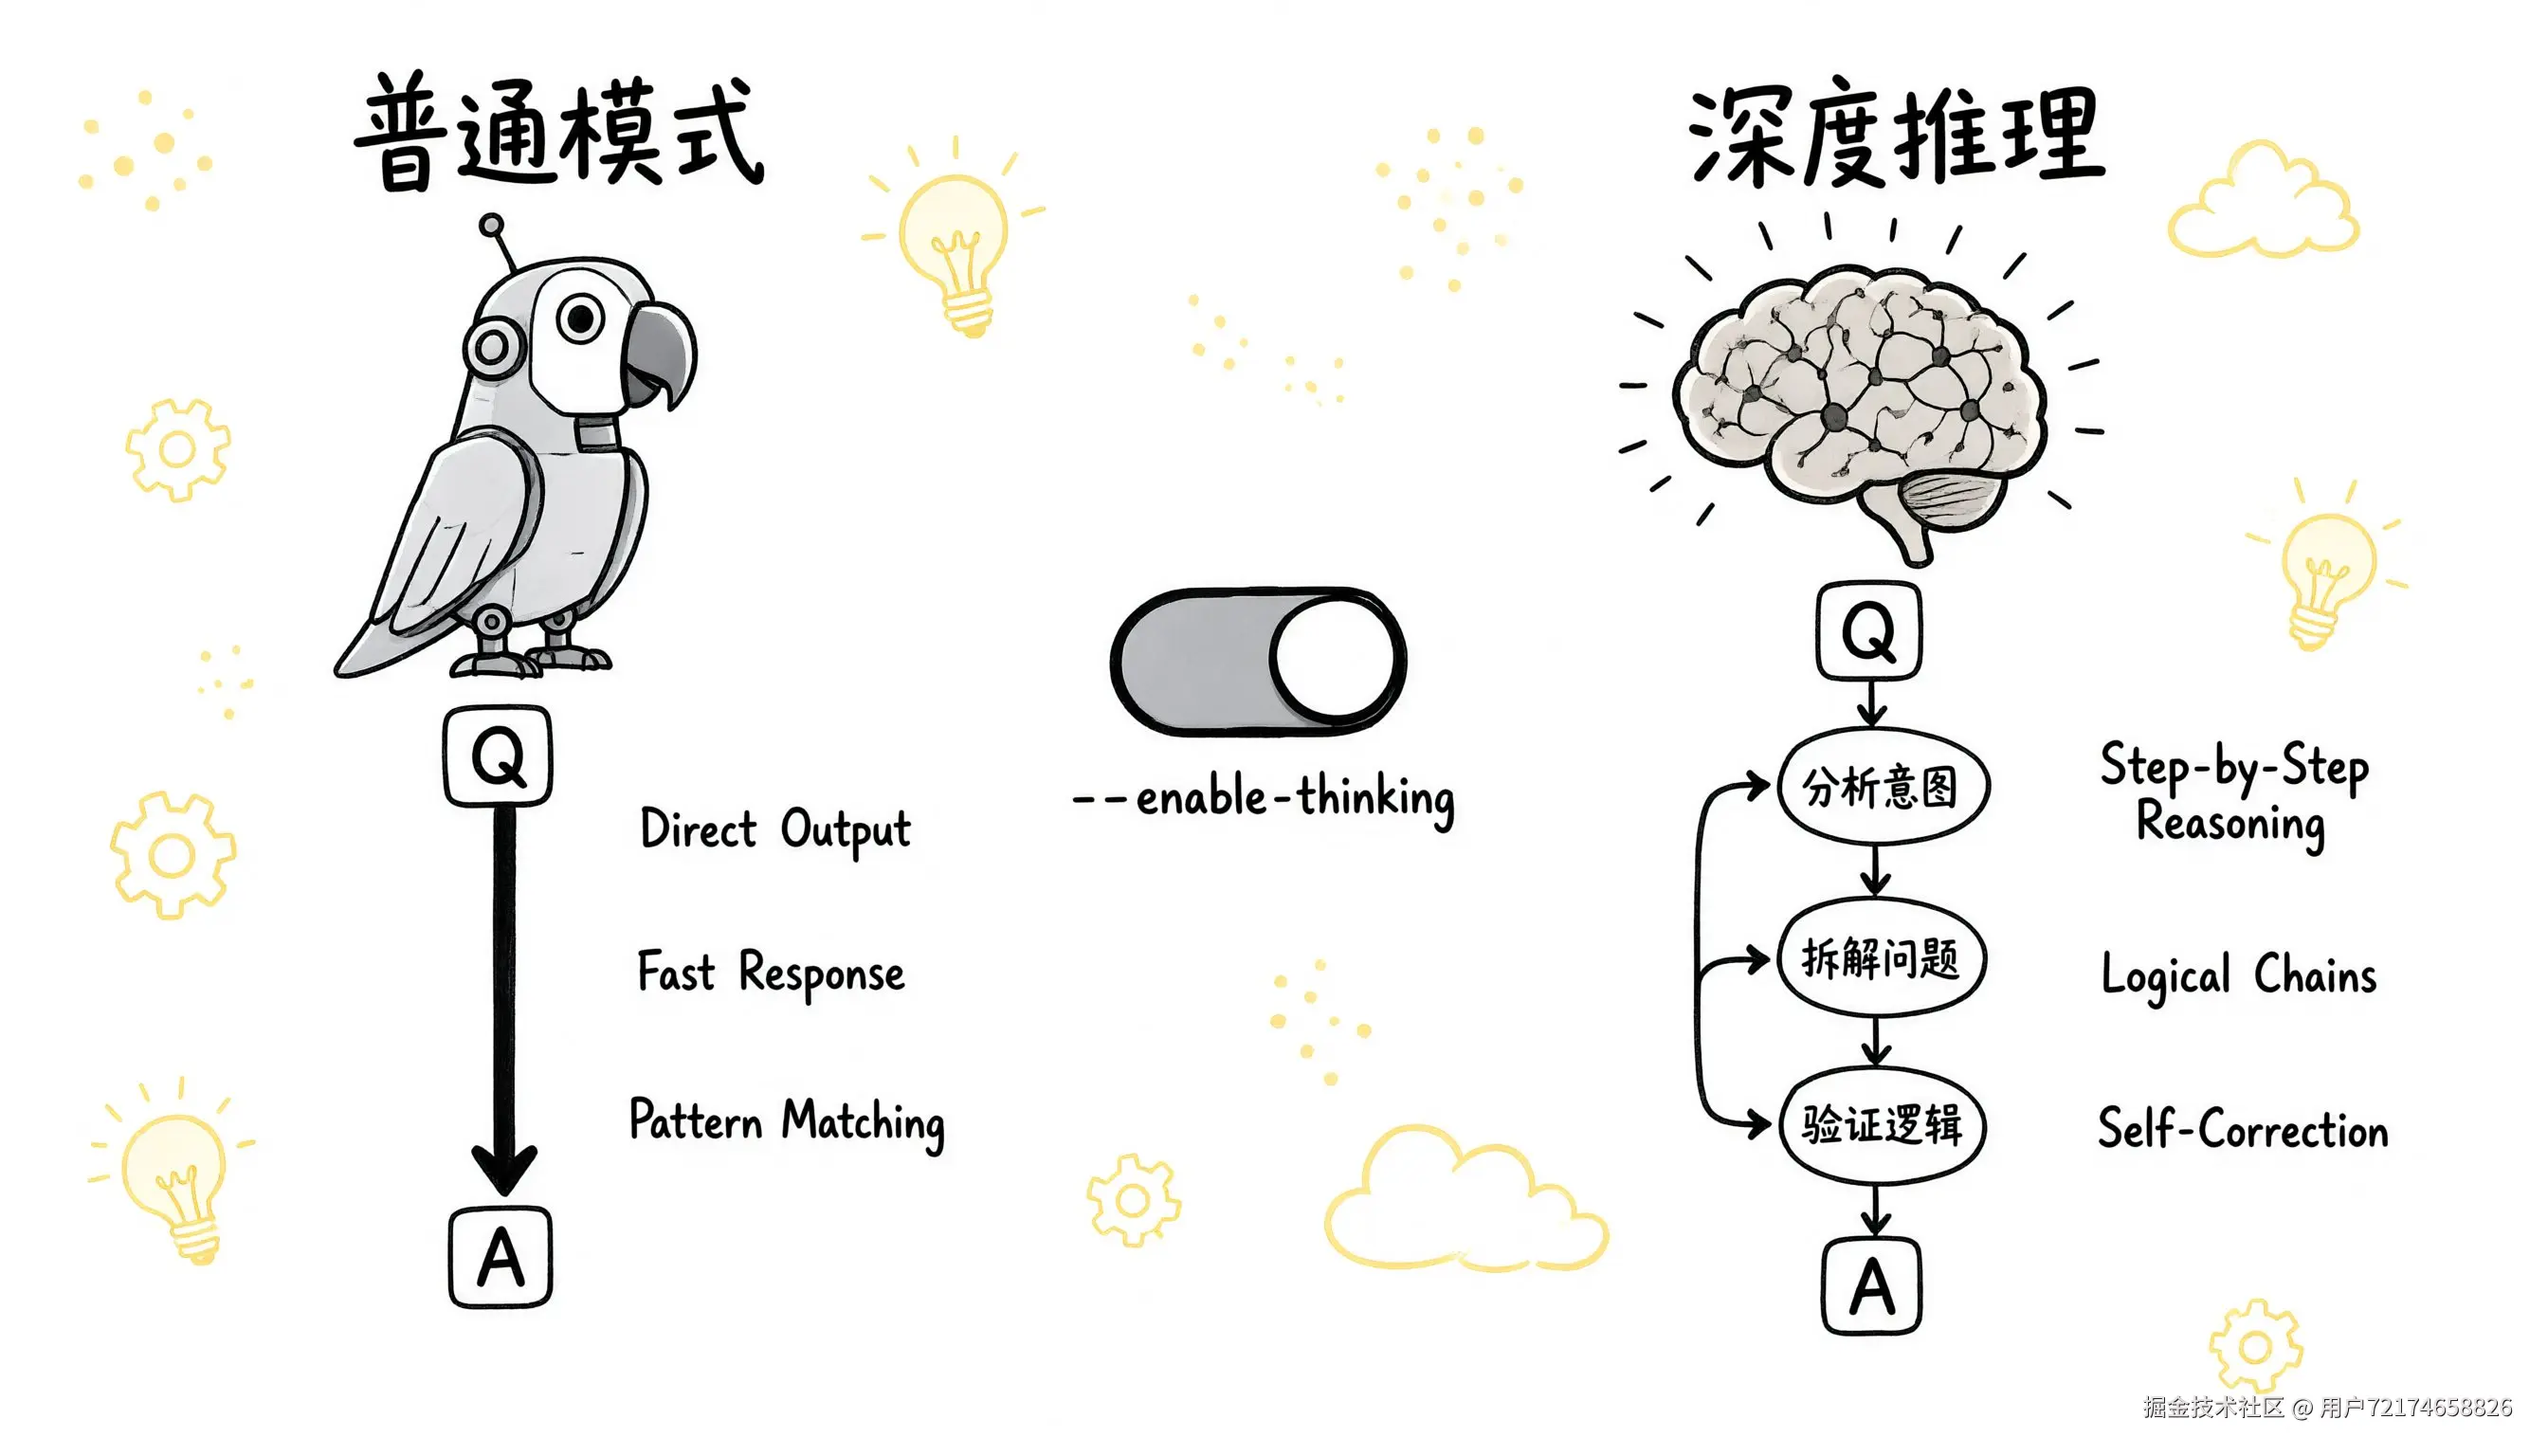
bl text chat 支持 --enable-thinking 参数,开启后模型会在输出最终答案前,先消耗 --thinking-budget 指定的 token 数做内部推理。工具是 bailian-cli,npm install bailian-cli 装完即用,API Key 在百炼控制台 API Key 页面创建(新用户有免费额度,命令格式以官方文档为准)。
bl text chat --message "分析这段密文的字符频率分布和重复模式" --model qwen3.8-max --enable-thinking --thinking-budget 8192
工程上的差异:
| 维度 | 普通模式 | 深度推理模式 |
|---|---|---|
| 推理路径 | 单步直出 | 多步链式(分析→假设→验证→排除) |
| token 消耗 | 仅输出 token | 思考 token + 输出 token |
| 延迟 | 低(秒级) | 高(思考阶段额外耗时) |
| 适用场景 | 简单问答、格式化输出 | 复杂分析、多约束推理、根因定位 |
| 支持模型 | 全部 | qwen3.8-max、qwq-plus 等推理模型 |
实测对比(同一份 100 页合同,找风险条款):
- 普通模式:返回 5 条,均为显性风险(违约责任、知识产权归属)
- 思考模式:返回 11 条,多出 3 条隐性风险(附件排他条款、补充协议矛盾条款、条件触发自动续约)
多出的 3 条恰好是律师复核后确认"需要注意"的。推理深度的差异在复杂任务上被放大。
pipeline 编排:把推理链固化为可复现的工作流
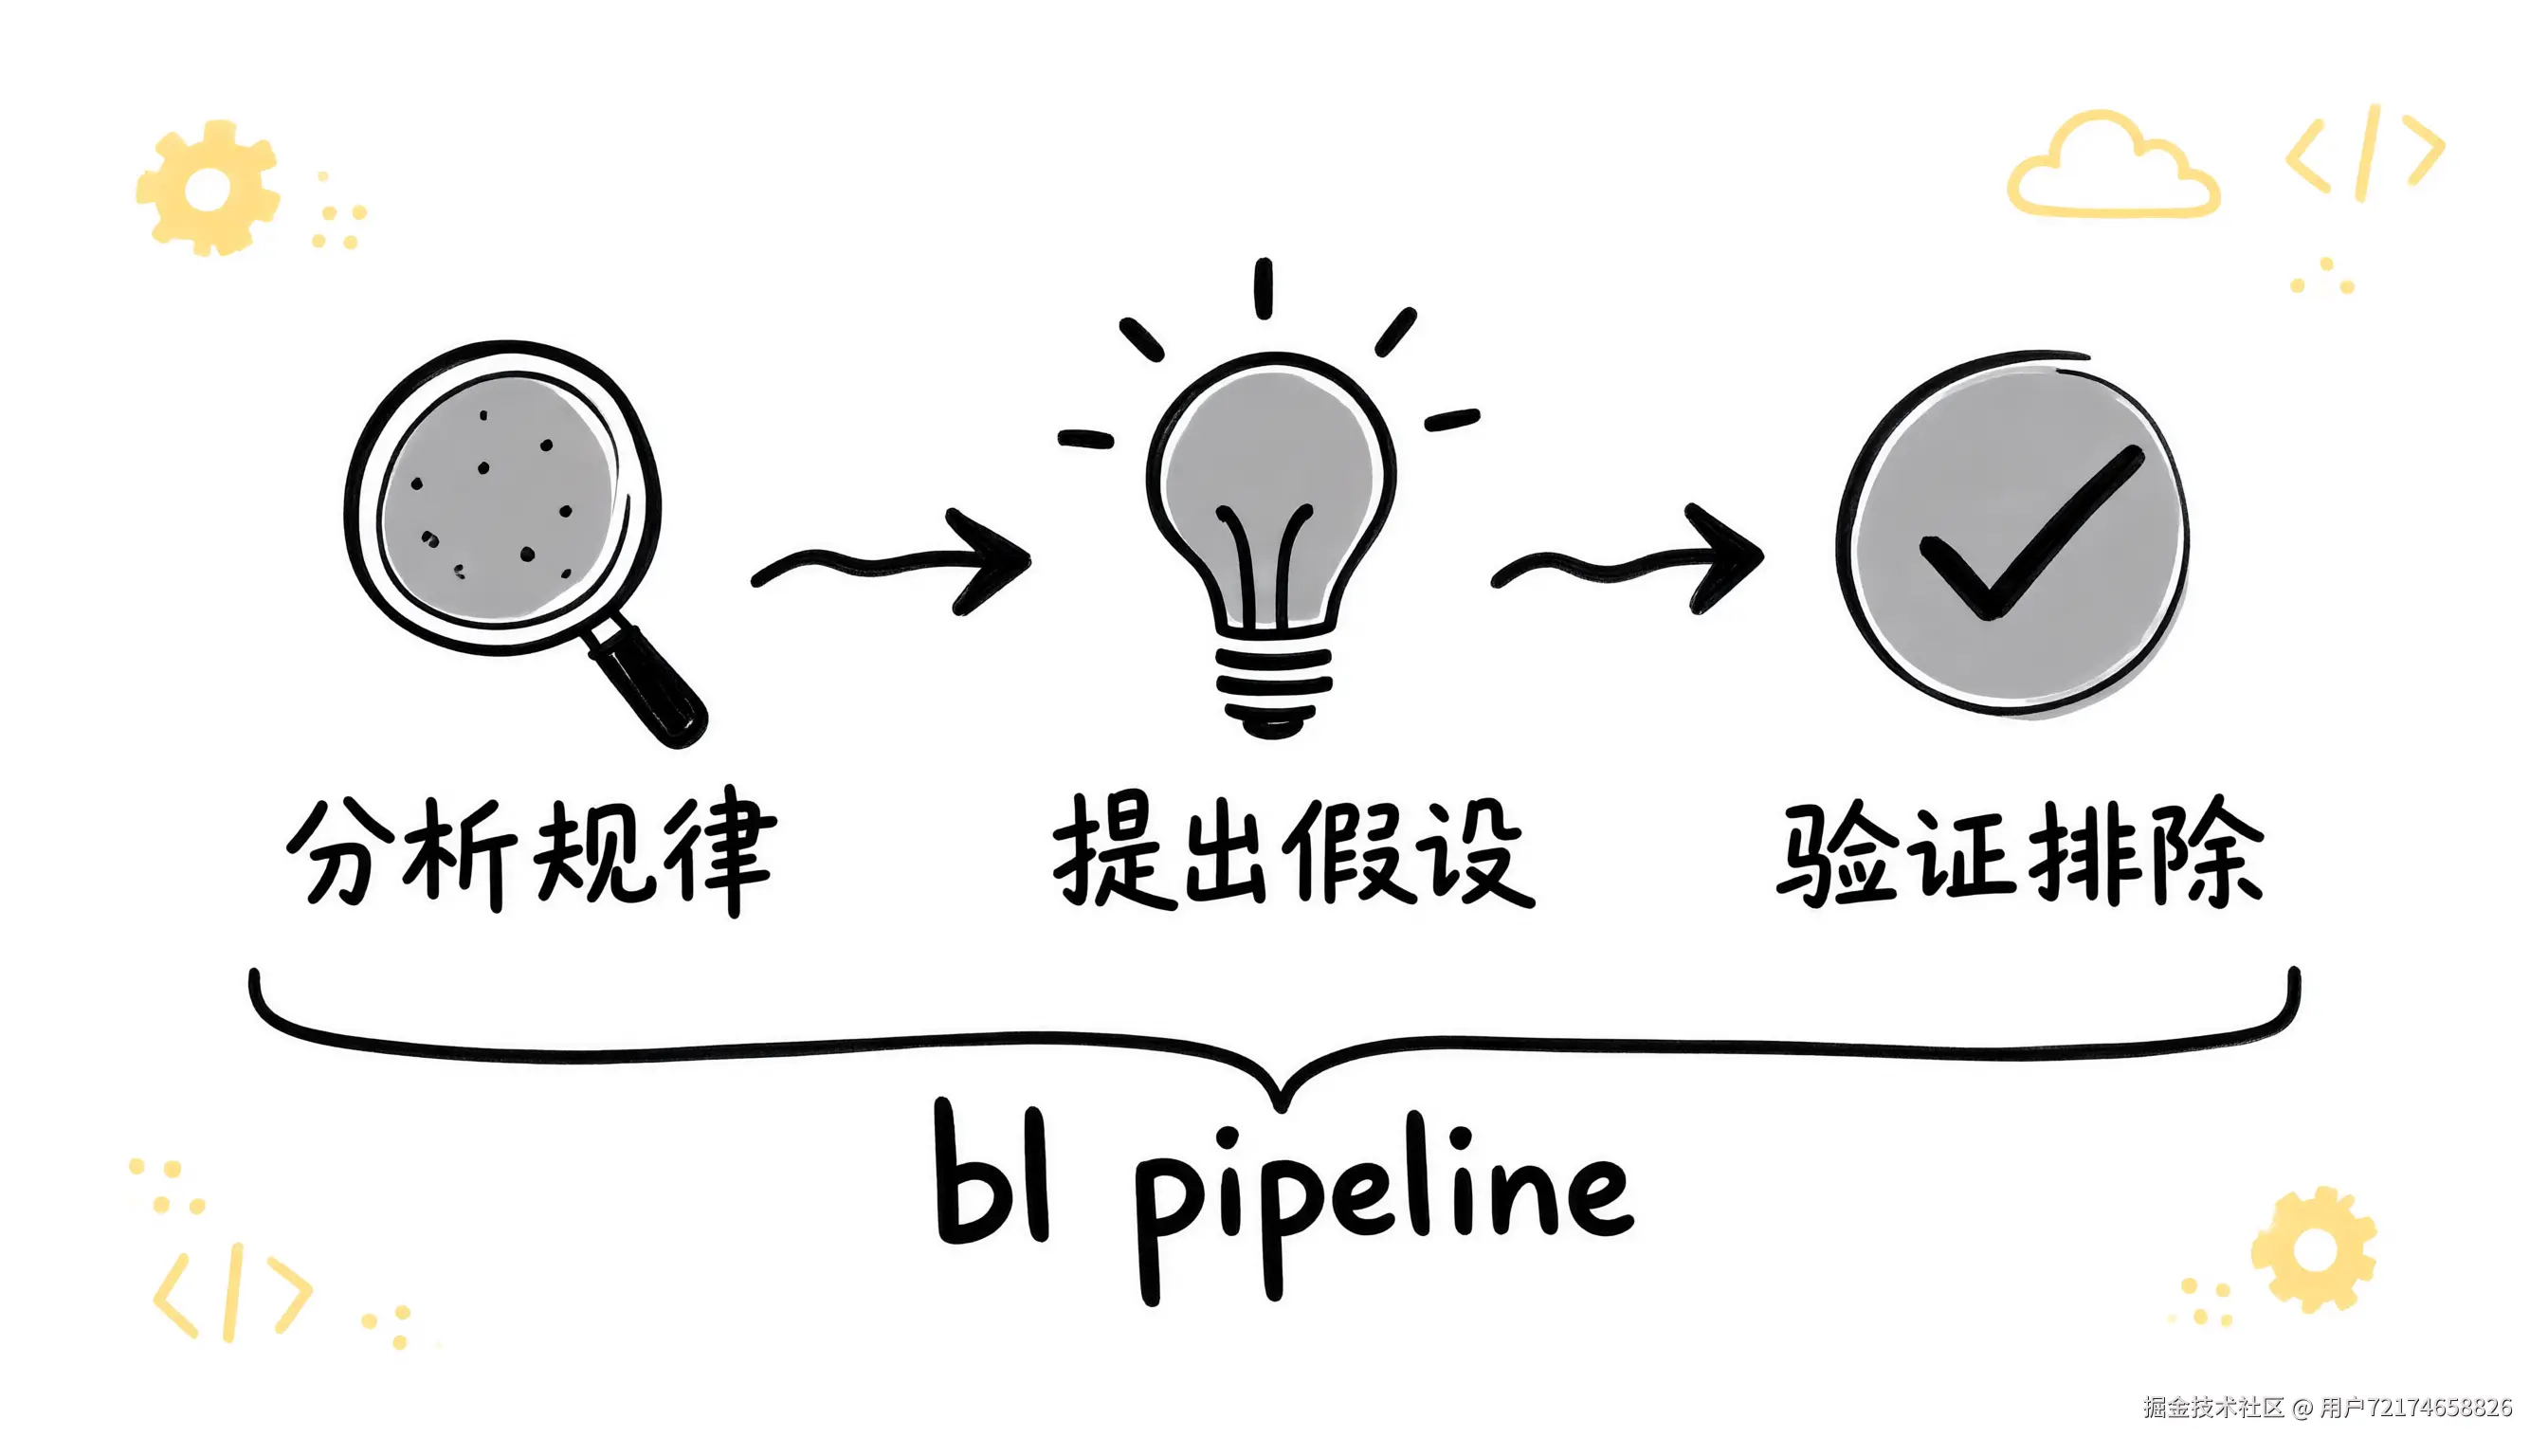
单次 --enable-thinking 解决的是"一次推理的深度"。pipeline 解决的是"多步推理的编排"。
Fable 破解密码的过程可以抽象为三步:
version: workflow/v1
steps:
  - id: frequency-analysis
    type: text/chat
    input:
      message: "统计这段密文的字符频率分布,识别高频字符和重复模式"
      model: qwen3.8-max

  - id: hypothesis
    type: text/chat
    dependsOn: [frequency-analysis]
    input:
      message: "根据频率分析结果,列出最可能的3种加密方法(替换/移位/多表),给出判断依据"
      model: qwen3.8-max

  - id: verify
    type: text/chat
    dependsOn: [hypothesis]
    input:
      message: "对每种假设尝试解密前20个字符,验证哪种方法产生有意义的明文"
      model: qwen3.8-max
bl pipeline validate --file cipher-workflow.yaml
bl pipeline run --file cipher-workflow.yaml --dry-run
validate 检查结构合法性(version 字面量、steps 非空、id/type/input 齐全、步骤类型存在)。--dry-run 预览执行计划,AI 步骤短路返回 {metadata:{dryRun:true}},不实际调用 API。
pipeline 引擎的关键机制:
- 依赖图:显式
dependsOn∪ 从$from引用自动推导的隐式边 - 拓扑排序:按依赖关系确定执行顺序,
--concurrency N控制并行度 - 步骤间数据流:
{$from: "frequency-analysis", path: "/data/choices/0/message/content"}把上一步输出注入下一步输入 - 条件执行:
when: {$exists: ...}/{$eq: [a, b]}控制分支 - 重试:
retry: {maxAttempts: 3, backoff: exponential}
11 种注册步骤类型:text/chat、vision/describe、image/generate、image/edit、video/generate、speech/synthesize、speech/recognize、script/js、logic/switch、logic/select、logic/assert。
knowledge RAG:给推理注入领域知识
Fable 能破解密码,推理深度是一半,另一半是密码学知识储备。bl knowledge 解决的是后者:
bl knowledge create --name "cipher-history"
bl knowledge doc upload --file ./cryptography-papers/ --index-id <id> --wait
bl knowledge chat --message "17世纪欧洲常用的加密方法有哪些?各自特征是什么?" --agent-id <service-id>
knowledge 的检索走语义匹配(embedding 模型 text-embedding-v4,512 维),不是关键词搜索。灌入的文档会被自动分块(chunk-size 默认 600,推荐 300-800)、向量化、建索引。
把 knowledge 和 pipeline 组合:
version: workflow/v1
steps:
  - id: analyze
    type: text/chat
    input:
      message: "分析密文特征"
      model: qwen3.8-max

  - id: retrieve
    type: text/chat
    dependsOn: [analyze]
    input:
      message: "根据分析结果,从知识库中检索匹配的加密方法"
      model: qwen3.8-max
推理 + 检索 + 再推理,这就是 RAG 增强的推理链。
工程化落地的几个约束
- thinking-budget 不是越大越好。预算越大,延迟越高、成本越高。简单任务 4096 够用,复杂多约束推理再上 8192+。
- pipeline 的 script/js 步骤有安全限制。
code字段必须是字面量字符串,不接受$from动态注入(防止执行不可信代码)。 - --dry-run 不完全"干"。AI 步骤短路,但
script/js和logic/*会真实执行。 - knowledge 的 doc upload 是异步的。加
--wait同步等待索引完成,否则后续 chat 可能检索不到刚上传的文档。
适用边界
深度推理模式适合:多约束分析、根因定位、方案比选、复杂文本理解。
不适合:简单格式化输出、实时对话、对延迟敏感的场景。思考阶段额外耗时 3-15 秒,高频调用场景需要权衡。
pipeline 适合:可复现的多步工作流、需要审计追踪的推理链、批量处理。
不适合:一次性简单问答、需要人工介入判断的交互式任务。
相关文章
- 新手学习css优先级 09-15
- 不懂ERP实施,谈FDE落地为何容易失真 09-15
- 简单明了带你了解CSS Modules 09-15
- css列表标签list与表格标签table详解 09-15
- 前端获取http状态码400的返回值实例 09-15
- 使用 OpenAI Realtime API 构建实时语音对话应用 09-15