




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
从业务字典到可信查询:AI 排障范式如何升级
时间:2026-09-14 19:50:01 编辑:袖梨 来源:一聚教程网
玩家反馈充值未到账时,支付、发货和背包日志可能分别只呈现一部分事实。无论客服还是 AI,若不了解字段、枚举值和指标口径,就容易得到看似合理却证据不足的结论。要升级这类排障流程,关键是先建立统一的业务语义,再让智能体沿着明确路径完成查询与查证。
作者:孙永华(荆磊)、郭皛璠(白玙)
玩家一句“充值没到账”,客服为何要查多份日志
晚上 9 点 47 分,游戏客服小林收到一张加急工单。玩家说,刚充了 648 元,钱已经扣了,充值礼包却没到账。
小林先查订单,支付成功。再看支付回调,签名验证也通过。钱和支付通道都没问题,问题只能出在发货。她切到发货日志,那里只有一行 deliver_status = failed。顺着 trace_id 查到系统日志,又多了一个错误码 BAG_FULL。
老客服一眼能看出来,玩家背包满了,系统重试发货,一直失败。可对刚接手业务的人来说,这只是几个分散在不同 Logstore 里的字段和值。为了给玩家一句准确答复,小林要在订单、支付、发货和背包流水之间来回切换,把机器记录的事实翻译成玩家能理解的结论。
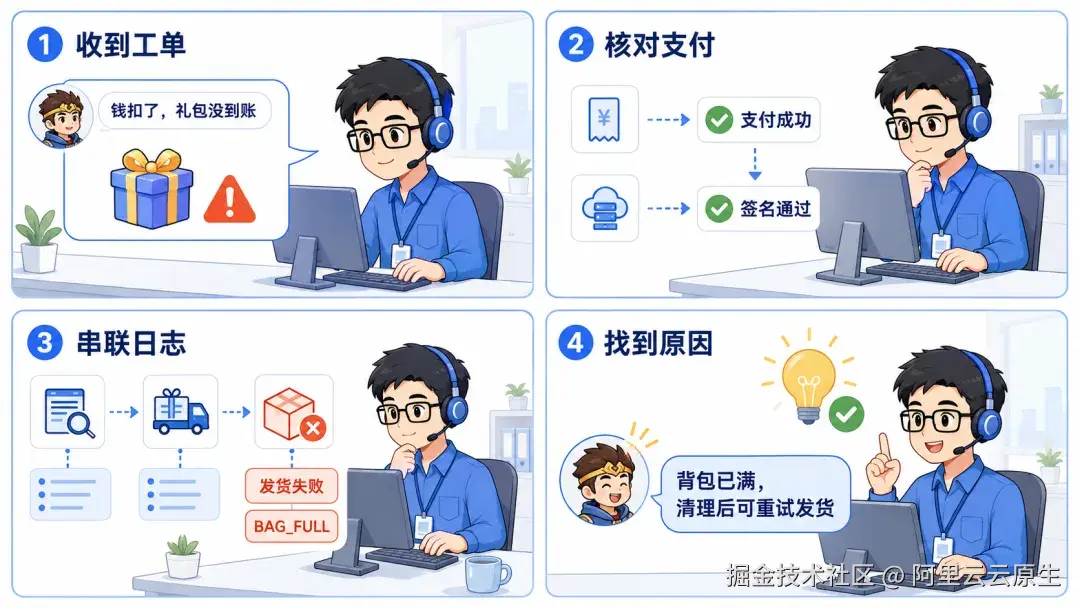
这张工单来自我们搭的示例 demo,日志也是模拟的。但这类问题是游戏客服的日常,充值支付、道具变动、匹配排位、反作弊申诉、社交纠纷,天天都有。回答其中一个问题,通常要跨多个 Logstore,连续执行 3~6 步查询。最直接的麻烦是慢。回答一个问题要在订单、支付回调、发货、背包流水之间反复切换,一个问题查下来是好几轮查询。查到了也未必看得懂,同一个字段,新手和资深客服可能得出不同结论。再碰上“收入”“到账”“赢了扣分”这类说法,不同业务团队的计算规则不一样,还得先问清楚问的是哪个口径。
日志记录事实,不记录结论
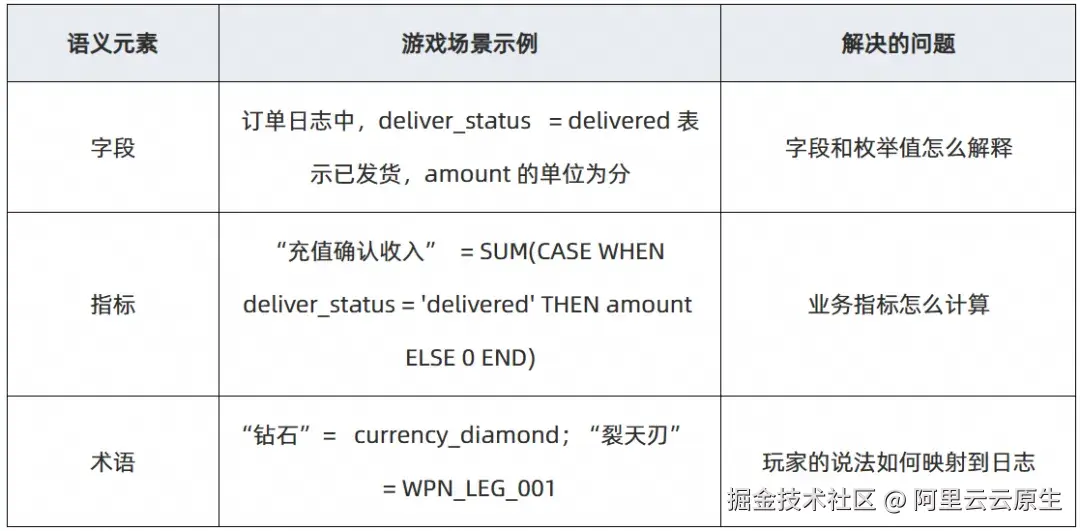
日志都在,难处是日志不会直接说出业务结论。deliver_status = delivered、item_id = WPN_LEG_001,看到这两个值,人和 AI 都无法天然知道它们分别表示“已发货”和“裂天刃”。机器记下的是事实,这些事实对应什么业务含义,日志里没有写。
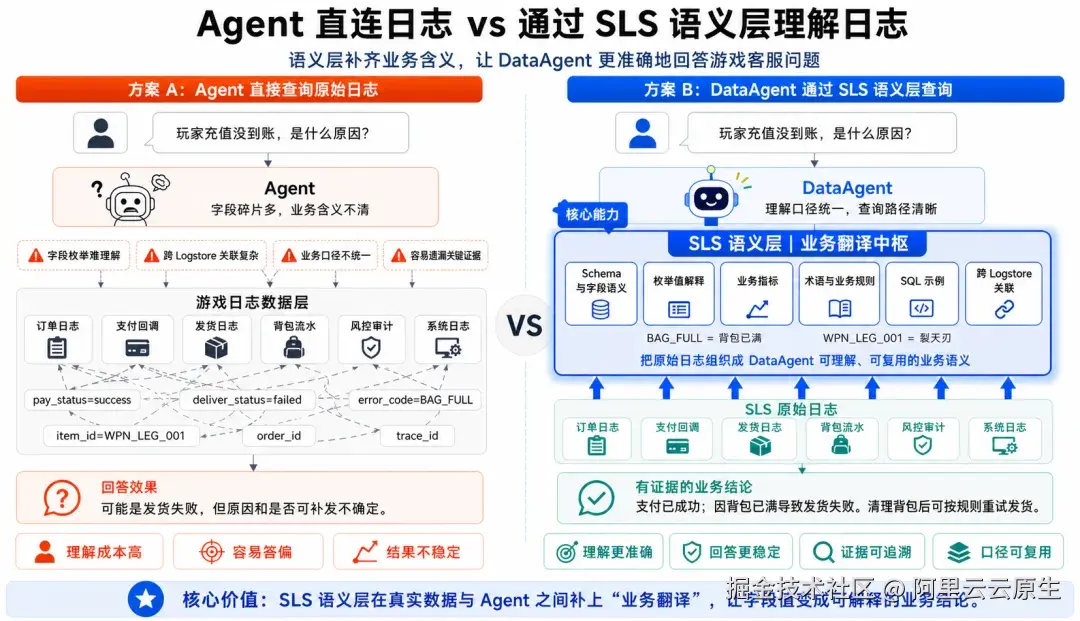
阿里云日志服务 SLS 语义层和 DataAgent 做的就是把这层翻译补上。 语义层(Semantic Layer)把 Logstore 里的字段、枚举值、业务指标、术语和示例组织成一份业务字典。字典有了,谁来问,口径都是同一套。DataAgent 是拿着字典去查案的那个。它绑定至少一个业务模型,先把玩家的自然语言问题映射到明确的口径和数据源,再构造查询、分析证据,最后给出结论和答复草稿。
三层协作:从原始日志到客服结论
示例游戏的模拟日志统一写入 SLS Project semantic-game-demo。DataAgent 排查时用三个业务证据 Logstore。
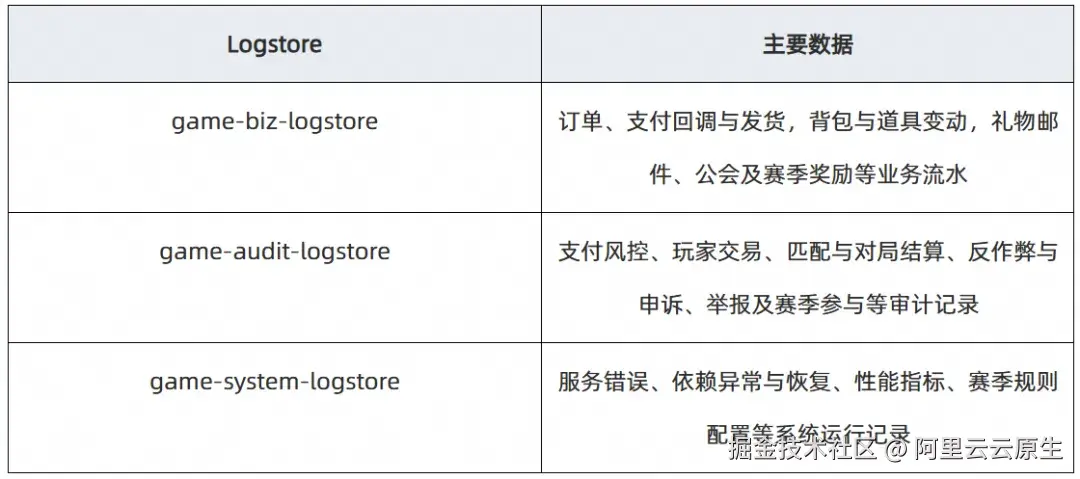
多数玩家事件都带 user_id、server_id、timestamp、trace_id 这些通用字段,跨 Logstore 排查再靠 order_id、battle_id、item_uuid 这类业务标识把证据串起来。在这个基础上,三层能力各有分工。
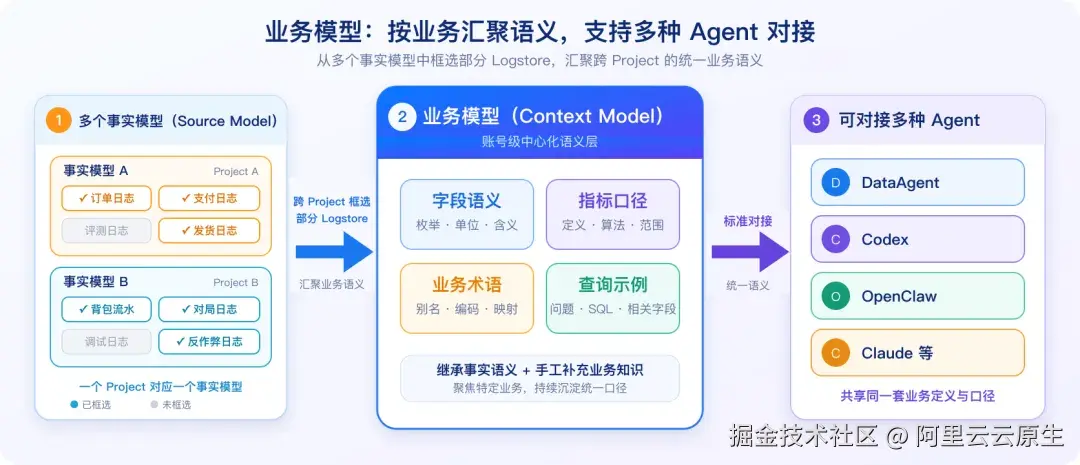
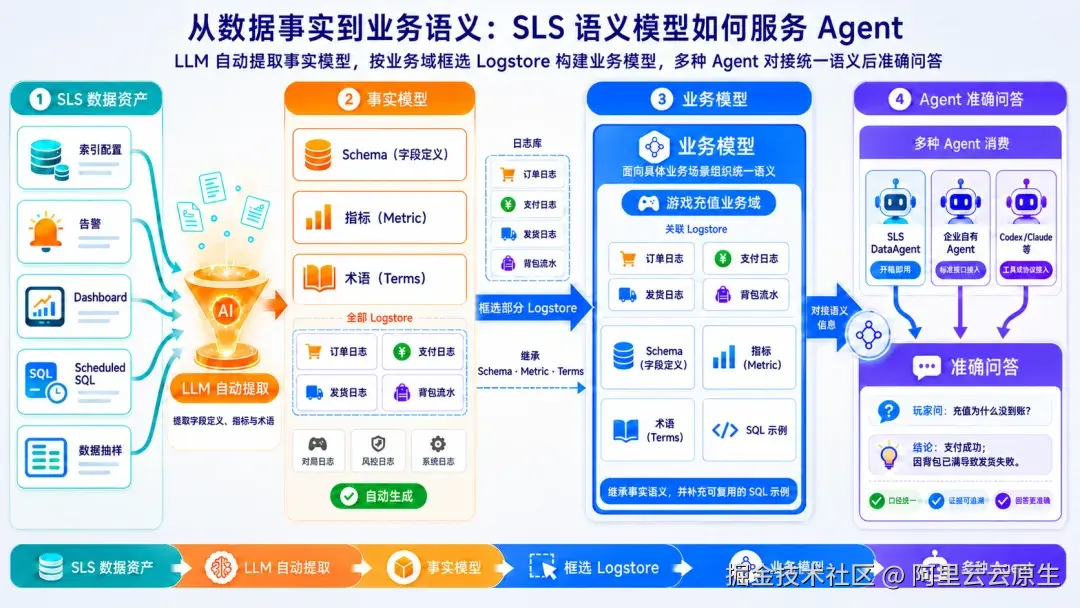
(1)事实模型(Source Model):描述数据本来的样子
事实模型(Source Model)与 Project 一一对应,不用单独起名。启动自动生成后,系统借助 LLM 综合分析仪表盘、告警、Scheduled SQL 和数据抽样,提取字段语义、指标和术语。生成时间取决于 Project 下 Logstore 的数量和数据规模,通常几分钟内完成。提取结果按证据充分程度分三种状态。自动采纳是证据充分,可以直接用。未采纳是证据不足或有歧义,等人确认。人工采纳是已经有人核对过。DataAgent 只用已采纳的内容,存疑的字段含义不会被当成业务事实。它提取的东西,看几个例子就明白。
(2)业务模型(Context Model):按业务框选,中心汇聚
业务模型(Context Model)是账号级的语义层。一个 Project 对应一个事实模型。业务横跨多个 Project 时,先选出相关 Project 的事实模型,再从中框选当前业务用得上的 Logstore,分散的数据语义就汇聚成了一个统一模型。像文中的游戏客服业务模型就只选三个业务证据 Logstore,无关的数据源、只用于评测的数据源都不选进来。业务模型的内容来自两个地方。一个是自动同步,所选 Logstore 在事实模型中的内容会自动同步过来,最大延迟 60 秒,只增不删。另一个是手工补充,可以追加指标、术语和示例,这部分不受自动同步影响。这样汇聚出来的业务模型,DataAgent 能用,Codex、OpenClaw、Claude 这些 Agent 也可以对接复用。
(3)DataAgent:按统一口径排查
DataAgent 是面向对话的智能助手实例,创建时要绑定至少一个业务模型。收到问题后,它先识别业务术语和指标口径,再选择数据源、构造查询,把多步日志证据串起来,最后输出结论、证据和答复草稿。每一步都可以核对。
能不能跳过语义层,直接让大模型查日志
看到这里,你一定会问:用 MCP 或者自然语言转 SQL 的方式查 SLS 日志,现在已经能做到。既然大模型本来就会写查询,为什么还要先搭一层语义层?
拿前面的“收入”举例。“收入”可能指订单面额、实付金额,也可能指已发货金额。直接让大模型查,它得自己猜用哪个字段、要不要加发货成功的过滤条件,同一句话问两次,猜法可能都不一样。语义层把“充值确认收入”的计算式固定下来,不管谁来问,算的都是同一个口径。再看“大宝剑”。玩家说的是这个名字,日志里存的是 WPN_LEG_001。没有术语映射,大模型不知道该去哪张日志表、匹配哪个值,很可能拿“大宝剑”三个字去全文搜,搜不到,就告诉玩家道具没丢。还有那张充值未到账的工单。有用的结论是背包满了导致发货失败,要靠支付、发货、系统三份日志一起支撑。一次性的查询往往查到第一个看起来合理的答案就停,比如查到 deliver_status = failed 就归因给发货,不再往下追为什么失败。DataAgent 能走到背包容量那一步,是因为业务模型给出了该按什么顺序、把哪些证据串起来。
查询能力已经有了,要让查询可信,得让每个结论都对得上固定的字段和计算式,查证的路径也得是确定的。语义层做的就是这件事。给大模型开了查询权限,又没有这层语义,它给的答案会很流畅,流畅到你不容易发现口径对不对、证据全不全。
最佳实践:四步搭建游戏客服 DataAgent
准备工作有三项。Project semantic-game-demo 中已准备好业务日志,相关 Logstore 配置了查询所需的字段索引,操作者具备创建和配置 DataAgent 的权限。
第一步:为 semantic-game-demo 生成事实模型
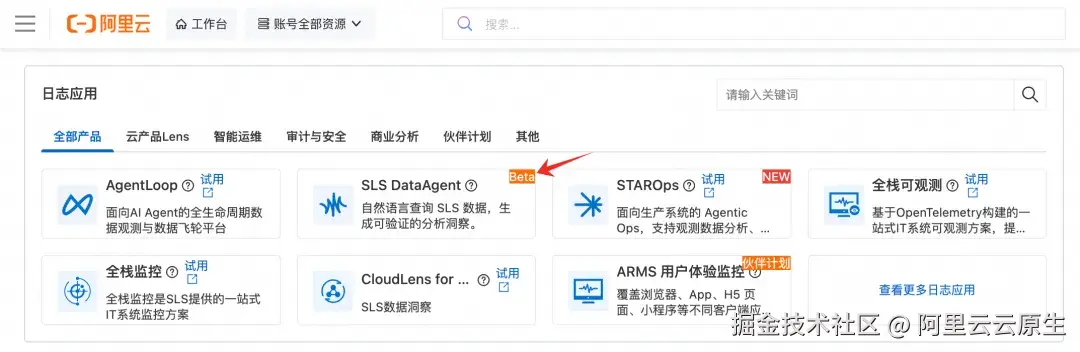
从 SLS 控制台首页进入 DataAgent。
在 “事实模型(Source Model)” 页签下,选择业务 Project semantic-game-demo。
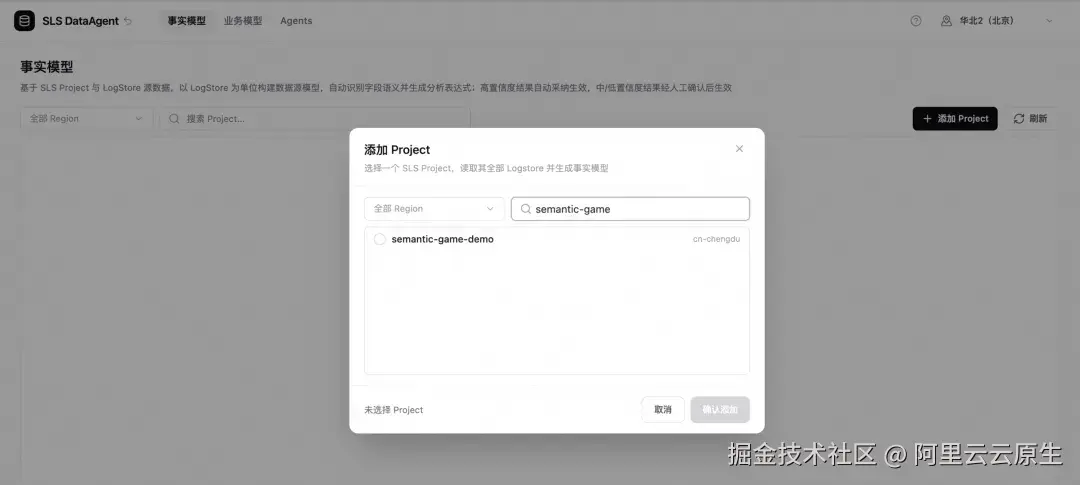
启动事实模型生成任务后,可在详情页查看任务状态。生成时间取决于 Project 下 Logstore 的数量和数据规模,通常可在数分钟内完成。
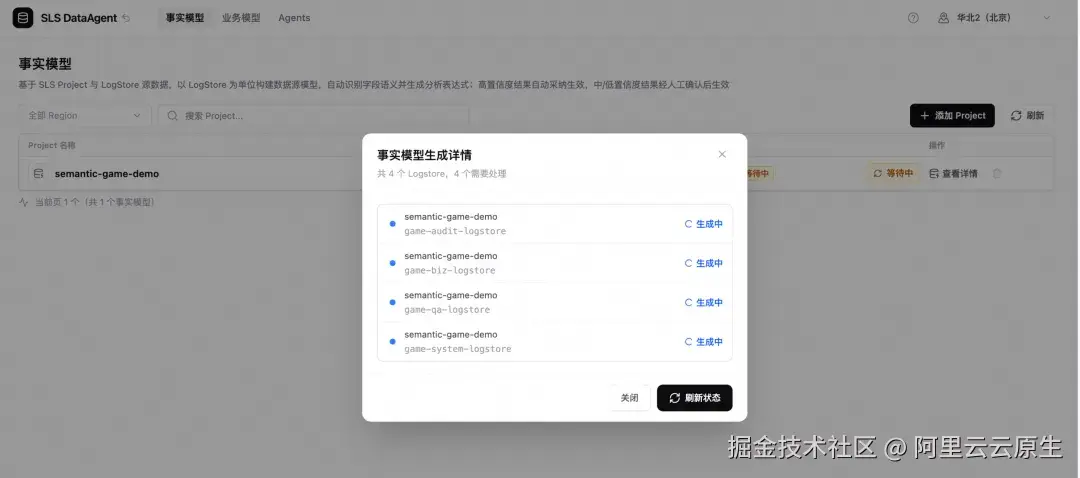
生成完成后,系统会列出从 Logstore 中提取的字段语义、指标和业务术语。
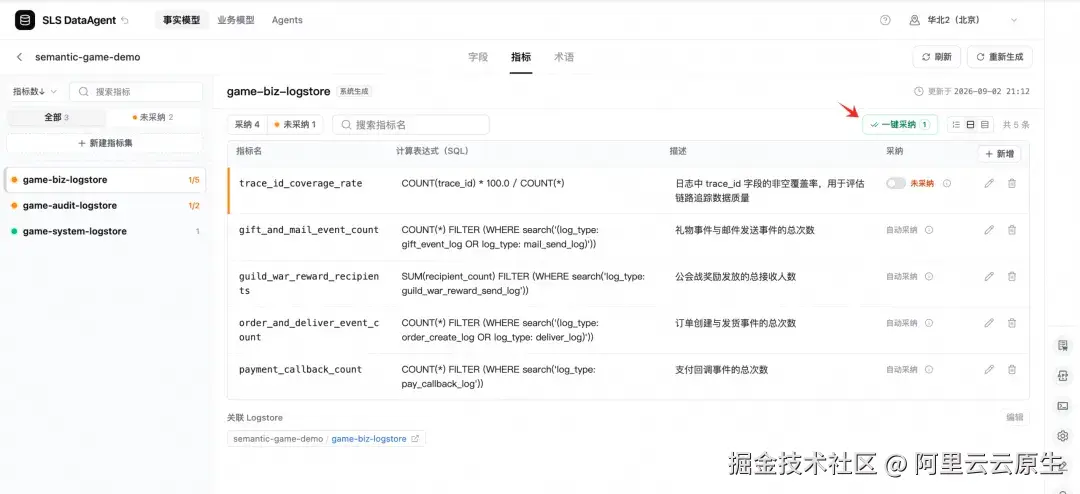
未采纳的内容要先核对业务含义,确认无误后批量采纳,或者修改后逐项采纳。
第二步:创建游戏业务模型
创建业务模型并关联 semantic-game-demo 对应的事实模型,建议在描述信息里说明模型覆盖的业务范围和主要用途,比如充值、道具、排位、反作弊这些客服场景。
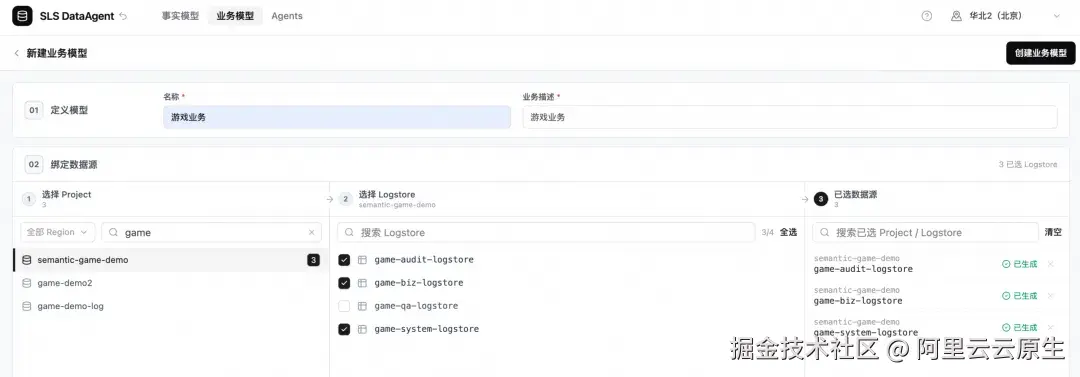
关联完成后,事实模型中已采纳的字段语义、指标和术语会同步过来,还可以再补充专有术语、指标口径和常用示例,示例里可以包含问题描述、查询语句和相关字段。
第三步:创建游戏客服 DataAgent
创建 DataAgent,绑定上一步建好的业务模型。
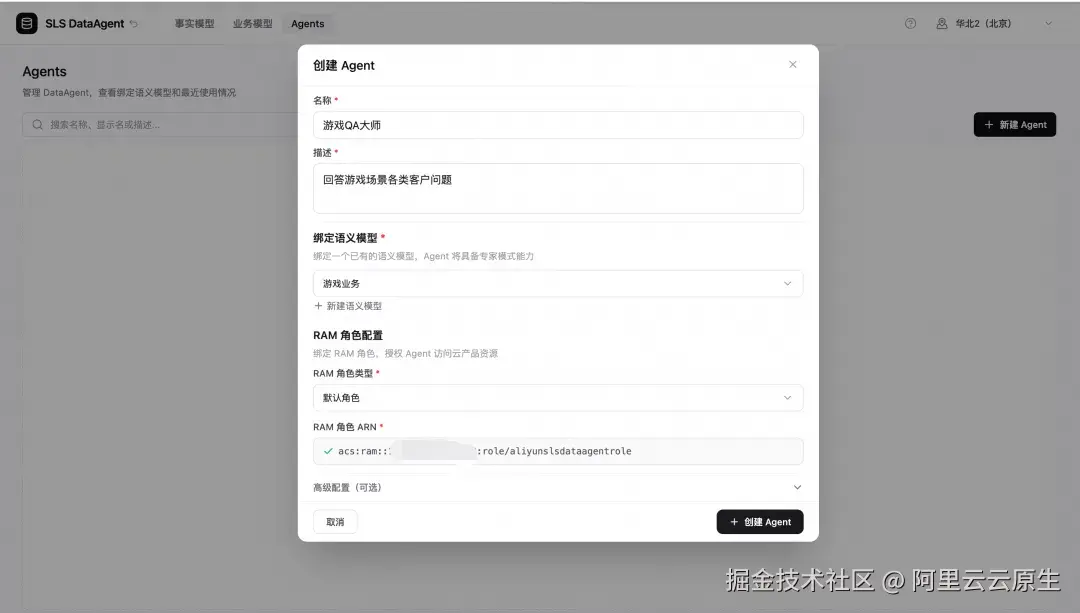
DataAgent 运行时要使用独立的 RAM 角色,默认可用系统角色 aliyunslsdataagentrole,尚未完成授权的先通过授权链接操作。如需限定可访问的资源,可以改用自定义角色,此时操作者要具备对应的 ram:PassRole 权限。
第四步:使用典型客诉进行对话测试
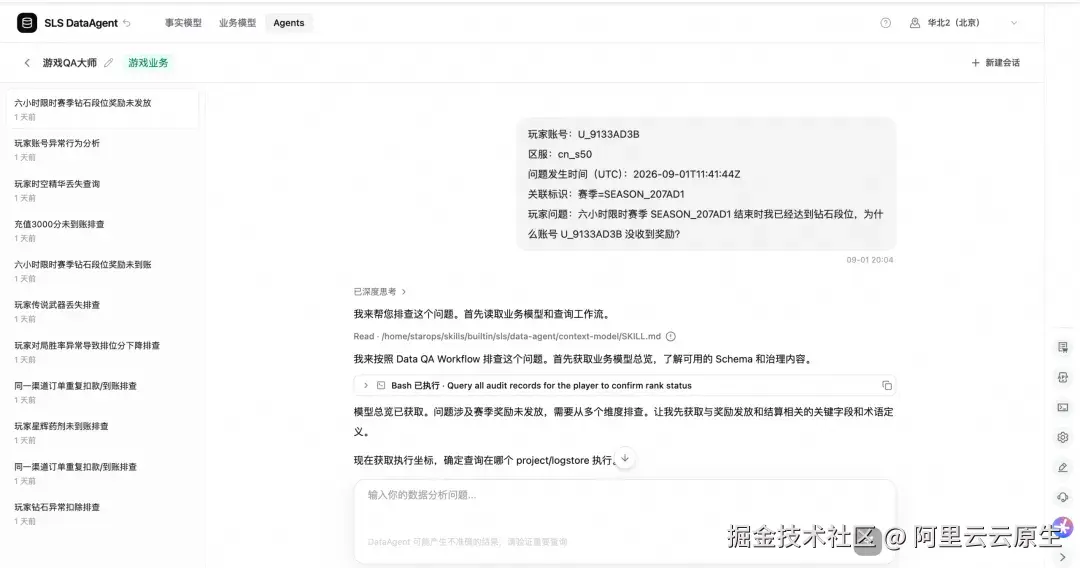
新建对话,选择刚创建的 DataAgent,输入玩家投诉原文。DataAgent 会结合业务模型识别术语和指标口径,查询相关日志,输出关键证据、分析结论和客服答复草稿。
盲测效果什么样
测试基于可复现的模拟日志,共覆盖 13 类客诉场景。
先说评测隔离。game-qa-logstore 只保存问题、标准答案和评测证据,不属于业务查询数据源。盲测时不要给 DataAgent 授予这个 Logstore 的查询权限,不然它能看到标准答案。以“充值未到账”为例。DataAgent 先查支付,回调成功,签名验证通过,钱确实付了。再查发货,发货失败,已经重试 3 次。它接着去查失败原因,系统错误和背包容量指向同一个原因,背包满了。最终结论由支付、发货、系统三份日志共同支撑,单个错误码推不到这一步。
再看三个典型案例。
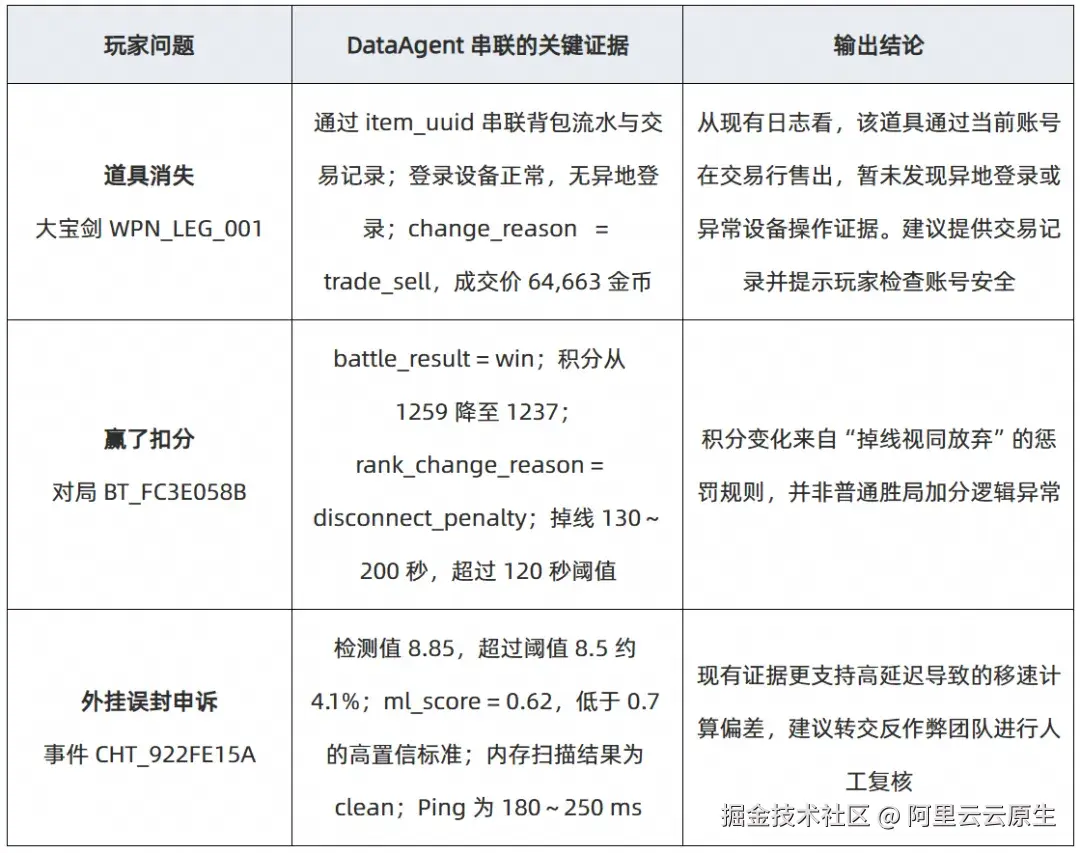
这几个结论的分寸值得留意。道具消失的结论没有说“没被盗”,它说现有日志未发现异常证据,同时建议提示玩家检查账号安全。误封申诉的结论也不直接推翻封禁,说证据更支持高延迟偏差,建议人工复核。证据走到哪里,结论就停在哪里,动作留给人。当一个问题可能对应多个口径,比如“收入”可能指订单面额、实付金额或已发货金额,DataAgent 会先向提问者确认需要哪个口径,再继续查询。想减少这类澄清,就在业务模型里补充更精确的术语、指标描述和示例。
怎么让它稳健落地到你的业务里
数据已经写入 SLS,理解数据所需的知识却散在各处。字段含义写在代码里,状态解释散在零散文档里,这两样翻一翻还能找到。难拿的是另外两样,指标口径在业务人员脑中,遇到什么问题该查哪几张日志,靠少数专家的经验。新人要反复请教,业务人员要依赖研发,AI 也可能因为不知道真实口径而得出错误结论。
语义层和 DataAgent 把这些知识搬到同一个地方。字段含义、指标口径、查询路径固定下来,业务人员用自然语言就能提问,DataAgent 理解问题、选数据源、执行查询、组织证据,结果可以核对。新人反复问、研发反复解释的时间省下来了。落地不用一步到位,可以先跑通一个问题。找出团队每天都在重复回答的高频问题,选定相关 Logstore,确认字段、术语和指标口径,补上典型问法和查询示例,让 DataAgent 完成从提问到结论的全过程。验证有效,再扩展到更多问题、更多 Project 和业务角色。所以我们建议:
1)从高频、高价值场景开始。 先把充值未到账、重复扣款这类问题的口径固定下来,容易建立可验证的效果基线。
2)先把口径弄对,再追求覆盖率。 金额单位、状态枚举、时间字段、唯一标识、指标计算式,这几项先逐个确认。口径错了,覆盖的问题越多,偏得越远。
3)把人工复核写进流程。 退款、补发、封禁、解封这些操作设清楚边界,DataAgent 输出证据和建议,由人审核后执行。
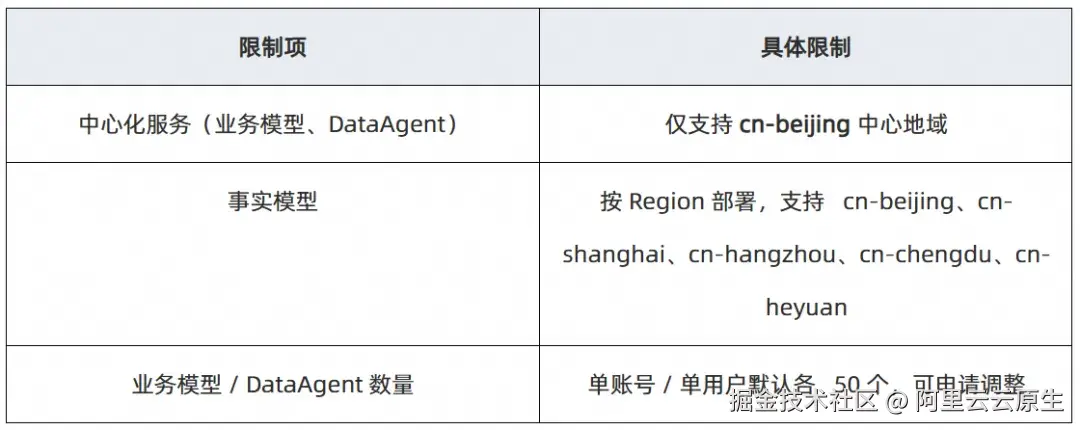
当然也有一些小限制也要说清楚:
结语:从一个高频问题开始
回到开头那张工单。口径配好以后,玩家再问“充值没到账”,小林不用再在订单、支付、发货、背包之间来回切。她把问题交给 DataAgent,拿到三份日志的证据和一份答复草稿,核对一遍,就能回给玩家。
Demo 里的日志是模拟的,方便复现。13 类场景照着常见客诉搭,不是某家游戏的真实数据。游戏之外,售后、风控、运维也有这类问题,要翻好几张日志才能答,思路是一样的。换成自己的日志,先从团队天天重复回答的那个问题开始,把字段、术语和口径配准,跑通它,再决定要不要往下加。这类问题多半是过去只有懂日志的人才答得上的。第一个能答上来以后,会答的人就不再只是那几个懂日志的了。
所以,立即体验一下日志服务 SLS 这个全新的语义能力吧!