




最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
AI Agent学习(5.5):从零认识RAG工作流程
时间:2026-09-14 19:46:01 编辑:袖梨 来源:一聚教程网
大模型能够流畅回答问题,却未必了解企业内部资料,也可能在缺少依据时生成看似可信的错误内容。RAG 的思路是在模型作答前先找到相关材料,并将其放入上下文。要让这套机制真正可用,关键在于做好文档入库、检索召回与结果重排。
先提前叠个甲:本人6年开发,分享文章仅是我个人心得,就当看个乐呵。
RAG 是我觉得最落地的 AI 应用形态。不用从头训模型,不用堆显卡,本质就是"查资料 + 让模型照着资料说话"。门槛低、见效快,特别适合想快点做出能用东西的人。
这篇按入库和检索两条线把 RAG 的工程全景摆出来——两张图就是两条线的主干(image1 入库、image2 检索),下面一节一节讲。
一、RAG 到底解决什么问题
我刚接触大模型时最被劝退的是两件事:
(1)它不知道你公司那点内部资料
(2)它太爱一本正经地编
你问"我们去年定的报销标准是多少",它能编一套有零有整的数字,还说得特别自信。就像问一个刚入职的同事公司规定:他没看过制度文件,但脸皮薄,硬给你编一个。这种幻觉在真实业务里是要出事的。
RAG 干的事特别朴素:在让模型开口之前,先帮它把"该看的材料"翻出来,塞进对话上下文里。模型还是那个模型,但这回它不是凭空回忆,而是照着资料作答,通常还会带出出处。
说白了就是开卷考试:脑子记不住没关系,只要资料找得准,答案就在卷子旁边。
所以 RAG 解决的就是两件事:
- 私域知识:内部文档、手册、历史工单,模型训练时根本没见过
- 幻觉控制:让回答有依据、可溯源
我做过的几个知识库问答项目反复验证:只要检索这步靠谱,胡说八道能少一大半。下面讲这个"靠谱"是怎么搭出来的。
二、RAG 入库流程(离线建库)
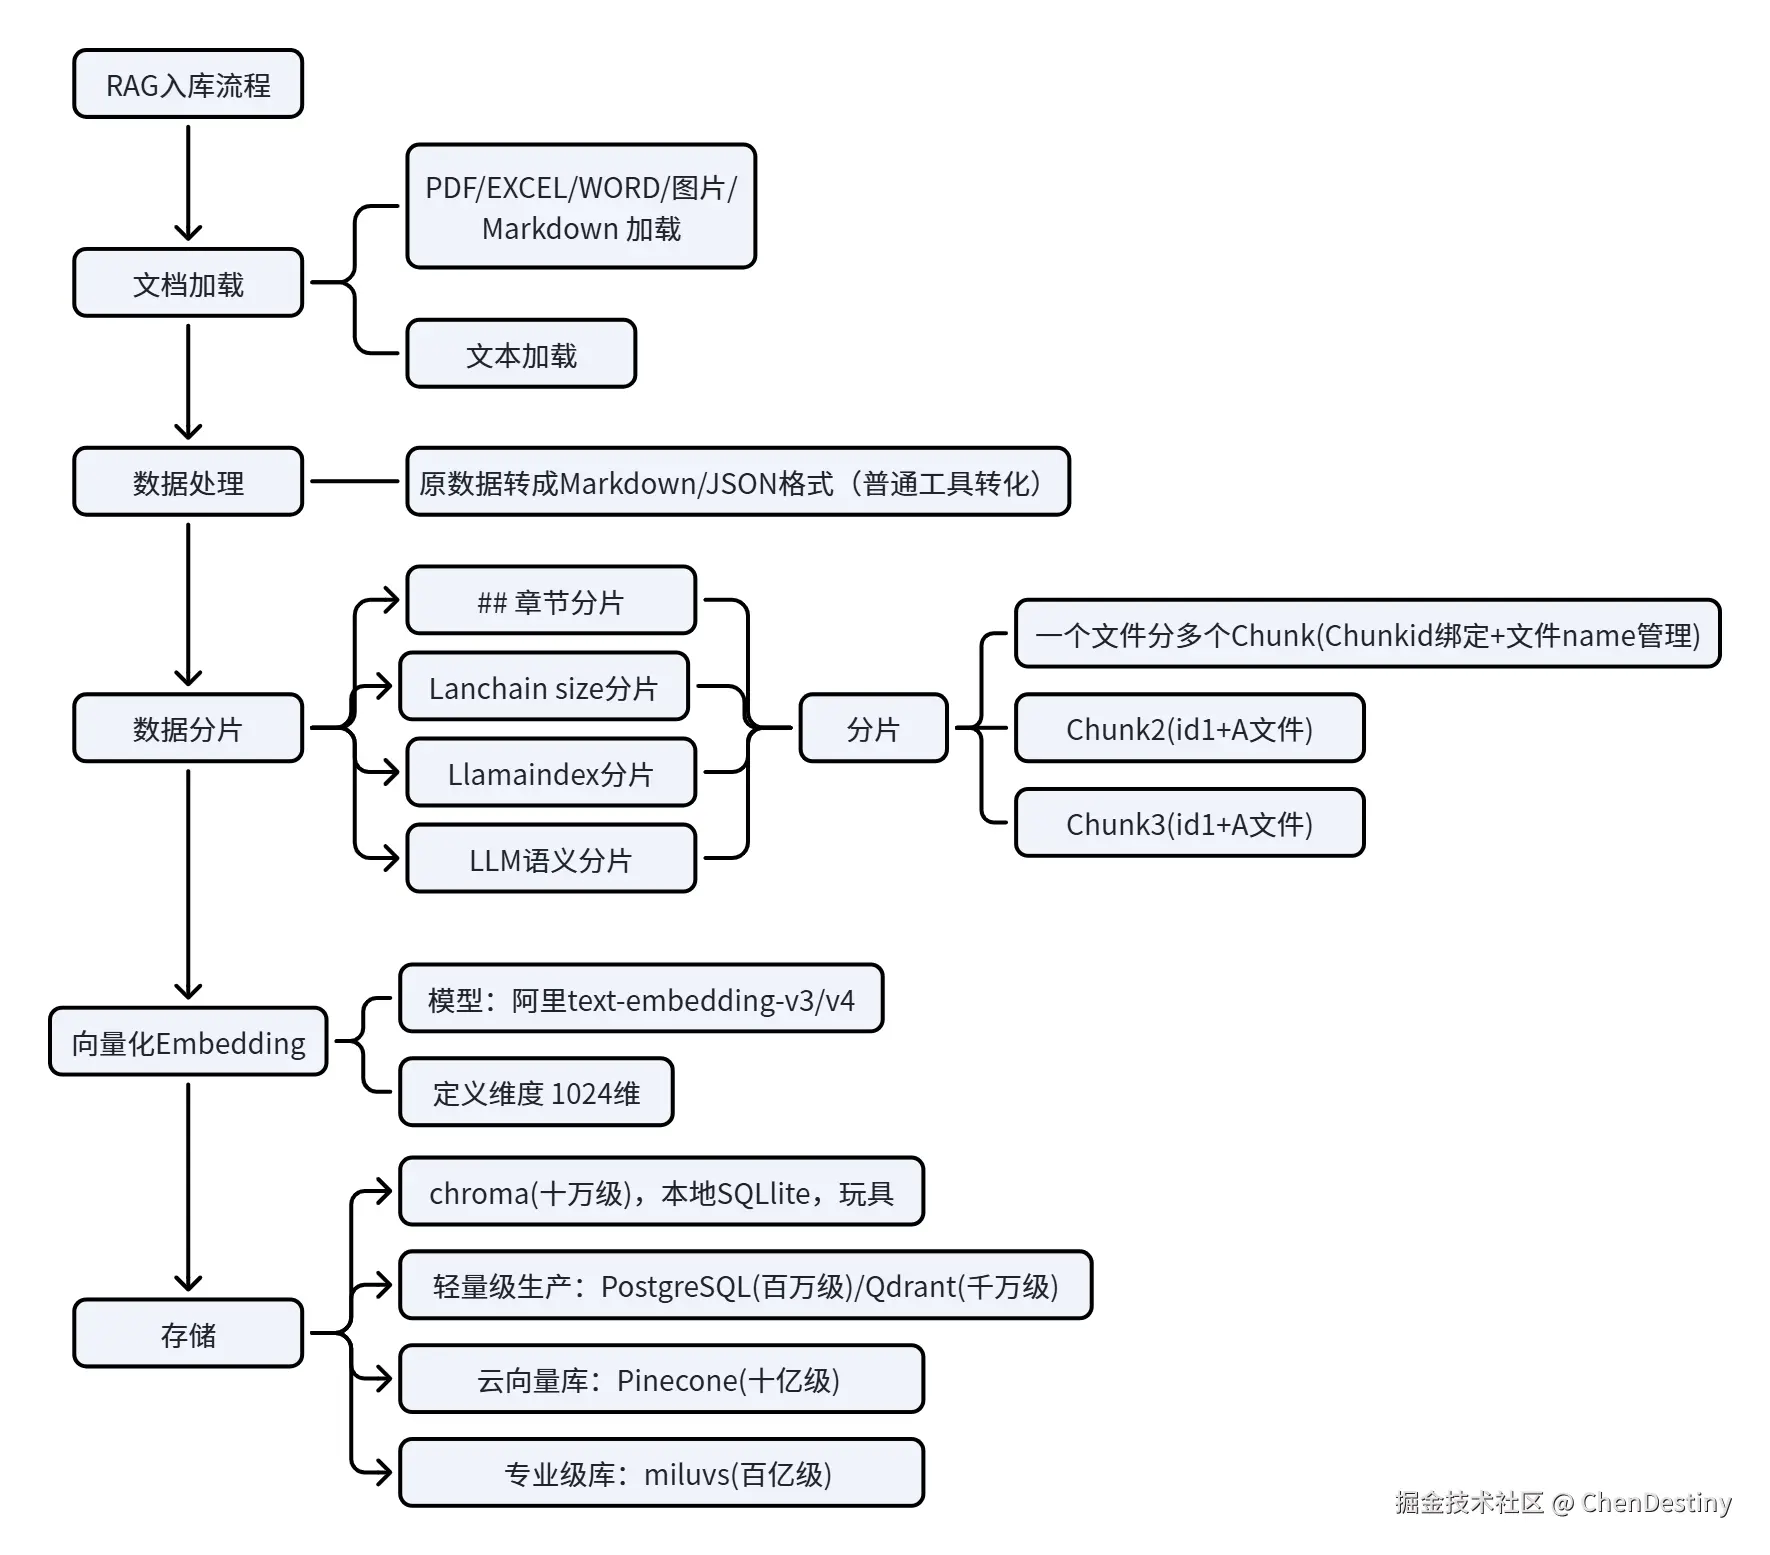
离线这步把所有"将来要被查到"的资料准备好。先记一个反直觉的点:这步是慢活、脏活、决定上限的活。在线检索再花哨,库里存的东西本身是糊的,答案一定糊——垃圾进、垃圾出,检索只负责不加分不减分地传递质量。
第 1 步:文档加载,别追求全格式通吃
第一关是把不同格式的资料读进来,难度是递增的:
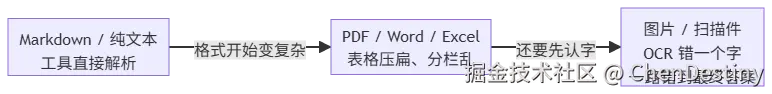
我的经验:上来别追求"全格式通吃",先把最常见的一两类格式跑通,长尾格式后期补,别一开始就纠结能不能读 PPT。
第 2 步:数据处理,最容易被低估的一环
原文读进来往往是一坨半结构化甚至非结构化的内容。这步做的是统一格式:把 PDF、Word、OCR 的结果都处理成 Markdown 或 JSON 这种结构整齐的样子。
普通工具(pdfplumber、docx2txt、Tesseract)能干 80% 的活。剩下 20%——多栏排版、扫描件表格、嵌套公式——别硬扛,写规则化后处理或人工抽检兜底。
【我的踩坑】 这步听着不起眼,我最早没重视,把扫描件 OCR 结果直接喂下游,结果分片阶段一直找不到段落边界,召回全是半句话。后来老老实实补了版面分析,立刻顺了。
第 3 步:数据分片,入库最要紧的一步
原则就一句:别让一块里塞太多无关内容,也别让一句话被拦腰截断。常见切法:
| 切法 | 适合场景 | 我的评价 |
|---|---|---|
按章节分片 | 结构化文档 | 一上来最好用这个,先把"明显分段"吃满 |
按 size 硬切 | 通用兜底 | 按 token 数切,最糙也最常用 |
LlamaIndex 分片器 | 半结构化 | 节点关系保留更好,适合树状文档 |
LLM 语义分片 | 复杂语义 | 让模型判断哪里"逻辑完整",质量最高但贵 |
实际跑起来经常几路并用——先按章节粗切、再按 size 细修、特别难的章节上 LLM 语义分片兜底,别迷信单一手段。
切出来的每一片叫一个 Chunk。Chunk 的管理比切法本身还容易被忽视:
(1)用 ChunkId + 文件名绑定,能溯源到原始文件,最推荐
(2)同文档多 Chunk 共享文档级 ID,便于聚合去重
(3)metadata 里至少带文件名、章节路径、ChunkId、原始位置——这几个字段一旦丢了,后期排查"这条答案是从哪段材料捞的"会要命
第 4 步:向量化,模型选定就别换
把每个 Chunk 变成一串数字向量,让"语义"可以被数学比较。我用阿里 text-embedding-v3/v4,1024 维:国产够用、成本友好;维度过大存得贵检索慢,过小语义撞车。
一条红线:模型选定就别换——不同模型的向量空间不通用,换一次等于整库重建,代价极大。
第 5 步:存储,按规模挑库
存向量不是挑最厉害的,是挑跟数据量匹配的:
| 规模 | 推荐 | 说明 |
|---|---|---|
十万级 | chroma(本地 SQLite,demo 玩具级) | 学习、单机验证 |
百万/千万级 | PostgreSQL + pgvector / Qdrant | 轻量生产首选 |
十亿级 | Pinecone(云) | 免运维,省心但贵 |
百亿级 | Milvus(国产) | 专业级,自建集群 |
我的路径:小项目起步 chroma,量起来切 PostgreSQL + pgvector——渐进式升级比一上来就堆 Milvus 务实得多。
三、RAG 检索流程(在线问答)
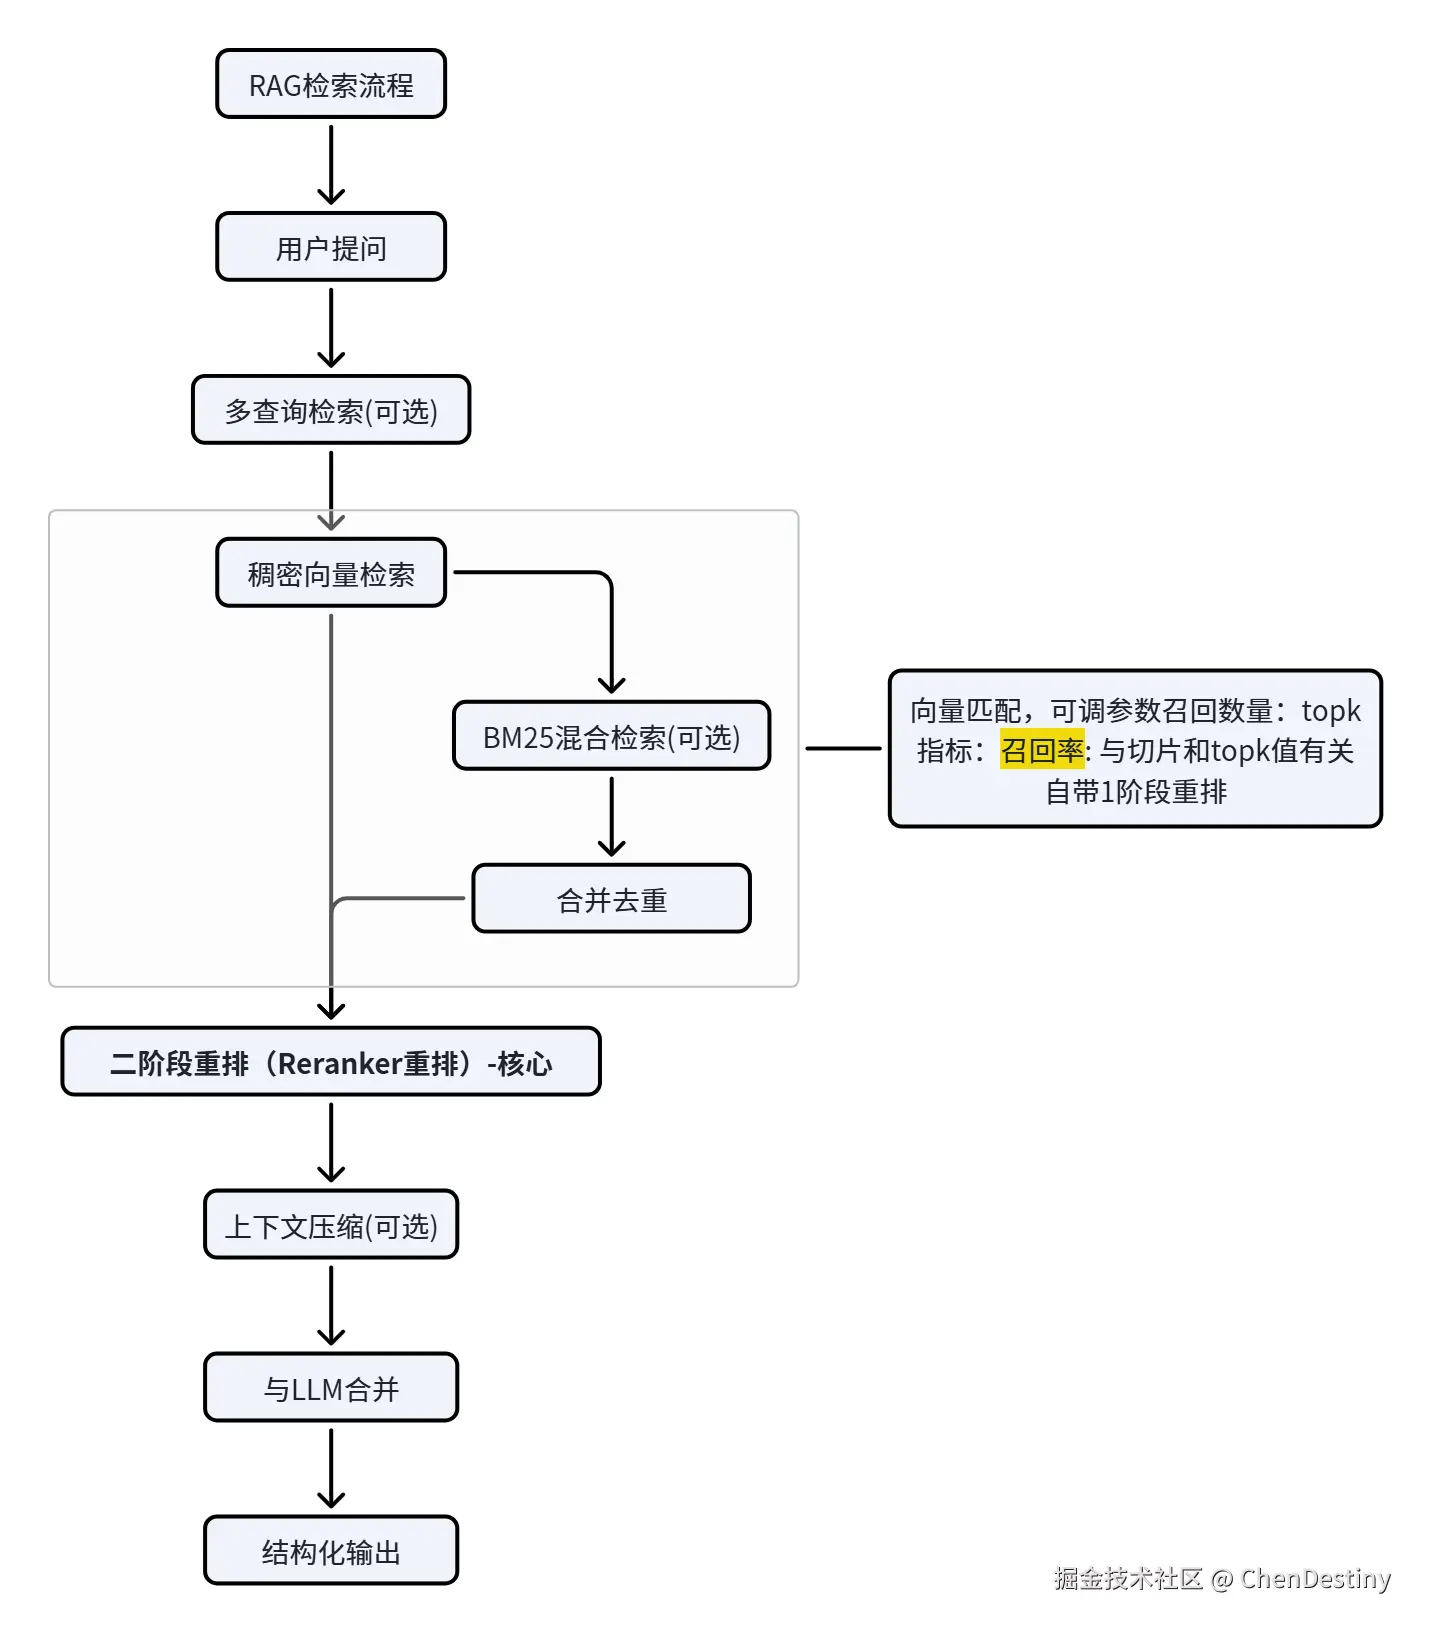
在线这步只干一件事:把用户的问题翻译成"库能听懂的话",再把捞回来的结果交给模型。
第 1 步:用户提问
用户输入的一句话。"我打算退这个订单"——这八个字对人是清楚的,对库是不清楚的。
第 2 步:多查询检索(可选)
让模型先帮用户把口语改写成多个更适合检索的查询。上面那句可能改写成"订单退货流程 / 如何取消订单 / 退单的必要条件",一组查询分别去查再合并。
对"用户表达差"的场景收益大;表达准确的小项目可以先关掉省 token。
第 3 步:混合检索,两条腿走路
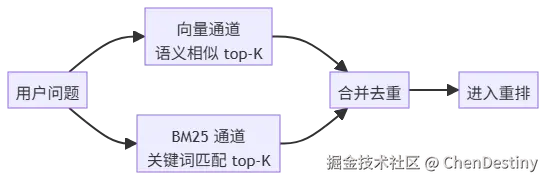
稠密向量检索是主力:把用户问题也变成向量,跟库里每条算相似度,捞回 top-K。
但纯向量有个老毛病:关键词强、语义弱的查询会挂。用户搜"HR-2024 制度",向量把这条和"招聘流程"判得很像,可人家要的就是一份精确文档。
所以常规做法是加一路 BM25(关键词匹配),两通道各自召回再合并去重:
这个环节最值得调的参数是 topk:
| 调参思路 | 召回率 | 精度 | 适合 |
|---|---|---|---|
topk 小 | 低 | 高 | 答案唯一、问题简短 |
topk 大 | 高 | 低 | 开放问题、需要扩展上下文 |
调 topk + 调切片粒度 | 中 | 中 | 大多数生产场景 |
关键指标是召回率,跟切片粒度和 topk 都强相关。召回率不上去,后面做得再花哨都白搭。
第 4 步:二阶段重排 Reranker【核心】
粗召回捞回来一堆 Chunk,谁排前面?再上一个Reranker——专门给"问题-段落"相关性精细打分的模型,按分数重排,把最相关的顶进 Top-N。
这一环节是线上 RAG 最值得投入的优化点,没有之一。同一份召回,重排前后效果差得肉眼可见:我自己的项目加上 Reranker 后,用户评价从"勉强能用"直接跳到"愿意用"。
提醒一句:很多向量库自带"按相似度排序",那只是一阶段的原始打分;专业 Reranker 是在它之上再做二阶段精排,别搞混。
第 5 步:上下文压缩(可选)
捞回来的 Chunk 长短不一,有的全是废话。这步让模型帮你摘要压缩:只提炼"答这个问题需要的信息"再进 prompt,省 token、降噪声。
代价是多一次模型调用,按业务规模决定开不开。
第 6 步:与 LLM 合并,结构化输出
最后把"用户问题 + 重排后的 Top-N 片段"塞进 prompt,让模型照资料作答。输出两种形态:
(1)自然语言回答:客服、问答系统
(2)结构化 JSON / 字段:后端二次处理——工单创建、数据录入
把回答拆成字段落库,是 RAG 在企业里最常见的落地形态,它把"对话"做成了"办事"。
四、Query 改写与召回优化
基础流程跑通后,很快会发现一个扎心的事实:用户问的话,跟他想找的资料,经常不是一套说法。他问"怎么把账号注销掉",库里存的是"用户账户注销流程说明"——字面完全对不上。
我常用的几层优化是叠着上的:
(1)Query 改写:检索前让模型把"人话"翻译成"库话",必要时拆子问题
(2)混合检索:向量 + 关键词两条腿
(3)Reranker 重排:粗召回后精排
(4)分片粒度调整:切片策略是召回的天花板,文档结构变了就要重切
召回飘了怎么判断?最直接的办法是肉眼看:把每次检索捞回的片段打出来看对不对题。我的经验:召回质量差,十有八九是切分粒度或问题表述的锅,不是模型不行。
五、联网搜索补充
前面说的检索范围都是你自己的资料,但模型还有一个硬伤:知识有截止日期。今天刚发的政策、刚上的产品,它一概不知。这时候光靠内部库不够,得让它在回答前先去网上摸一圈。
联网搜索补的就是新鲜度这个缺口,做法跟 RAG 一脉相承:提问后先判断有没有时效性,有就丢给搜索引擎/API 捞实时结果,把网页片段和内部资料一起拼进上下文。凡是带"最新、今年、最近"这类词的问题,几乎都得走这步,否则模型只能拿过期知识硬答。
但要当心噪声:网上信息鱼龙混杂,搜回来的内容得做清洗和可信度判断,别让一条谣言带偏整个回答。怎么筛、怎么信,还是得自己把关。
结尾
整套 RAG,值得死磕的就两处:入库的切片质量,检索的重排。其他环节先跑通再说,别在花哨处用力。下一步拿自己的文档跑一遍全链路,把检索片段打出来肉眼过一遍,比读十篇教程都清楚。