最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
AI 本地模型部署
时间:2026-08-07 10:51:00 编辑:袖梨 来源:一聚教程网
很多人以为 AI 只能在云端使用,用 ChatGPT 时,数据要传到 OpenAI 的服务器,用 Claude 时,请求要发送到 Anthropic 的数据中心。
其实, AI 模型完全可以在你自己的电脑上运行 。
想象一下:没有网络也能用 AI,敏感数据不会离开你的电脑,不需要为每次调用付费,想怎么定制就怎么定制。
这就是本地模型部署的价值。
本模块将带你从零开始,在自己的电脑上跑起第一个本地 AI 模型。
为什么需要本地 AI
云端 AI 很方便,但本地 AI 有不可替代的优势。
数据隐私保护
这是很多人选择本地部署的首要原因。
如果你要处理的是合同、病历、财务数据、内部文档,把这些数据传到第三方服务器是有风险的。
本地运行时, 所有数据都在你自己的电脑上处理,不会离开你的设备 。
无网络环境使用
飞机上、火车上、网络不稳定的地方,云端 AI 用不了。
本地模型下载一次后,永久可用,不需要网络连接。
成本控制
云端 AI 按调用次数或 Token 收费,用得多了也是一笔不小的开支。
本地模型一次性下载,之后随便用,不需要额外付费。
定制化可能
云端模型你没法改,只能用人家提供的功能。
本地模型你可以微调、可以量化、可以修改提示词模板,可以完全按照自己的需求定制。
这些优势对比:
| 特性 | 云端 AI | 本地 AI |
|---|---|---|
| 数据隐私 | 数据需上传 | 数据完全本地化 |
| 网络依赖 | 必须联网 | 无需网络 |
| 使用成本 | 按次收费 | 一次下载,无限使用 |
| 定制能力 | 受限 | 完全可控 |
| 使用便利性 | 开箱即用 | 需要配置 |
| 响应速度 | 取决于网络 | 取决于硬件 |
不是说云端 AI 不好,而是说两者各有适用场景。日常闲聊用云端,处理敏感数据用本地;简单任务用云端,特殊定制用本地。
硬件需求评估
本地模型能不能跑、跑得多快,主要看你的硬件配置。
CPU 推理 vs GPU 推理
模型运行有两种方式:CPU 推理和 GPU 推理。
CPU 推理就是用电脑的主处理器跑模型,优点是兼容性好,几乎所有电脑都能跑;缺点是速度慢,大模型可能要等很久。
GPU 推理用显卡跑,核心优势是 并行计算能力强,跑模型速度快几十倍 。
对于 NVIDIA 显卡,需要安装 CUDA 工具包;对于 AMD 显卡,可以用 ROCm;对于 Intel 显卡,可以用 OpenVINO。
显存需求与模型大小的关系
显存(VRAM)决定了你能跑多大的模型。
模型参数越多,需要的显存越大。但通过量化技术,可以用更小的显存跑更大的模型。
| 显存大小 | 可运行的模型(FP16) | 可运行的模型(量化后) | 推荐场景 |
|---|---|---|---|
| 8 GB | 7B 模型较勉强 | 7B(Q4)、13B(Q4)勉强 | 简单对话、轻量任务 |
| 16 GB | 7B、13B 模型 | 7B、13B(Q4/Q8)、33B(Q4) | 日常使用、性价比最高 |
| 24 GB | 7B、13B、33B 模型 | 7B、13B、33B(Q4/Q8)、70B(Q4) | 专业用途、流畅体验 |
| 48 GB+ | 33B、70B 模型 | 所有主流模型 | 研究、生产环境 |
Mac M 系列的优势
苹果 Silicon(M1、M2、M3 系列芯片)在本地 AI 方面有独特优势。
Apple 的 Metal 框架和统一内存架构,让 Mac 跑本地模型效率很高。
统一内存意味着 CPU 和 GPU 共享内存 ,显存不够时可以自动借用内存。
一台 16GB 统一内存的 MacBook Pro,就能流畅跑 7B、13B 的量化模型。
推荐配置方案
根据不同的预算和需求,这里有几个配置方案:
| 方案 | 配置 | 适合人群 | 预期体验 |
|---|---|---|---|
| 入门方案 | 任意电脑(8GB 内存以上) | 想体验本地 AI 的新手 | 能跑小模型,速度较慢 |
| 性价比方案 | 16GB 内存 + 6GB 以上显存 | 个人日常使用 | 7B/13B 模型流畅运行 |
| 专业方案 | 32GB 内存 + 12GB 以上显存 | 开发者、研究人员 | 33B 模型流畅运行 |
| Mac 方案 | M1/M2/M3 + 16GB 统一内存 | Mac 用户首选 | 7B/13B 模型流畅运行 |
不要被大模型这个词吓倒。今天的量化技术已经能让 7B 模型在普通电脑上流畅运行,而 7B 模型的能力对于大多数日常任务已经足够。
Ollama:最简单的本地 AI 工具
- Ollama 官网:https://ollama.com/
- Ollama 支持模型列表:https://ollama.com/search
- Ollama 教程:https://www.runoob.com/ollama/ollama-tutorial.html
Ollama 是目前最流行的本地模型工具,一句话概括: 像安装 App 一样安装模型,像用命令行一样用 AI 。
安装与配置
Ollama 支持 macOS、Linux、Windows,安装过程非常简单。
安装包下载地址:https://ollama.com/download
一条命令安装:
curl -fsSL https://ollama.com/install.sh | sh
macOS 用户可以直接下载安装包,或者用 Homebrew 安装:
# macOS 使用 Homebrew 安装brew install ollama# 或者下载安装包:https://ollama.com/download
Windows 用户直接从官网下载安装包运行即可。
安装完成后,启动 Ollama 服务:
ollama serve
看到服务启动成功后,就可以开始用了。
下载模型
Ollama 的模型库非常丰富,包括 Llama、Qwen、Gemma、Mistral 等主流模型。
下载模型只用一条命令:
实例
# 下载 Llama 3(8B 参数)ollama pull llama3
# 下载 Qwen(通义千问,中文友好)
ollama pull qwen
# 下载 Gemma(Google 出品)
ollama pull gemma
# 下载 Mistral
ollama pull mistral
也可以使用 ollama run + 模型名 命令,如果没有指定的模型会主动下载:
ollama run qwen
运行 qwen 模型,如果没有会下载。
每个模型有不同的版本,比如 8B、70B,或者不同的量化版本。
你可以用 ollama list 查看已经下载的模型:
ollama list
输出类似:
NAME ID SIZE MODIFIEDqwen3.5:latest 6488c96fa5fa 6.6 GB 3 months ago
命令行使用
模型下载后,直接运行就可以开始对话:
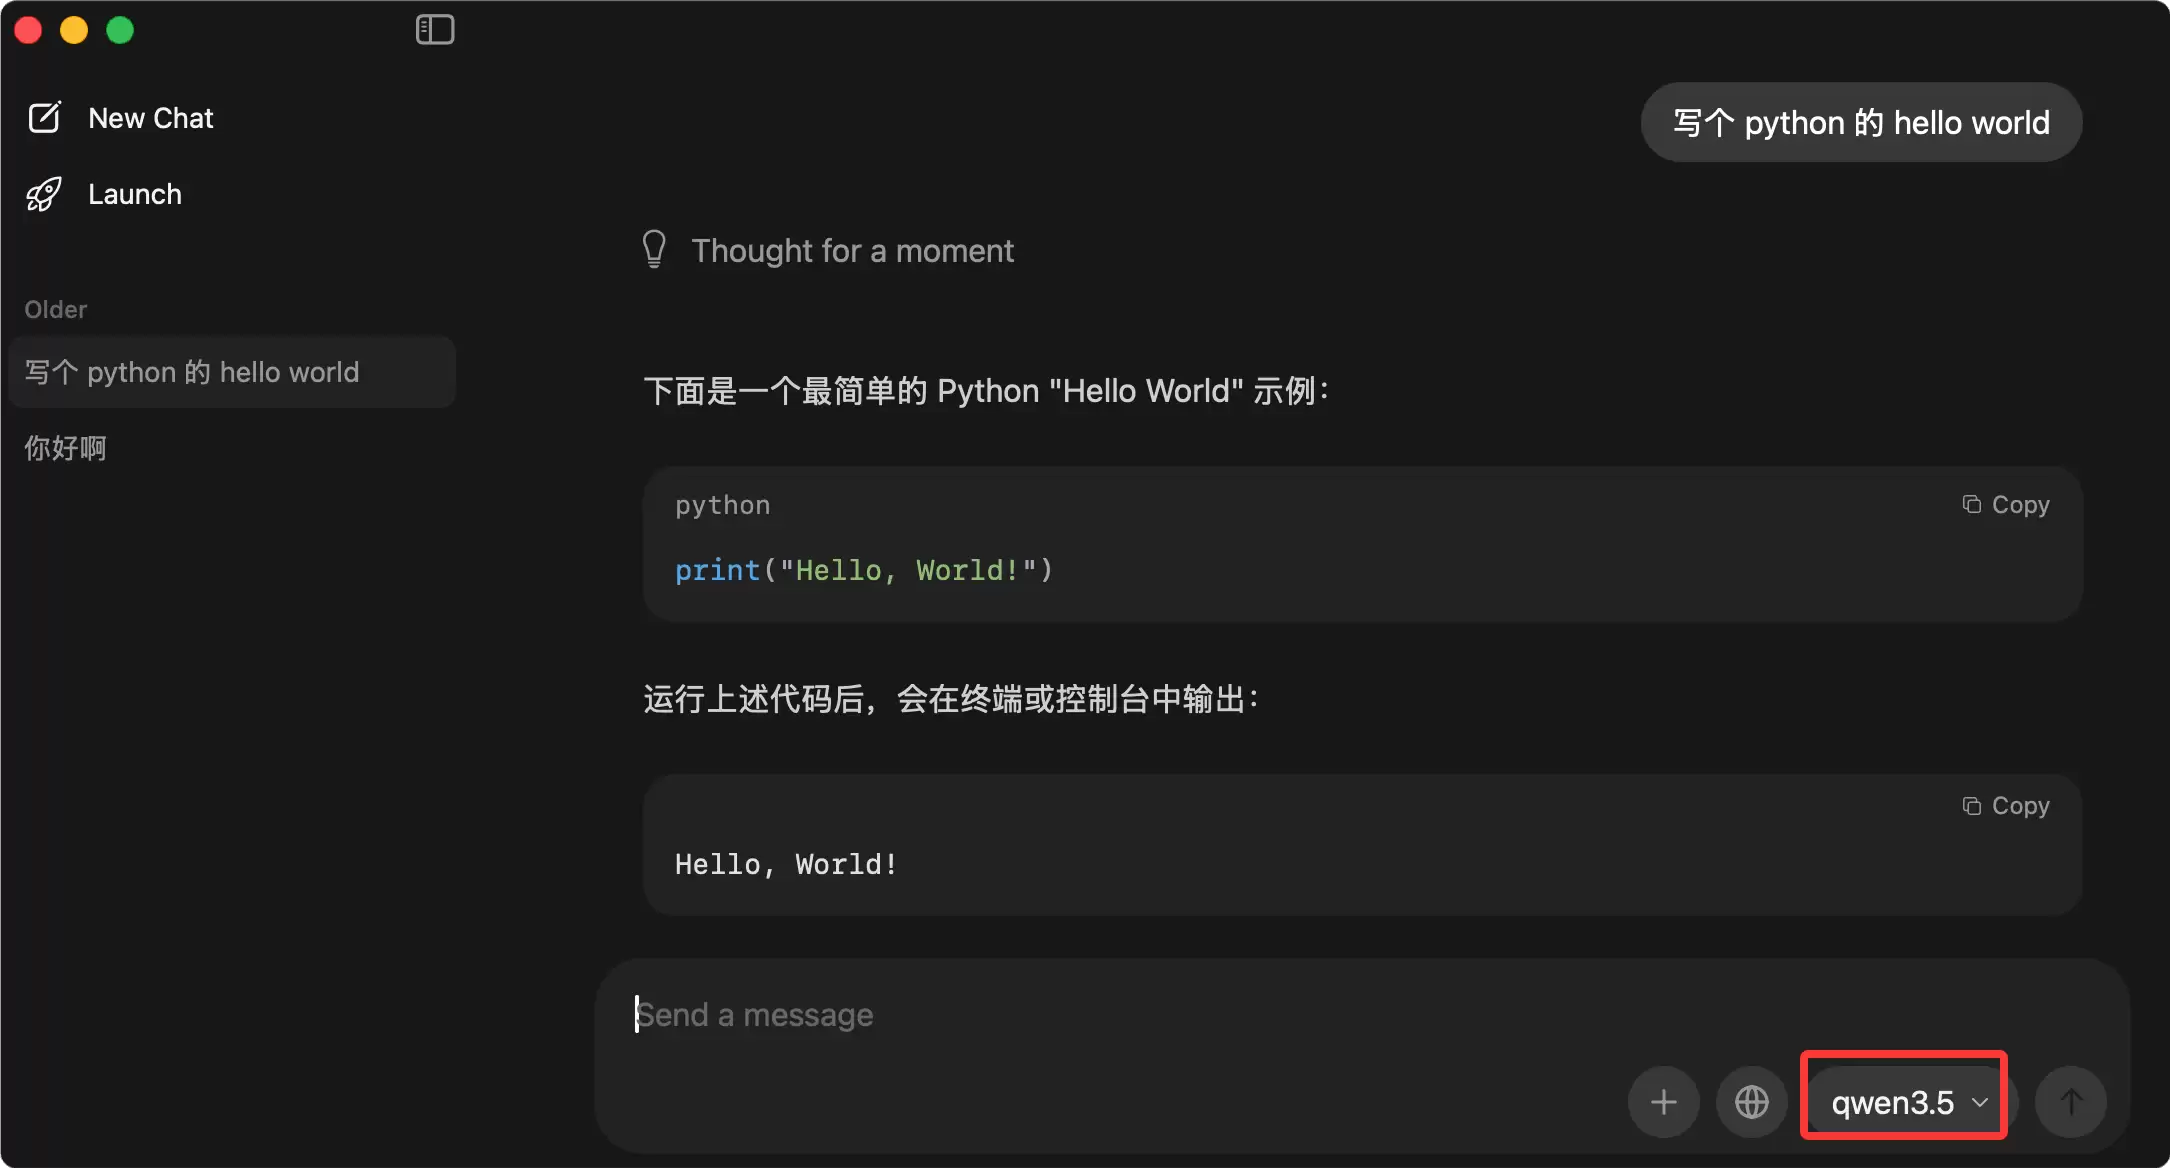
# 运行 Llama 3,没有会下载ollama run llama3# 运行 Qwen,没有会下载ollama run qwen3.5
qwen3.5 用来做普通任务还是绰绰有余的:
然后你就可以直接和模型对话了:
>>> 你好,请介绍一下你自己你好!我是 Llama 3,由 Meta 开发的 AI 助手。我可以帮你回答问题、写作、编程、分析数据等。有什么我可以帮你的吗?>>> 用 Python 写一个 Hello World 程序好的,这是一个简单的 Python Hello World 程序:print("Hello, World!")>>> /bye # 输入 /bye 退出常用命令:
| 命令 | 功能 | 示例 |
|---|---|---|
| ollama pull <model> | 下载模型 | ollama pull llama3 |
| ollama run <model> | 运行模型 | ollama run llama3 |
| ollama list | 列出已安装模型 | ollama list |
| ollama rm <model> | 删除模型 | ollama rm llama3 |
| ollama show <model> | 查看模型信息 | ollama show llama3 |
API 接口调用
Ollama 自带 HTTP API,你可以用代码调用,而不只是在命令行用。
默认情况下,Ollama 在 http://localhost:11434 提供 API 服务。
用 Python 调用 Ollama API:
实例
# 文件路径:/Users/runoob/ollama_test.py# 用 Python 调用 Ollama API
import requests
import json
# Ollama API 地址
OLLAMA_URL ="http://localhost:11434/api/generate"
def ask_ollama(prompt: str, model: str="llama3") ->str:
"""
向 Ollama 发送请求,获取模型回复
Args:
prompt: 用户输入的提示词
model: 使用的模型名称,默认为 llama3
Returns:
模型的回复文本
"""
# 构造请求数据
payload ={
"model": model,# 使用的模型
"prompt": prompt,# 用户输入
"stream": False# 不使用流式输出,一次性返回
}
try:
# 发送 POST 请求
response = requests.post(OLLAMA_URL, json=payload)
response.raise_for_status()# 检查请求是否成功
# 解析返回的 JSON
result = response.json()
return result.get("response","")
except requests.exceptions.ConnectionError:
return"错误:无法连接到 Ollama 服务,请确认 Ollama 已启动"
except requests.exceptions.RequestExceptionas e:
return f"请求错误:{str(e)}"
# 测试一下
if __name__ =="__main__":
# 测试问题 1
question1 ="请用一句话介绍 RUNOOB 教程"
answer1 = ask_ollama(question1)
print(f"问:{question1}")
print(f"答:{answer1}")
print("-" * 50)
# 测试问题 2
question2 ="写一个 Python 函数,计算斐波那契数列"
answer2 = ask_ollama(question2)
print(f"问:{question2}")
print(f"答:{answer2}")
运行这个脚本:
实例
# 先安装 requests 库(如果还没装)pip install requests
# 运行脚本
python ollama_test.py
如果你想用更高级的封装,可以使用 Ollama 的官方 Python 库:
实例
# 文件路径:/Users/runoob/ollama_advanced.py# 使用 Ollama Python 库
# 先安装:pip install ollama
import ollama
def chat_with_runoob():
"""
使用 Ollama Python 库进行多轮对话
"""
# 消息历史
messages =[
{
"role": "system",
"content": "你是一个友好的编程助手,名叫 RunoobBot。你的回答要简洁、实用,多用代码示例。"
}
]
print("RunoobBot 已启动!输入 'quit' 退出。")
print("-" * 50)
whileTrue:
# 获取用户输入
user_input =input("你:")
if user_input.lower()in["quit","exit","退出"]:
print("再见!")
break
# 添加用户消息到历史
messages.append({
"role": "user",
"content": user_input
})
# 调用模型
response = ollama.chat(
model="llama3",
messages=messages
)
# 获取回复
assistant_message = response["message"]["content"]
print(f"RunoobBot:{assistant_message}")
print("-" * 50)
# 添加助手回复到历史
messages.append({
"role": "assistant",
"content": assistant_message
})
if __name__ =="__main__":
chat_with_runoob()
与 Open WebUI 集成
命令行虽然方便,但图形界面更友好。
Open WebUI 是一个非常漂亮的 Web 界面,可以连接 Ollama,让你像用 ChatGPT 一样用本地模型。
安装 Open WebUI:
实例
# 使用 Docker 安装 Open WebUIdocker run -d-p3000:8080--add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui --restart always ghcr.io/open-webui/open-webui:main
# 如果不用 Docker,也可以用 pip 安装
pip install open-webui
open-webui serve
安装完成后,在浏览器打开 http://localhost:3000,你就能看到一个和 ChatGPT 很像的界面了。
Ollama + Open WebUI 是目前最推荐的本地 AI 组合——安装简单、界面友好、功能强大,适合绝大多数用户。
LM Studio:图形界面操作
如果你不喜欢命令行,LM Studio 是一个很好的选择—— 纯图形界面,下载模型、运行模型都在窗口里完成 。
安装 LM Studio
LM Studio 支持 Windows、macOS、Linux。
从官网 https://lmstudio.ai 下载安装包,直接安装即可。
模型下载与管理
打开 LM Studio,左侧就是模型库。
LM Studio 会自动列出同一个模型的不同版本:
| 版本 | 说明 | 推荐场景 |
|---|---|---|
| Q4_K_M | 4-bit 量化,质量损失小 | 大多数人的选择 |
| Q5_K_M | 5-bit 量化,质量更好,体积稍大 | 显存充足时选这个 |
| Q8_0 | 8-bit 量化,接近原生质量 | 追求质量,显存够大 |
| FP16 | 全精度,体积最大 | 研究用途 |
下载好的模型会出现在 "My Models" 列表里。
本地 API 服务
LM Studio 也可以提供 API 服务,兼容 OpenAI 的 API 格式。
这意味着你写的 OpenAI 代码,只需改一下 API 地址和 Key,就能用本地模型了。
实例
# 文件路径:/Users/runoob/lmstudio_openai.py# LM Studio 兼容 OpenAI API 格式
from openai import OpenAI
# 连接到 LM Studio 本地服务器
# 注意:需要先在 LM Studio 中开启服务器
client = OpenAI(
base_url="http://localhost:1234/v1",
api_key="lm-studio"# LM Studio 用这个占位就行
)
def ask_local_model(prompt: str, system_prompt: str="你是一个有用的助手。") ->str:
"""
通过 OpenAI 兼容接口调用 LM Studio 本地模型
"""
response = client.chat.completions.create(
model="local-model",# 这个字段会被 LM Studio 忽略
messages=[
{"role": "system","content": system_prompt},
{"role": "user","content": prompt}
],
temperature=0.7,
)
return response.choices[0].message.content
# 测试
if __name__ =="__main__":
question ="介绍一下 RUNOOB 教程的特色"
answer = ask_local_model(
prompt=question,
system_prompt="你是 Runoob 的专属客服,专业回答关于编程学习的问题。"
)
print(f"问:{question}")
print(f"答:{answer}")
这个特性非常有用——你可以用同一套代码,根据需要在云端模型和本地模型之间切换。
对于刚接触本地 AI 的用户,我推荐:先用 LM Studio 上手,了解基本概念和操作;熟悉后再用 Ollama 做自动化和集成。
模型量化入门
量化是让大模型在普通电脑上跑起来的关键技术—— 用更少的显存跑更大的模型,同时保持大部分能力 。
什么是量化
简单说,量化就是降低模型参数的精度。
原生模型通常用 16 位浮点数(FP16)或 32 位浮点数(FP32)存储每个参数。
量化后,我们用 8 位整数(INT8)甚至 4 位整数(INT4)来存储。
精度降低了,但体积和显存需求也大大降低了。
举个例子:
| 精度 | 7B 模型大小 | 13B 模型大小 | 显存需求 | 质量损失 |
|---|---|---|---|---|
| FP16 | 13 GB | 26 GB | 高 | 无 |
| Q8_0 | 7 GB | 13 GB | 中 | 很小 |
| Q5_K_M | 5 GB | 9 GB | 低 | 可接受 |
| Q4_K_M | 4 GB | 7 GB | 很低 | 轻微 |
| Q3_K_M | 3 GB | 5 GB | 极低 | 明显 |
经验是:Q8 量化几乎感觉不到质量下降,Q4 量化在大多数任务上也够用。
GGUF 格式详解
GGUF 是目前最流行的量化模型格式。
GGUF 的前身是 GGML,由 llama.cpp 项目开发。
这个格式的优势:
第一, 跨平台兼容性好 ——Windows、macOS、Linux 都能用,CPU、GPU 都能跑。
第二, 支持多种量化级别 ——从 FP16 到 Q3 都有,按需选择。
第三, 推理速度快 ——针对 CPU 和 GPU 做了大量优化。
现在大多数本地模型工具(Ollama、LM Studio、llama.cpp)都支持 GGUF 格式。
Q4/Q8 量化的区别
Q4 和 Q8 是最常用的两个量化级别。
Q8 量化是 8 位,每个参数用 8 位整数存储,Q8 的优点是 质量损失极小,几乎与原模型一致 ,缺点是体积还不够小。
Q4 量化是 4 位,每个参数用 4 位整数存储,Q4 的优点是 体积小、速度快 ,缺点是在复杂任务上质量下降比较明显。
怎么选择:
| 场景 | 推荐量化级别 | 理由 |
|---|---|---|
| 显存非常有限(8GB 以下) | Q4_K_M | 能用是第一位的 |
| 日常对话、简单任务 | Q4_K_M | 性价比最高 |
| 写作、编程、分析 | Q5_K_M 或 Q6_K | 质量和速度平衡 |
| 追求最佳质量 | Q8_0 | 接近原生质量 |
AWQ/GPTQ 量化方案
除了 GGUF 的量化方式,还有两种常用的量化方案:AWQ 和 GPTQ。
AWQ(Activation-aware Weight Quantization)的特点是 保留对结果影响大的权重 ,量化后质量损失更小。
GPTQ(Gradient-based Post-Training Quantization)的特点是 用梯度信息优化量化 ,适合有 GPU 的场景。
这两种方案主要用在支持 CUDA 的 NVIDIA 显卡上。
简单对比:
| 量化方案 | 适用硬件 | 速度 | 质量 | 推荐工具 |
|---|---|---|---|---|
| GGUF | CPU + 各种 GPU | 快 | 好 | Ollama、LM Studio |
| AWQ | NVIDIA GPU | 很快 | 很好 | vLLM、Text Generation WebUI |
| GPTQ | NVIDIA GPU | 很快 | 很好 | AutoGPTQ、ExLlama |
对于初学者,不用纠结这些技术细节——直接用 Ollama 或 LM Studio 里推荐的 Q4_K_M 版本就行,这是经过大量验证的最佳平衡点。
模型选择指南
现在开源模型成百上千,选择适合自己的模型很重要。
7B/13B/70B 模型对比
模型的参数量是一个重要指标——7B、13B、70B 是最常见的规格。
| 规格 | 显存需求(Q4) | 推理速度 | 能力水平 | 适用场景 |
|---|---|---|---|---|
| 7B | 4-6 GB | 很快 | 够用 | 日常对话、简单任务 |
| 13B | 7-10 GB | 快 | 良好 | 写作、编程、分析 |
| 33B | 15-20 GB | 中等 | 优秀 | 复杂推理、专业领域 |
| 70B | 30-40 GB | 较慢 | 接近 GPT-3.5 | 研究、生产环境 |
大多数人的 sweet spot(最佳平衡点)是 13B Q4 量化版本——能力不错,速度也可以接受。
中文支持较好的模型推荐
很多国外模型中文能力一般,这里推荐几个对中文友好的模型:
| 模型名称 | 出品方 | 特点 | Ollama 命令 |
|---|---|---|---|
| Qwen(通义千问) | 阿里巴巴 | 中文能力强,综合能力均衡 | ollama pull qwen |
| Yi(零一万物) | 零一万物 | 中文理解好,推理能力强 | ollama pull yi |
| DeepSeek | 深度求索 | 代码能力强,中文不错 | ollama pull deepseek-coder |
| Llama 3 | Meta | 综合能力强,中文需要调教 | ollama pull llama3 |
| Gemma | 基础扎实,代码能力好 | ollama pull gemma |
中文任务首选 Qwen,它的中文理解和生成能力在开源模型中属于第一梯队。
任务特定模型选择
不同模型有不同的专长,根据任务选模型:
| 任务类型 | 推荐模型 | 理由 |
|---|---|---|
| 日常对话、问答 | Llama 3、Qwen、Mistral | 综合能力均衡 |
| 写作、文案 | Yi、Llama 3、Claude(云端) | 文采好,表达流畅 |
| 编程、代码 | DeepSeek-Coder、CodeLlama、StarCoder | 代码理解和生成能力强 |
| 数学、推理 | Llama 3、Qwen、WizardMath | 逻辑推理能力好 |
| 专业领域(医疗、法律) | 根据领域微调的模型 | 在专业数据上训练过 |
模型不是越大越好,也不是越新越好——适合自己硬件、适合自己任务的才是最好的。建议先下几个 7B 模型试试,找到感觉再升级。
实战:搭建完全离线的本地知识库
本地模型最实用的应用场景之一,是建立自己的私有知识库—— 把本地文档喂给模型,让模型基于这些文档回答问题 。
整个系统完全离线运行,数据不会离开你的电脑。
技术方案
我们用 RAG(检索增强生成)技术:
1. 把文档切分成小块
2. 用嵌入模型把每个块转换成向量
3. 向量存入向量数据库
4. 提问时,把问题也转换成向量
5. 在向量数据库中找到最相关的文档块
6. 把相关文档和问题一起送给本地大模型
7. 大模型基于文档内容回答
这个过程听起来复杂,但用现成的工具做起来很简单。
用 Ollama + LangChain 实现
我们用 Python 来实现一个简单版本:
实例
# 文件路径:/Users/runoob/local_knowledge_base.py# 完全离线的本地知识库 RAG 系统
# 先安装依赖:
# pip install langchain langchain-ollama chromadb pypdf
from langchain_ollama import OllamaLLM, OllamaEmbeddings
from langchain_community.document_loadersimport PyPDFLoader, TextLoader
from langchain.text_splitterimport RecursiveCharacterTextSplitter
from langchain_community.vectorstoresimport Chroma
from langchain.chainsimport RetrievalQA
importos
class LocalKnowledgeBase:
"""本地知识库类,实现完全离线的 RAG 功能"""
def__init__(self, model_name: str="llama3", persist_dir: str="./chroma_db"):
"""
初始化知识库
Args:
model_name: 使用的 Ollama 模型名称
persist_dir: 向量数据库持久化目录
"""
self.model_name= model_name
self.persist_dir= persist_dir
# 1. 初始化 LLM(本地模型)
self.llm= OllamaLLM(model=model_name)
# 2. 初始化嵌入模型(本地嵌入)
# 使用 nomic-embed-text,这个模型对中英文都不错
self.embeddings= OllamaEmbeddings(model="nomic-embed-text")
# 3. 向量数据库占位
self.vector_store=None
self.qa_chain=None
def load_documents(self, document_paths: list):
"""
加载文档并构建向量数据库
Args:
document_paths: 文档路径列表
"""
documents =[]
for path in document_paths:
ifnotos.path.exists(path):
print(f"警告:文件 {path} 不存在,跳过")
continue
# 根据文件扩展名选择加载器
if path.lower().endswith(".pdf"):
loader = PyPDFLoader(path)
elif path.lower().endswith(".txt"):
loader = TextLoader(path, encoding="utf-8")
else:
print(f"警告:不支持的文件类型 {path},跳过")
continue
documents.extend(loader.load())
print(f"已加载:{path}")
ifnot documents:
print("没有成功加载任何文档")
return
print(f"总共加载了 {len(documents)} 个文档片段")
# 4. 切分文档
text_splitter = RecursiveCharacterTextSplitter(
chunk_size=500,# 每个块 500 个字符
chunk_overlap=100# 块之间重叠 100 个字符
)
split_docs = text_splitter.split_documents(documents)
print(f"切分成 {len(split_docs)} 个片段")
# 5. 构建向量数据库
print("正在构建向量数据库...")
self.vector_store= Chroma.from_documents(
documents=split_docs,
embedding=self.embeddings,
persist_directory=self.persist_dir
)
print("向量数据库构建完成!")
# 6. 构建问答链
self._build_qa_chain()
def _build_qa_chain(self):
"""构建 RAG 问答链"""
ifnotself.vector_store:
print("请先加载文档!")
return
# 构建检索器
retriever =self.vector_store.as_retriever(
search_type="similarity",
search_kwargs={"k": 3}# 返回最相关的 3 个片段
)
# 构建 RAG 链
self.qa_chain= RetrievalQA.from_chain_type(
llm=self.llm,
chain_type="stuff",
retriever=retriever,
return_source_documents=True
)
def load_existing_db(self):
"""加载已有的向量数据库"""
ifos.path.exists(self.persist_dir):
self.vector_store= Chroma(
persist_directory=self.persist_dir,
embedding_function=self.embeddings
)
self._build_qa_chain()
print("已加载现有的向量数据库")
returnTrue
else:
print("没有找到现有的向量数据库")
returnFalse
def ask(self, question: str) ->dict:
"""
向知识库提问
Args:
question: 问题
Returns:
包含答案和参考来源的字典
"""
ifnotself.qa_chain:
return{"error": "请先加载文档或现有数据库!"}
# 构造提示词模板,鼓励中文回答
result =self.qa_chain.invoke({
"query": f"""请用中文回答以下问题。如果答案在上下文中,请明确指出。
如果上下文中没有答案,请诚实说"根据提供的资料无法回答"。
问题:{question}
"""
})
return{
"question": question,
"answer": result["result"],
"sources": [doc.page_contentfor doc in result["source_documents"]]
}
# ============================================
# 使用示例
# ============================================
if __name__ =="__main__":
# 1. 创建知识库实例
kb = LocalKnowledgeBase(model_name="qwen")# 用 Qwen,中文更好
# 2. 尝试加载已有数据库,否则加载文档
ifnot kb.load_existing_db():
# 准备一些文档,比如把一些 RUNOOB 教程存为 txt
sample_docs =[
"/Users/runoob/documents/runoob_python_tutorial.txt",
"/Users/runoob/documents/company_handbook.pdf",
]
kb.load_documents(sample_docs)
# 3. 交互式问答
print("=" * 50)
print("Runoob 本地知识库已启动!")
print("输入你的问题,或输入 'quit' 退出")
print("=" * 50)
whileTrue:
user_input =input("n你的问题:")
if user_input.lower()in["quit","exit","退出"]:
print("再见!")
break
ifnot user_input.strip():
continue
# 提问
result = kb.ask(user_input)
if"error"in result:
print(f"错误:{result['error']}")
continue
print(f"n回答:{result['answer']}")
print("n参考来源:")
for i, source inenumerate(result["sources"],1):
print(f"n[{i}] {source[:200]}...")
使用这个系统前,需要先下载嵌入模型:
实例
# 下载嵌入模型ollama pull nomic-embed-text
# 下载主模型(如果还没下)
ollama pull qwen
这样,你就有了一个完全在本地运行的私有知识库系统。
你可以把自己的笔记、文档、电子书放进去,让 AI 帮你检索和问答。
这个系统的所有数据都在你本地——文档在你硬盘上,向量数据库在你目录里,模型在你电脑上,完全不用担心数据泄露。
性能优化技巧
本地模型跑起来了,但怎么让它跑得更快?这里有一些实用技巧。
选择合适的量化级别
这是最简单有效的优化——量化级别越低,速度越快。
如果 Q4 能用,就不要用 Q8;如果 Q8 能用,就不要用 FP16。
调整上下文窗口大小
上下文窗口越大,需要的计算越多。
如果不需要很长的上下文,可以在 Ollama 的 Modelfile 里设置:
实例
# 创建一个自定义模型,限制上下文窗口# 新建文件 Modelfile
echo"FROM llama3
PARAMETER num_ctx 2048"> Modelfile
# 创建自定义模型
ollama create llama3-fast -f Modelfile
# 运行
ollama run llama3-fast
把上下文从默认的 8192 降到 2048,速度会快不少。
使用 GPU 加速
如果你有 NVIDIA 显卡或 Mac 的 Apple Silicon,确保 Ollama 在使用 GPU 而不是 CPU。
Ollama 会自动检测并使用 GPU,但有时候需要确认一下。
在 Ollama 启动日志里,你应该能看到类似 "Metal GPU activated" 或 "CUDA activated" 的信息。
使用更快的采样参数
有些采样参数会影响速度:
实例
# 创建一个速度优化的 Modelfile# 文件:Modelfile.fast
echo"FROM llama3
PARAMETER temperature 0.7
PARAMETER top_k 20
PARAMETER top_p 0.9
PARAMETER num_predict 256"> Modelfile.fast
# 创建并运行
ollama create llama3-optimized -f Modelfile.fast
ollama run llama3-optimized
参数说明:
| 参数 | 作用 | 优化建议 |
|---|---|---|
| temperature | 控制随机性 | 适中就行,不影响速度 |
| top_k | 限制候选词数量 | 设小一点(20-40)可提速 |
| top_p | 累积概率阈值 | 默认 0.9 就好 |
| num_predict | 最大生成 Token 数 | 根据需要限制 |
| num_ctx | 上下文窗口大小 | 够用就行,越小越快 |
关闭不必要的功能
如果你是用 API 调用,不需要流式输出的话,可以把 stream 设为 false。
这样虽然不会让推理变快,但能减少网络传输开销。
性能优化是一个平衡的艺术——速度、质量、显存,三者不可兼得。根据你的需求,找到适合自己的平衡点就行。
相关文章
- pishi-normalno:AI Agent 工具实践指南 10-03
- contract-review:实践指南 10-03
- smart-annotator:AI Agent 工具实践指南 10-03
- atlas:AI Agent 工具实践指南 10-03
- pi-kit:实践指南 10-03
- chrona:实践指南 10-03