最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
正则表达式+Python re模块详解
时间:2026-09-28 12:00:02 编辑:袖梨 来源:一聚教程网
正则表达式(Regluar Expressions)又称规则表达式,在代码中常简写为REs,regexes或regexp(regex patterns)。它本质上是一个小巧的、高度专用的编程语言。 通过正则表达式可以对指定的文本实现匹配测试、内容查找、内容替换、字符串分割 等功能。
re模块介绍
Python中的re模块提供了一个正则表达式引擎接口,它允许我们将正则表达式编译成模式对象,然后通过这些模式对象执行模式匹配搜索和字符串分割、子串替换等操作。re模块为这些操作分别提供了模块级别的函数以及相关类的封装。
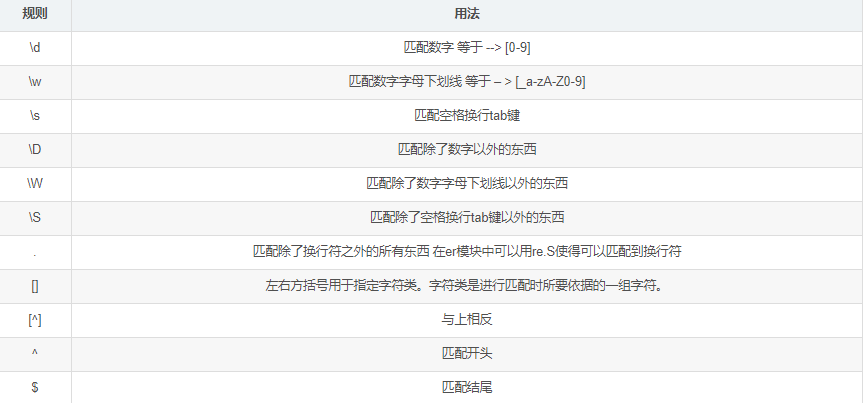
正则表达式一些小规则
①元字符
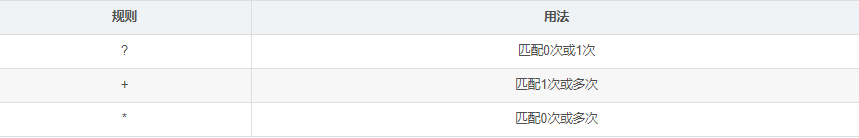
②量词
③贪婪和非贪婪匹配
总是在量词范围内尽量多匹配 - 贪婪总是在量词范围内尽量少匹配 - 惰性.*?x 匹配任意内容任意次数 遇到x就停止.+?x 匹配任意内容至少1次 遇到x就停止
④转义符问题
. 有特殊的意义,取消特殊的意义取消一个元字符的特殊意义有两种方法在这个元字符前面加 对一部分字符生效,把这个元字符放在字符组里[.()+?*]
Python --> re模块
findall 会优先显示分组内的内容 *****取消优先显示(?:正则)search 只能返回第一个符合条件的项 得到的结果需要.group取值 默认获取完整的匹配结果 通过group(n)取第n个分组中的内容
# search 还是按照完整的正则进行匹配,显示也显示匹配到的第一个内容,但是我们可以通过给group方法传参数# 来获取具体文组中的内容ret = re.search('9(d)(d)','19740ash93010uru')print(ret) # 变量 -- > <re.Match object; span=(1, 4), match='974'>if ret: print(ret.group()) # --> 974 print(ret.group(1)) # --> 7 print(ret.group(2)) # --> 4# findall # 取所有符合条件的,优先显示分组中的# search 只取第一个符合条件的,没有优先显示这件事儿 # 得到的结果是一个变量 # 变量.group() 的结果 完全和 变量.group(0)的结果一致 # 变量.group(n) 的形式来指定获取第n个分组中匹配到的内容# 加上括号 是为了对真正需要的内容进行提取ret = re.findall('<w+>(w+)</w+>','<h1>askh930s02391j192agsj</h1>')print(ret) # --> ['askh930s02391j192agsj']其他的内容在代码中有详细的注释,大家可以复制我的代码一步一步运行然后实验
以下的内容有:split sub subn math,compile,finditer
# split sub subn math,compile,finditer# splitres = re.split('d+', "cyx123456cyxx")print(res) # --> ['cyx', 'cyxx']res = re.split('(d+)', "cyx123456cyxx") # 保留分组print(res) # --> ['cyx', '123456', 'cyxx']# sub 替换res = re.sub('d+', '我把数字替换了', "cyx123456cyxxx123456") # 默认全部替换,当然也可以替换一次re.sub('d+','我把数字替换了',"cyx123456cyxxx123456",1)print(res) # --> cyx我把数字替换了cyxxx我把数字替换了# subn 替换了并显示替换的次数res = re.subn('d+', '我把数字替换了', "cyx123456cyxxx123456")print(res) # --> ('cyx我把数字替换了cyxxx我把数字替换了', 2)# match 这个就相当与加了个^ (和search差不多) --> 主要用来规定这个字符号必须是什么样的res = re.match('d+', 'cyx123456cyxxx')print(res) # --> Noneres = re.match('d+', '123cyx456cyxxx')print(res.group()) # --> 123# compile -- 节省代码的时间的工具# 假如同一个正则表达式要被使用多次# 节省了多次解析同一个正则表达式的时间ret = re.compile("d+")res = ret.search("cyx12456cyxXX123")print(res.group()) # --> 12456# finditer --> 节省空间ret = re.finditer("d+", "cyx123456cyxxx125644")for r in ret: print(r.group()) # --> 123456 # 125644# 怎么又节省时间又节省空间呢?ret = re.compile('d+')res = ret.finditer("cyx222231fddsf45746sdf2123sdf56456sdf10123sdf123132sdf")for r in res: print(r.group())"""2222314574621235645610123123132"""# 分组命名(?P<组名>正则) (?P=组名)# 有的时候我们要匹配的内容是包含在不想要的内容之中的,# 只能先把不想要的内容匹配出来,然后再想办法从结果中去掉# 分组命名的用法 (找两个组里面是一样的内容)exp = '<abc>asdasf54545645698asdasd</abc>00545sdfsdf</abd>'ret = re.search('<(?P<tag>w+)>.*?</(?P=tag)', exp)print(ret) # -- > <re.Match object; span=(0, 33), match='<abc>asdasf54545645698asdasd</abc'># exp2:import reret = re.search('d(d)d(w+?)(d)(w)d(d)d(?P<name1>w+?)(d)(w)d(d)d(?P<name2>w+?)(d)(w)', '123abc45678agsf_123abc45678agsf123abc45678agsf')print(ret.group('name1')) # -- > agsf_123abcprint(ret.group('name2')) # -- > agsf今日小思考
当我们有一个这样的列表:
lis = ['', 'z', 'c', 'asd', 'sdf', '', 'asd']
那么我们如何将里面的空字符删除呢?
ret = filter(lambda n: n, lis)print(list(ret)) # --> ['z', 'c', 'asd', 'sdf', 'asd']
总结
到此这篇关于正则表达式+Python re模块详解的文章就介绍到这了,更多相关正则表达式 python re模块内容请搜索一聚教程网以前的文章或继续浏览下面的相关文章希望大家以后多多支持一聚教程网!
相关文章
- js 正则学习小记之匹配字符串字面量优化篇 09-28
- js正则学习小记之匹配字符串字面量 09-28
- 浅谈js正则之test方法bug篇 09-28
- 正则表达式+Python re模块详解 09-28
- 解析正则表达式中的..?.+?的含义 09-28
- 浅谈js正则字面量//与new RegExp的执行效率 09-28