最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
轻松入门正则表达式之非贪婪匹配篇详解
时间:2026-09-28 19:10:01 编辑:袖梨 来源:一聚教程网
正则表达式(regular expression)描述了一种字符串匹配的模式(pattern),可以用来检查一个串是否含有某种子串、将匹配的子串替换或者从某个串中取出符合某个条件的子串等 非贪婪匹配
非贪婪匹配
非贪婪匹配 (.*?)
import rea = '456qwe789rty123abc're=re.findall('456(.*?)789',a)print(re)
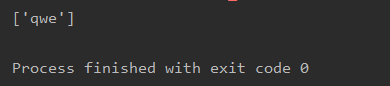
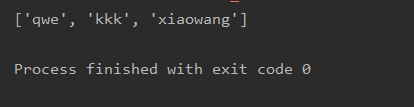
通常情况,满足匹配规则“456(.*?)789”的内容通常不止一个,那么findall()函数会从字符串的起始位置开始寻找文本A,找到后开始寻找文本B,当找到第一个文本B后,暂时停止寻找,将文本A和文本B之间的内容存入列表;然后继续寻找文本A,并重复之前的步骤,直到到达字符串的结束位置,并将所有匹配到的内容存入列表。
import rea = '456qwe789rty123456kkk789abc456xiaowang789're=re.findall('456(.*?)789',a)print(re)
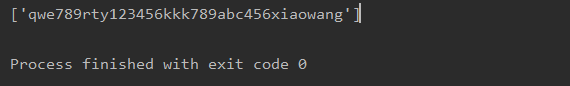
贪婪模式的话就会寻找最长的
import rea = '456qwe789rty123456kkk789abc456xiaowang789're=re.findall('456(.*)789',a)print(re)
非贪婪匹配 .*?
import rea='<a href="https://blog.**c*sdn.net/weixin_42403632/article/details/120825546" rel="external nofollow" target="_blank" data-report-click="{"spm":"3001.5501"}" data-report-query="spm=3001.5501" data-v-6fe2b6a7="">'re=re.findall('<a href="(.*?)" rel="external nofollow" rel="external nofollow" .*?',a)print(re)
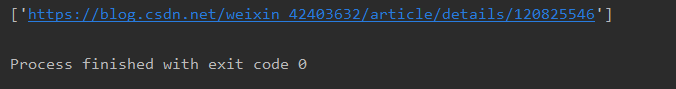
" 和 url后面的html代码用.*?代表,需要提取的是<a href="后的内容,用“(.*?)”代表
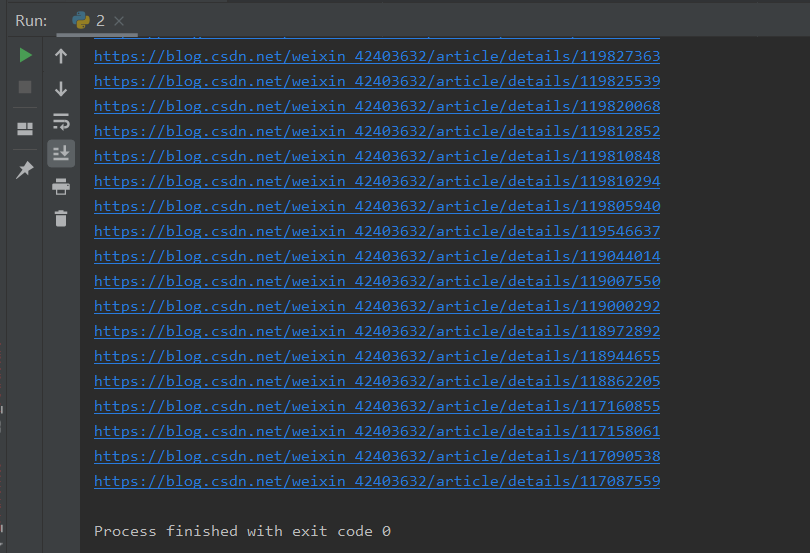
实战爬取博客专栏url
import re,requestsurl='https://blog.*c**sdn.net/weixin_42403632/category_11076268.html'headers={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:93.0) Gecko/20100101 Firefox/93.0'}html=requests.get(url,headers=headers).textre=re.findall('<a href="(.*?)" rel="external nofollow" rel="external nofollow" .*?rel="noopener">',html)for i in re: print(i)
到此这篇关于轻松入门正则表达式之非贪婪匹配篇详解的文章就介绍到这了,更多相关正则表达式 非贪婪匹配内容请搜索一聚教程网以前的文章或继续浏览下面的相关文章希望大家以后多多支持一聚教程网!
相关文章
- 利用正则表达式进行中文排版的实例教程 09-28
- 轻松掌握正则表达式findall函数详解 09-28
- 正则表达式用法详解 09-28
- 轻松入门正则表达式之非贪婪匹配篇详解 09-28
- 36个正则表达式(开发效率提高80%) 09-28
- 十分钟上手正则表达式 下篇 09-28