最新下载


热门教程
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
正则表达式的基本语法汇总篇(推荐!)
时间:2026-09-29 11:40:02 编辑:袖梨 来源:一聚教程网
1.正则表达式的基本语法
1.1两个特殊符号 ‘^’ 和 ‘$’
^ 正则表达式的起始符
^tom 表示所有以tom开头的字符串
$ 正则表达式的结束符
lucy$ 表示所有以lucy结束的字符串
^$ 结合使用
^tom$ 表示以tom开头,并以tom结束的字符串,只有tom本身
不使用 ^$
tom 表示任何包含 tom 的字符串
1.2 出现次数的表示符号 * + ?
* 表示出现 0次 或者 至少1次
+ 表示出现 至少1次
? 表示出现 0次 或者 1次
^abc*$ 表示 c 可能出现0次或者至少1次, ab必须出现1次
^bcd+$ 表示 d 至少出现1次,bc必须出现1次
^cba?$ 表示 a 可能出现0次或者1次,cb必须出现1次
^(abc)+$ 表示 abc 这个整体至少出现1次
^[abc]+$ 表示 abc 中任意一个字符,至少出现1次
^ab+c$ 表示 a 必须出现1次 ,b至少出现1次 ,c必须出现1次
1.3 指定出现次数的范围 {}
使用{m,n} 表示出现次数的范围
m–至少出现m次
n–最多出现n次
举例如下
^ab{0,2}$ -- a出现1次,b至少0次,最多2次 ^ab{0,2}$ <====> ^ab*$^ab{3}$ -- a出现1次,b出现3次 ^ab{3}$ <====> ^abbb$^ab{2,}$ -- a出现1次,b出现至少2次 ^ab{2,}$ <====> ^abb+${m,n} 可以不指定n的值,但是一定要指定m的值{k} 只有一个值 k ,表示出现的是固定的次数1.4 “或” 操作 |
^ab|cd$ -- 表示匹配结果是 ab 或 cd 其中一个
^(bc|df)a$ -- 表示匹配结果是 bca 或 dfa
^(ab|c)*d$ -- 表示匹配结果是 以 ab 开头或者 c 开头,中间任意字符,以d结尾
1.5 替代任意字符的 . 英文句号
^ab.[0-9]$ -- 表示ab开头,中间任意1个字符后面是0-9任意一个数字^[a-z].{3}$ -- 表示a-z中任意一个小写字母,后面跟三个任意字符
1.6 方括号的使用 []
[] 方括号表示某些字符允许在一个字符串中某一个特定位置出现
^[ab]$ 表示一个字符串中有一个a 或 b <===> ^a|b$
^[a-d]$ 表示一个字符串包含小写 abcdb 中的一个 <==>^[abcd]$<==>^a|b|c$
^[0-9]a$ 表示0-9中任意一个数字后面跟一个小写字母a
^[a-z]{2}$ 表示a-z中任意的字符串总共出现3个
^[A-Z]+$ 表示A-Z中任意一个大写字母至少出现1次
方括号[]中使用 ^ ,表示不希望出现字符,简称过滤字符,而且 ^ 必须用在[]中的第一位
^a[^0-9]%$ 表示 a 和 % 中间不能出现数字
1.7 小括号 () 的作用
1.7.1 限定量词作用的范围
^abc+$ ab 后面 跟着c至少出现一次^(abc)+$ abc整体至少出现一次
1.7.2 分支结构
^abc(123|bb)+$ abc 后面跟着 (123|bb)+^abc123|bb+$ abc123 或者 bb+
1.7.3 引用分组
这是括号一个重要的作用,有了它,我们就可以进行数据提取,以及更强大的替换操作。
而要使用它带来的好处,必须配合使用实现环境的API。
以日期为例。假设格式是yyyy-mm-dd的,我们可以先写一个简单的正则:
var regex = /d{4}-d{2}-d{2}/;//然后再修改成括号版的:var regex = /(d{4})-(d{2})-(d{2})/;
1.7.4提取数据
比如提取出年、月、日,可以这么做:var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";console.log( string.match(regex) ); // => ["2017-06-12", "2017", "06", "12", index: 0, input: "2017-06-12"]//match返回的一个数组,第一个元素是整体匹配结果,然后是各个分组(括号里)匹配的内容,然后是匹配下标,最后是输入的文本。(注意:如果正则是否有修饰符g,match返回的数组格式是不一样的)。//另外也可以使用正则对象的exec方法:var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";console.log( regex.exec(string) ); // => ["2017-06-12", "2017", "06", "12", index: 0, input: "2017-06-12"]//同时,也可以使用构造函数的全局属性$1至$9来获取:var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";regex.test(string); // 正则操作即可,例如//regex.exec(string);//string.match(regex);console.log(RegExp.$1); // "2017"console.log(RegExp.$2); // "06"console.log(RegExp.$3); // "12"
1.7.5替换
比如,想把yyyy-mm-dd格式,替换成mm/dd/yyyy怎么做?
var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";var result = string.replace(regex, "$2/$3/$1");console.log(result); // "06/12/2017"//其中replace中的,第二个参数里用$1、$2、$3指代相应的分组。等价于如下的形式:var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";var result = string.replace(regex, function() {return RegExp.$2 + "/" + RegExp.$3 + "/" + RegExp.$1;});console.log(result); // "06/12/2017"//也等价于:var regex = /(d{4})-(d{2})-(d{2})/;var string = "2017-06-12";var result = string.replace(regex, function(match, year, month, day) {return month + "/" + day + "/" + year;});console.log(result); // "06/12/2017"
1.7.6反向引用
除了使用相应API来引用分组,也可以在正则本身里引用分组。但只能引用之前出现的分组,即反向引用。还是以日期为例。
比如要写一个正则支持匹配如下三种格式:
2016-06-12
2016/06/12
2016.06.12
最先可能想到的正则是:
var regex = /d{4}(-|/|.)d{2}(-|/|.)d{2}/;var string1 = "2017-06-12";var string2 = "2017/06/12";var string3 = "2017.06.12";var string4 = "2016-06/12";console.log( regex.test(string1) ); // trueconsole.log( regex.test(string2) ); // trueconsole.log( regex.test(string3) ); // trueconsole.log( regex.test(string4) ); // true
其中/和.需要转义。虽然匹配了要求的情况,但也匹配"2016-06/12"这样的数据。
假设我们想要求分割符前后一致怎么办?此时需要使用反向引用:
var regex = /d{4}(-|/|.)d{2}1d{2}/;var string1 = "2017-06-12";var string2 = "2017/06/12";var string3 = "2017.06.12";var string4 = "2016-06/12";console.log( regex.test(string1) ); // trueconsole.log( regex.test(string2) ); // trueconsole.log( regex.test(string3) ); // trueconsole.log( regex.test(string4) ); // false
注意里面的1,表示的引用之前的那个分组(-|/|.)。不管它匹配到什么(比如-),1都匹配那个同样的具体某个字符。
我们知道了1的含义后,那么2和3的概念也就理解了,即分别指代第二个和第三个分组。
看到这里,此时,恐怕你会有三个问题。
括号嵌套怎么办?
以左括号(开括号)为准。比如:
var regex = /^((d)(d(d)))1234$/;var string = "1231231233";console.log( regex.test(string) ); // trueconsole.log( RegExp.$1 ); // 123console.log( RegExp.$2 ); // 1console.log( RegExp.$3 ); // 23console.log( RegExp.$4 ); // 3
我们可以看看这个正则匹配模式:
第一个字符是数字,比如说1,
第二个字符是数字,比如说2,
第三个字符是数字,比如说3,
接下来的是1,是第一个分组内容,那么看第一个开括号对应的分组是什么,是123,
接下来的是2,找到第2个开括号,对应的分组,匹配的内容是1,
接下来的是3,找到第3个开括号,对应的分组,匹配的内容是23,
最后的是4,找到第3个开括号,对应的分组,匹配的内容是3。
这个问题,估计仔细看一下,就该明白了。
10表示什么呢?
另外一个疑问可能是,即10是表示第10个分组,还是1和0呢?答案是前者,虽然一个正则里出现10比较罕见。测试如下:
var regex = /(1)(2)(3)(4)(5)(6)(7)(8)(9)(#) 10+/;var string = "123456789# ######"console.log( regex.test(string) );
引用不存在的分组会怎样?
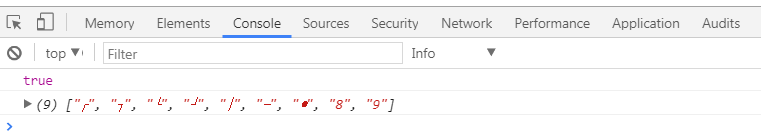
因为反向引用,是引用前面的分组,但我们在正则里引用了不存在的分组时,此时正则不会报错,只是匹配反向引用的字符本身。例如2,就匹配"2"。注意"2"表示对2进行了转意。
var regex = /123456789/;console.log( regex.test("123456789") ); console.log( "123456789".split("") );
chrome浏览器打印的结果:
1.7.7非捕获分组
之前文中出现的分组,都会捕获它们匹配到的数据,以便后续引用,因此也称他们是捕获型分组。
如果只想要括号最原始的功能,但不会引用它,即,既不在API里引用,也不在正则里反向引用。此时可以使用非捕获分组(?:p),例如本文第一个例子可以修改为:
var regex = /(?:ab)+/g;var string = "ababa abbb ababab";console.log( string.match(regex) ); // ["abab", "ab", "ababab"]
1.7.8 操作实例
字符串trim方法模拟
//trim方法是去掉字符串的开头和结尾的空白符。有两种思路去做。//第一种,匹配到开头和结尾的空白符,然后替换成空字符。如:function trim(str) {return str.replace(/^s+|s+$/g, '');}console.log( trim(" foobar ") ); // "foobar"//第二种,匹配整个字符串,然后用引用来提取出相应的数据:function trim(str) {return str.replace(/^s*(.*?)s*$/g, "$1");}console.log( trim(" foobar ") ); // "foobar"//这里使用了惰性匹配*?,不然也会匹配最后一个空格之前的所有空格的。//当然,前者效率高。
将每个单词的首字母转换为大写
function titleize(str) {return str.toLowerCase().replace(/(?:^|s)w/g, function(c) {return c.toUpperCase();});}console.log( titleize('my name is epeli') ); // "My Name Is Epeli"//思路是找到每个单词的首字母,当然这里不使用非捕获匹配也是可以的。
驼峰化
function camelize(str) {return str.replace(/[-_s]+(.)?/g, function(match, c) {return c ? c.toUpperCase() : '';});}console.log( camelize('-moz-transform') ); // MozTransform首字母不会转化为大写的。其中分组(.)表示首字母,单词的界定,前面的字符可以是多个连字符、下划线以及空白符。正则后面的?的目的,是为了应对str尾部的字符可能不是单词字符,比如str是'-moz-transform '。
中划线化
function dasherize(str) {return str.replace(/([A-Z])/g, '-$1').replace(/[-_s]+/g, '-').toLowerCase();}console.log( dasherize('MozTransform') ); // -moz-transform驼峰化的逆过程。
html转义和反转义
// 将HTML特殊字符转换成等值的实体function escapeHTML(str) {var escapeChars = { '¢' : 'cent', '£' : 'pound', '¥' : 'yen', '€': 'euro', '©' :'copy', '®' : 'reg', '<' : 'lt', '>' : 'gt', '"' : 'quot', '&' : 'amp', ''' : '#39'};return str.replace(new RegExp('[' + Object.keys(escapeChars).join('') +']', 'g'), function(match) {return '&' + escapeChars[match] + ';';});}console.log( escapeHTML('<div>Blah blah blah</div>') );// => <div>Blah blah blah</div>//其中使用了用构造函数生成的正则,然后替换相应的格式就行了,这个跟本文没多大关系。//倒是它的逆过程,使用了括号,以便提供引用,也很简单,如下:// 实体字符转换为等值的HTML。function unescapeHTML(str) {var htmlEntities = { nbsp: ' ', cent: '¢', pound: '£', yen: '¥', euro: '€', copy: '©', reg: '®', lt: '<', gt: '>', quot: '"', amp: '&', apos: '''};return str.replace(/&([^;]+);/g, function(match, key) {if (key in htmlEntities) {return htmlEntities[key];}return match;});}console.log( unescapeHTML('<div>Blah blah blah</div>') );// => <div>Blah blah blah</div>//通过key获取相应的分组引用,然后作为对象的键。
匹配成对标签
//要求匹配:<title>regular expression</title><p>laoyao bye bye</p>//不匹配:<title>wrong!</p>//匹配一个开标签,可以使用正则<[^>]+>,//匹配一个闭标签,可以使用</[^>]+>,//但是要求匹配成对标签,那就需要使用反向引用,如:var regex = /<([^>]+)>[dD]*</1>/;var string1 = "<title>regular expression</title>";var string2 = "<p>laoyao bye bye</p>";var string3 = "<title>wrong!</p>";console.log( regex.test(string1) ); // trueconsole.log( regex.test(string2) ); // trueconsole.log( regex.test(string3) ); // false//其中开标签<[^>]+>改成<([^>]+)>,使用括号的目的是为了后面使用反向引用,而提供分组。闭标签使用了反向引用,</1>。//另外[dD]的意思是,这个字符是数字或者不是数字,因此,也就是匹配任意字符的意思。
2. 常用的正则表达式
"^d+$" //非负整数(正整数 + 0)"^[0-9]*[1-9][0-9]*$" //正整数"^((-d+)|(0+))$" //非正整数(负整数 + 0)"^-[0-9]*[1-9][0-9]*$" //负整数"^-?d+$" //整数"^d+(.d+)?$" //非负浮点数(正浮点数 + 0)"^(([0-9]+.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*.[0-9]+)|([0-9]*[1-9][0-9]*))$" //正浮点数"^((-d+(.d+)?)|(0+(.0+)?))$" //非正浮点数(负浮点数 + 0)"^(-(([0-9]+.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*.[0-9]+)|([0-9]*[1-9][0-9]*)))$" //负浮点数"^(-?d+)(.d+)?$" //浮点数"^[A-Za-z]+$" //由26个英文字母组成的字符串"^[A-Z]+$" //由26个英文字母的大写组成的字符串"^[a-z]+$" //由26个英文字母的小写组成的字符串"^[A-Za-z0-9]+$" //由数字和26个英文字母组成的字符串"^w+$" //由数字、26个英文字母或者下划线组成的字符串"^[w-]+(.[w-]+)*@[w-]+(.[w-]+)+$" //email地址"^[a-zA-z]+://(w+(-w+)*)(.(w+(-w+)*))*(?S*)?$" //url/^(d{2}|d{4})-((0([1-9]{1}))|(1[1|2]))-(([0-2]([1-9]{1}))|(3[0|1]))$/ // 年-月-日/^((0([1-9]{1}))|(1[1|2]))/(([0-2]([1-9]{1}))|(3[0|1]))/(d{2}|d{4})$/ // 月/日/年"^([w-.]+)@(([[0-9]{1,3}.[0-9]{1,3}.[0-9]{1,3}.)|(([w-]+.)+))([a-zA-Z]{2,4}|[0-9]{1,3})(]?)$" //Emil"(d+-)?(d{4}-?d{7}|d{3}-?d{8}|^d{7,8})(-d+)?" //电话号码"^(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5])$" //IP地址^([0-9A-F]{2})(-[0-9A-F]{2}){5}$ //MAC地址的正则表达式^[-+]?d+(.d+)?$ //值类型正则表达式"^\d+$" //非负整数(正整数 + 0)"^[0-9]*[1-9][0-9]*$" //正整数"^((-\d+)|(0+))$" //非正整数(负整数 + 0)"^-[0-9]*[1-9][0-9]*$" //负整数"^-?\d+$" //整数"^\d+(\.\d+)?$" //非负浮点数(正浮点数 + 0)"^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$" //正浮点数"^((-\d+(\.\d+)?)|(0+(\.0+)?))$" //非正浮点数(负浮点数 + 0)"^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$" //负浮点数"^(-?\d+)(\.\d+)?$" //浮点数"^[A-Za-z]+$" //由26个英文字母组成的字符串"^[A-Z]+$" //由26个英文字母的大写组成的字符串"^[a-z]+$" //由26个英文字母的小写组成的字符串"^[A-Za-z0-9]+$" //由数字和26个英文字母组成的字符串"^\w+$" //由数字、26个英文字母或者下划线组成的字符串"^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$" //email地址"^[a-zA-z]+://(\w+(-\w+)*)(\.(\w+(-\w+)*))*(\?\S*)?$" //url
参考文档
https://www.**jb*51.net/article/73342.htm
https://zhuanlan.z**h*ihu.com/p/27355118
总结
到此这篇关于正则表达式的基本语法的文章就介绍到这了,更多相关正则表达式语法内容请搜索一聚教程网以前的文章或继续浏览下面的相关文章希望大家以后多多支持一聚教程网!
相关文章
- 正则表达式(?=)正向先行断言实战案例 09-29
- 正则表达式匹配010的正整数以及使用细节 09-29
- 正则表达式RegExp语法与用法详解 09-29
- 如何使用正则表达式对输入数字进行匹配详解 09-29
- 正则表达式的基本语法汇总篇(推荐!) 09-29
- 一文搞懂正则表达式基础语法以及如何应用 09-29